8.3 2^{k} 设计的四分之一分式
当因子个数中等偏大时, 设计的更小分式常常很有用。考虑 设计的四分之一分式(one-quarter fraction)。该设计包含 次试验,通常称为 分式因子设计。
设计可以这样构造:先写出由 个因子的完整因子设计的试验构成的基本设计,然后把另外两列与涉及前 个因子的适当交互作用对应起来。因此, 设计的四分之一分式有两个生成元。若用 和 表示所选的两个生成元,则 和 称为该设计的生成关系(generating relation)。 和 的符号( 或 )决定产生四个四分之一分式中的哪一个。与选择生成元 和 相联系的全部四个分式都属于同一族。其中 和 都取正号的那个分式是主分式。
该设计的完整定义关系由所有等于单位列 的列构成,包括 、 以及它们的广义交互作用 ;即定义关系为 。我们把定义关系中的元素 、 和 称为字(word)。任何效应的别名就是通过把该效应的列与定义关系中的每一个字相乘而得到的。显然,每个效应都有三个别名。试验者在选择生成元时应小心,以免潜在重要的效应之间互为别名。
作为一个例子,考虑 设计。假设我们选择 和 作为设计生成元。此时生成元 与 的广义交互作用为 ;因此该设计的完整定义关系为
表 8.8 满足 的 设计的别名结构
| 效应 | 别名 | 效应 | 别名 |
|---|---|---|---|
因此这是一个分辨度 IV 的设计。为求出任意效应(例如 )的别名,把该效应与定义关系中的每一个字相乘即可。对 得到
容易验证:每个主效应都与三因子和五因子交互作用互为别名,而两因子交互作用彼此互为别名并与更高阶交互作用互为别名。因此,例如当我们估计 时,实际上估计的是 。该设计的完整别名结构见表 8.8。如果三因子及更高阶交互作用可以忽略,该设计就能给出主效应的清晰估计。
为构造该设计,先写出基本设计,它由 、、、 的完整 设计的 16 次试验构成。然后通过把因子 和 的正负水平分别与交互作用 和 的正负号相对应来加入这两个因子。该过程见表 8.9。
构造该设计的另一个方法是:先求出 26 设计把 和 混杂掉的四个区组,然后选取在 和 上都取正号的那个区组。这样就得到一个生成关系为 和 的 分式因子设计;由于生成元 和 都取正号,它就是主分式。
当然,这个特定的 设计还有三个另类分式,分别为生成关系 与 、 与 、以及 与 的分式。这些分式都可以用表 8.9 所示的方法容易地构造出来。例如,若我们想求 与 的分式,则在表 8.9 的最后一列中令 ,因子 的水平列就变为
这个另类分式的完整定义关系为 。此时表 8.9 的别名结构中某些符号会发生改变;例如 的别名为 。因此,观测值的线性组合 实际上估计的是 。
最后请注意, 分式因子设计在任意四个因子的子集(只要该子集不是定义关系中的一个字)上都会投影为一个 24 设计的一次单独重复。它在任意四个因子的子集(该子集是定义关系中的一个字)上还会坍缩为 24 的一半分式的重复。因此,表 8.9 中的设计在因子 、 和 上变为 的两次重复,因为它们是定义关系中的字。六个因子还有 12 种其他组合(如 、),对这些组合该设计投影为 24 的一次单独重复。该设计在六个因子中任意三个因子的子集上还会坍缩为 23 的两次重复,在任意两个因子的子集上坍缩为 22 的四次重复。
表 8.9 生成元为 和 的 设计的构造
| 试验 | 基本设计 | |||||
|---|---|---|---|---|---|---|
| A | B | C | D | |||
| 1 | − | − | − | − | − | − |
| 2 | + | − | − | − | + | − |
| 3 | − | + | − | − | + | + |
| 4 | + | + | − | − | − | + |
| 5 | − | − | + | − | + | + |
| 6 | + | − | + | − | − | + |
| 7 | − | + | + | − | − | − |
| 8 | + | + | + | − | + | − |
| 9 | − | − | − | + | − | + |
| 10 | + | − | − | + | + | + |
| 11 | − | + | − | + | + | − |
| 12 | + | + | − | + | − | − |
| 13 | − | − | + | + | + | − |
| 14 | + | − | + | + | − | − |
| 15 | − | + | + | + | − | + |
| 16 | + | + | + | + | + | + |
一般地,任何 分式因子设计都可以在原来 个因子中某个满足 的 个因子的子集上坍缩为全因子设计或分式因子设计。那些构成全因子设计的变量子集不是完整定义关系中的字。
例 8.4
某注射成型过程制造的零件收缩过大,这给注射成型工艺下游的装配工序带来了问题。一个质量改进小组决定用设计好的试验来研究注射成型过程,以便降低收缩。该小组决定考察六个因子——模具温度()、螺杆转速()、保压时间()、周期时间()、浇口尺寸()和保压压力()——每个因子取两个水平,目标是了解每个因子如何影响收缩,同时也了解因子之间如何交互。
该小组决定使用表 8.9 中 16 次试验的二水平分式因子设计。该设计在表 8.10 中再次给出,同时给出了设计中 16 次试验各自所制试验零件上观测到的收缩值()。表 8.11 给出该试验的效应估计、平方和以及回归系数。
表 8.10 例 8.4 注射成型试验的 设计
| 试验 | 基本设计 | 观测收缩() | 处理组合 | |||||
|---|---|---|---|---|---|---|---|---|
| A | B | C | D | |||||
| 1 | − | − | − | − | − | − | 6 | |
| 2 | + | − | − | − | + | − | 10 | |
| 3 | − | + | − | − | + | + | 32 | |
| 4 | + | + | − | − | − | + | 60 | |
| 5 | − | − | + | − | + | + | 4 | |
| 6 | + | − | + | − | − | + | 15 | |
| 7 | − | + | + | − | − | − | 26 | |
| 8 | + | + | + | − | + | − | 60 | |
| 9 | − | − | − | + | − | + | 8 | |
| 10 | + | − | − | + | + | + | 12 | |
| 11 | − | + | − | + | + | − | 34 | |
| 12 | + | + | − | + | − | − | 60 | |
| 13 | − | − | + | + | + | − | 16 | |
| 14 | + | − | + | + | − | − | 5 | |
| 15 | − | + | + | + | − | + | 37 | |
| 16 | + | + | + | + | + | + | 52 |
表 8.11 例 8.4 的效应、平方和与回归系数
| 变量 | 名称 | −1 水平 | +1 水平 |
|---|---|---|---|
| A | Mold temperature(模具温度) | −1.000 | 1.000 |
| B | Screw speed(螺杆转速) | −1.000 | 1.000 |
| C | Holding time(保压时间) | −1.000 | 1.000 |
| D | Cycle time(周期时间) | −1.000 | 1.000 |
| E | Gate size(浇口尺寸) | −1.000 | 1.000 |
| F | Hold pressure(保压压力) | −1.000 | 1.000 |
| 变量 | 回归系数 | 效应估计 | 平方和 |
|---|---|---|---|
| 总平均 | 27.3125 | ||
| A | 6.9375 | 13.8750 | 770.062 |
| B | 17.8125 | 35.6250 | 5076.562 |
| C | −0.4375 | −0.8750 | 3.063 |
| D | 0.6875 | 1.3750 | 7.563 |
| E | 0.1875 | 0.3750 | 0.563 |
| F | 0.1875 | 0.3750 | 0.563 |
| 变量 | 回归系数 | 效应估计 | 平方和 |
|---|---|---|---|
| AB + CE | 5.9375 | 11.8750 | 564.063 |
| AC + BE | −0.8125 | −1.6250 | 10.562 |
| AD + EF | −2.6875 | −5.3750 | 115.562 |
| AE + BC + DF | −0.9375 | −1.8750 | 14.063 |
| AF + DE | 0.3125 | 0.6250 | 1.563 |
| BD + CF | −0.0625 | −0.1250 | 0.063 |
| BF + CD | −0.0625 | −0.1250 | 0.063 |
| ABD | 0.0625 | 0.1250 | 0.063 |
| ABF | −2.4375 | −4.8750 | 95.063 |
仅含主效应和两因子交互作用。
该试验效应估计的正态概率图如图 8.12 所示。只有 (模具温度)、(螺杆转速)以及 交互作用较大。鉴于表 8.8 中的别名关系,暂时采纳这些结论看来是合理的。图 8.13 中 交互作用的图表明:如果螺杆转速处于低水平,过程对温度非常不敏感;而如果螺杆转速处于高水平,过程对温度非常敏感。当螺杆转速处于低水平时,无论选择哪个温度水平,过程的平均收缩都约为 10%。
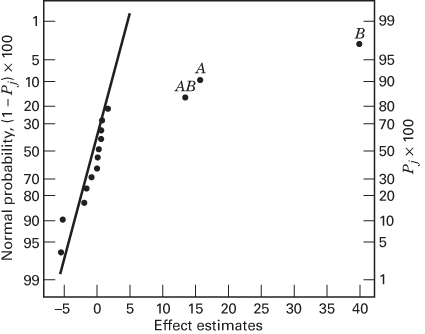
图 8.12 例 8.4 效应的正态概率图
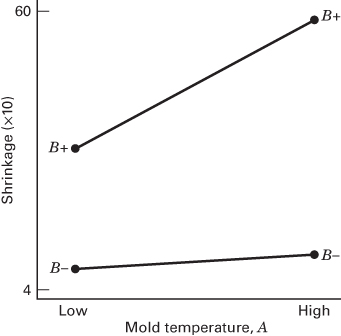
图 8.13 例 8.4 的 (模具温度-螺杆转速)交互作用图
基于这一初步分析,该小组决定把模具温度和螺杆转速都设在低水平。这组条件将把零件的平均收缩降到 10% 左右。然而,零件之间收缩的变异仍然是潜在的问题。实际上,通过上述修改可以充分降低平均收缩;但在一次生产过程中零件之间收缩的变异仍可能给装配带来问题。处理这个问题的一种办法是考察是否有某个过程因子影响零件收缩的变异。
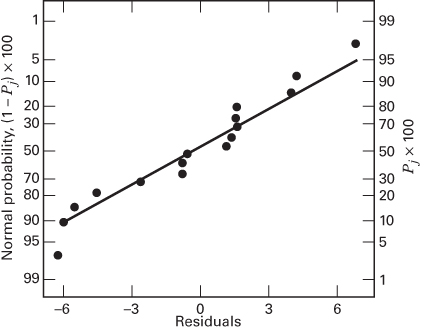
图 8.14 例 8.4 残差的正态概率图
图 8.14 给出残差的正态概率图。该图看来令人满意。随后我们构造了残差对每个因子的图,其中之一是残差对因子 (保压时间)的图,如图 8.15 所示。该图显示,保压时间处于低水平时的残差散布远小于保压时间处于高水平时。这些残差是按通常方式由预测收缩的模型得到的:
其中 、 和 是与因子 、 以及 交互作用相对应的编码变量。于是残差为
用来产生残差的这个回归模型实质上把 、 和 的位置效应(location effect)从数据中剔除了;因此残差中包含关于未解释变异的信息。图 8.15 表明变异中存在某种模式,而且当保压时间处于低水平时,零件收缩的变异可能更小。(请回忆第 6 章中的结论:只有在位置模型或均值模型正确时,残差才能传递关于离散度效应的信息。)
这一点由表 8.12 所示的残差分析进一步得到放大。在该表中,残差按每个因子的低水平 和高水平 排列,并计算了每个因子低水平与高水平下残差的标准差。注意, 处于低水平时残差的标准差 比 处于高水平时残差的标准差 小得多。
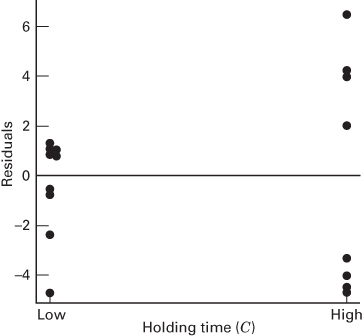
图 8.15 例 8.4 残差对保压时间()的图
表 8.12 例 8.4 离散度效应的计算[1]
| 试验 | A | B | AB = CE | C | AC = BE | AE = BC = DF | E | D | AD = EF | BD = CF | ABD | BF = CD | ACD | F | AF = DE | 残差 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | − | − | + | − | + | + | − | − | + | + | − | + | − | − | + | −2.50 |
| 2 | + | − | − | − | − | + | + | − | − | + | + | + | + | − | − | −0.50 |
| 3 | − | + | − | − | + | − | + | − | + | − | + | + | − | + | − | −0.25 |
| 4 | + | + | + | − | − | − | − | − | − | − | − | + | + | + | + | 2.00 |
| 5 | − | − | + | + | − | − | + | − | + | + | − | − | + | + | − | −4.50 |
| 6 | + | − | − | + | + | − | − | − | − | + | + | − | − | + | + | 4.50 |
| 7 | − | + | − | + | − | + | − | − | + | − | + | − | + | − | + | −6.25 |
| 8 | + | + | + | + | + | + | + | − | − | − | − | − | − | − | − | 2.00 |
| 9 | − | − | + | − | + | + | − | + | − | − | + | − | + | + | − | −0.50 |
| 10 | + | − | − | − | − | + | + | + | + | − | − | − | − | + | + | 1.50 |
| 11 | − | + | − | − | + | − | + | + | − | + | − | − | + | − | + | 1.75 |
| 12 | + | + | + | − | − | − | − | + | + | + | + | − | − | − | − | 2.00 |
| 13 | − | − | + | + | − | − | + | + | − | − | + | + | − | − | + | 7.50 |
| 14 | + | − | − | + | + | − | − | + | + | − | − | + | + | − | − | −5.50 |
| 15 | − | + | − | + | − | + | − | + | − | + | − | + | − | + | − | 4.75 |
| 16 | + | + | + | + | + | + | + | + | + | + | + | + | + | + | + | −6.00 |
| 3.80 | 4.01 | 4.33 | 5.70 | 3.68 | 3.85 | 4.17 | 4.64 | 3.39 | 4.01 | 4.72 | 4.71 | 3.50 | 3.88 | 4.87 | ||
| 4.60 | 4.41 | 4.10 | 1.63 | 4.53 | 4.33 | 4.25 | 3.59 | 2.75 | 4.41 | 3.64 | 3.65 | 3.12 | 4.52 | 3.40 | ||
| −0.38 | −0.19 | 0.11 | 2.50 | −0.42 | −0.23 | −0.04 | 0.51 | 0.42 | −0.19 | 0.52 | 0.51 | 0.23 | −0.31 | 0.72 |
表 8.12 的最后一行给出统计量
回忆一下:如果因子 的高水平 与低水平 下残差的方差相等,则该比值近似服从均值为零的正态分布,因而可以用它来判断因子 两个水平上响应变异的差异。由于比值 相对较大,我们可以断定图 8.15 中观察到的表观离散度(或变异)效应是真实的。因此,把保压时间设在其低水平将有助于降低一次生产过程中零件之间收缩的变异。图 8.16 给出表 8.12 中 值的正态概率图,它也表明因子 有很大的离散度效应。
图 8.17 把该试验的数据投影到因子 、 和 的立方体上,立方体的每个角上给出观测收缩的平均值和极差。从图中可以看出,让过程在螺杆转速()处于低水平下运行是降低零件平均收缩的关键。如果 处于低水平,几乎温度()和保压时间()的任何组合都会导致零件平均收缩较低。不过,考察立方体各角上收缩值的极差就立刻清楚:如果希望在一次生产过程中保持零件之间收缩的变异较低,把保压时间()设在低水平是唯一合理的选择。
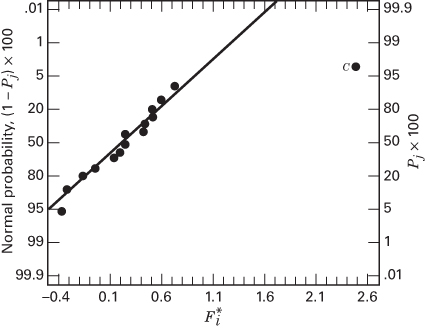
图 8.16 例 8.4 离散度效应 的正态概率图
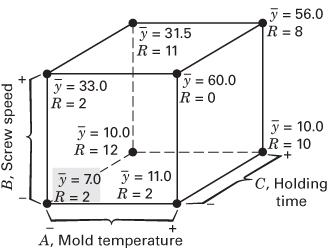
图 8.17 例 8.4 因子 、、 的平均收缩与收缩极差
原书表题为 Calculation of Dispersion Effects for Example 8.4。扫描件里只剩其中三行汇总值(无表题、无列标题、无各次试验的符号行),这里按原表恢复为完整表格:符号行由表 8.10 的因子水平相乘得到,残差由 算得,两者均与书中数值相符;三行汇总值仍用书中的原值(由符号行与残差独立复算,45 个数值中 42 个完全相同,其余相差不超过 0.01)。第 10 列的表头依 写作 BD = CF;第 13 列的 与表 8.11 末行的 是同一条别名链()。