8.2 2^{k} 设计的一半分式
8.2.1 定义与基本原理
考虑这样一种情形:有三个因子,每个因子取两个水平,试验者感兴趣,但无法负担全部 个处理组合的试验费用,不过可以做四次试验。这就提示我们采用 23 设计的一半分式。由于该设计只含 个处理组合,23 设计的一半分式常称为 设计。
23 设计的正负号表见表 8.1。假设我们选取四个处理组合 、、 和 作为一半分式。这些试验见表 8.1 的上半部分以及图 8.1a。
注意, 设计是通过只选取 列中取正号的那些处理组合而形成的。因此, 称为该特定分式的生成元(generator)。通常我们把 这样的生成元称为一个字(word)。此外,单位列 也总是取正号,所以我们称
为该设计的定义关系(defining relation)。一般地,分式因子设计的定义关系总是等于单位列 的所有列构成的集合。
设计中的处理组合给出三个自由度,可用来估计主效应。参考表 8.1,我们注意到用来估计 、 和 主效应的观测值线性组合为
其中记号 、 和 用来表示与主效应相联系的线性组合。同样容易验证,用来估计两因子交互作用的观测值线性组合为
表 8.1 23 因子设计的正负号
| 处理组合 | I | A | B | C | AB | AC | BC | ABC |
|---|---|---|---|---|---|---|---|---|
| + | + | − | − | − | − | + | + | |
| + | − | + | − | − | + | − | + | |
| + | − | − | + | + | − | − | + | |
| + | + | + | + | + | + | + | + | |
| + | + | + | − | + | − | − | − | |
| + | + | − | + | − | + | − | − | |
| + | − | + | + | − | − | + | − | |
| + | − | − | − | + | + | + | − |
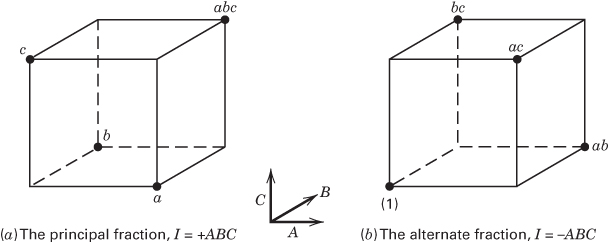
图 8.1 23 设计的两个一半分式
因此 、、;可见不可能区分 与 、 与 、 与 。事实上,当我们估计 、 和 时,实际上估计的是 、 和 。具有这种性质的两个或多个效应称为别名(alias)。在本例中, 与 互为别名, 与 互为别名, 与 互为别名。我们用记号 、、 来表示这一点。
该设计的别名结构可以借助定义关系 很容易地确定。把任意一列(或效应)乘以定义关系,就得到该列(或效应)的别名。在本例中,由此得到 的别名为
又由于任意一列的平方就是单位 ,所以
类似地,可求得 和 的别名为
以及
这个满足 的一半分式通常称为主分式(principal fraction)。
现在假设我们选取的是另一半分式,即表 8.1 中在 列取负号的那些处理组合。这个另类的(或称互补的)一半分式(由试验 、、 和 组成)如图 8.1b 所示。该设计的定义关系为
由这个另半分式得到的观测值线性组合,记为 、 和 ,给出
因此,用这个特定的分式估计 、 和 时,我们实际上估计的是 、 和 。
实践中,究竟使用哪一个分式并不重要。两个分式属于同一族;也就是说,这两个一半分式合起来构成一个完整的 23 设计。参照图 8.1 的 (a)、(b) 两部分就容易看出这一点。
假设在完成 23 设计的两个一半分式之一以后,又完成了另一个分式。于是,与完整 23 相联系的八次试验现在都可得。此时我们可以把八次试验作为一个分成两个区组(每组四次试验)的完整 23 设计来分析,从而获得所有效应的去别名(de-aliased)估计。这也可以通过对两个单独分式的线性组合做加、减来实现。例如,考虑 与 ,这意味着
以及
因此,对全部三对线性组合,我们会得到如下结果:
| 由 | 由 | |
|---|---|---|
| A | A | BC |
| B | B | AC |
| C | C | AB |
此外,按这种方式把完整的 23 组合起来——第一组试验取 ,第二组取 ——就得到把 混杂在区组中的 23 设计。
关于效应稀疏的更多讨论。 如前所述,效应稀疏是分式因子设计如此成功的原因之一。几十年来,许多领域的试验者都在经验上观察到这一现象。不过,Li、Sudarsanam 和 Frey(2006)的一篇近期论文为效应稀疏提供了更客观的证据。
Li、Sudarsanam 和 Frey(2006)重新考察了已发表的、含 3 到 7 个因子的全因子试验中的 133 个响应变量。他们对所有这些响应都重新作了分析。他们发现在所研究的试验中,41% 的主效应是活跃的。一般地,一个活跃主效应的大小是一个活跃两因子交互作用大小的两倍。总体上,活跃两因子交互作用的比例为 11%。二阶以上的交互作用极为罕见。他们还报告了关于活跃两因子交互作用的一些"条件"百分比:
在两因子交互作用活跃、且该交互作用涉及的两个主效应都活跃的情形,占 33%。
在两因子交互作用活跃、但该交互作用涉及的两个主效应中只有一个活跃的情形,占 4.5%。
在两因子交互作用活跃、且该交互作用涉及的两个主效应都不活跃的情形,仅占 0.5%。
这些结果有力地支持了效应稀疏性假定,也支持通常的模型层次性和效应遗传性假定。不过,这些结果强烈依赖于所分析的试验类型。如果把更多涉及化学过程与系统以及生物系统的试验纳入进来,两因子交互作用出现的可能性大概会更高。在这些系统中的某些情况下还会遇到三因子交互作用。例如,考虑一个三因子化学过程试验,涉及两个连续因子——时间和温度——以及一个分类因子——催化剂类型。如果涉及时间和温度的交互作用对每种催化剂类型都不相同,那么就存在三因子交互作用。
8.2.2 设计分辨度
前面那个 设计称为分辨度 III 的设计。在这类设计中,主效应与两因子交互作用互为别名。若没有一个 因子效应与任何含少于 个因子的效应互为别名,则称该设计的分辨度为 。我们通常用罗马数字下标来表示设计分辨度;因此,定义关系为 (或 )的 23 设计的一半分式是一个 设计。
分辨度为 III、IV 和 V 的设计特别重要。这些设计的定义以及各自的例子如下:
分辨度 III 设计。 在这类设计中,没有主效应与任何其他主效应互为别名,但主效应与两因子交互作用互为别名,并且某些两因子交互作用之间也可能互为别名。表 8.1 中的 设计就是分辨度 III 的()。
分辨度 IV 设计。 在这类设计中,没有主效应与任何其他主效应或任何两因子交互作用互为别名,但两因子交互作用之间互为别名。满足 的 设计就是分辨度 IV 的设计()。
分辨度 V 设计。 在这类设计中,没有主效应或两因子交互作用与任何其他主效应或两因子交互作用互为别名,但两因子交互作用与三因子交互作用互为别名。满足 的 设计就是分辨度 V 的设计()。
一般地,二水平分式因子设计的分辨度等于定义关系中最短的字所含字母的个数。因此,我们可以把上述几类设计分别称为三字母、四字母和五字母设计。我们通常喜欢采用在满足所需分式程度的前提下分辨度尽可能高的分式设计。分辨度越高,为了对结果作出唯一解释而需要假定哪些交互作用可以忽略的限制就越少。
8.2.3 一半分式的构造与分析
最高分辨度的 设计的一半分式可以这样构造:先写出由完整 因子设计的试验构成的基本设计,然后通过把第 个因子的正负水平与最高阶交互作用 的正负号相对应,加入第 个因子。因此, 分式因子设计就是先写出完整 22 因子设计作为基本设计,再令因子 等于 交互作用而得到的。令因子 等于 交互作用则得到另一个分式。这种做法见表 8.2。注意基本设计总是具有正确的试验次数(行数),但缺少一列。然后由生成元 解出所缺的那一列(),即 确定了每一行中用来产生第 个因子水平的正负号乘积。
注意,任何交互作用效应都可以用来生成第 个因子的那一列。不过,使用 以外的任何效应都不会产生分辨度尽可能高的设计。
看待一半分式构造方式的另一个角度是:把试验分成两个区组,把最高阶交互作用 混杂掉。每个区组就是一个最高分辨度的 分式因子设计。
表 8.2 23 设计的两个一半分式
| 试验 | 完整 22 因子设计(基本设计) | , | , | |||||
|---|---|---|---|---|---|---|---|---|
| A | B | A | B | C = AB | A | B | C = −AB | |
| 1 | − | − | − | − | + | − | − | − |
| 2 | + | − | + | − | − | + | − | + |
| 3 | − | + | − | + | − | − | + | + |
| 4 | + | + | + | + | + | + | + | − |
分式到因子设计的投影。 任何分辨度为 的分式因子设计,在任意 个因子的子集中都包含完整的因子设计(可能是重复的因子设计)。这是一个重要而有用的概念。例如,如果试验者有几个潜在感兴趣的因子,但相信其中只有 个具有重要效应,那么分辨度为 的分式因子设计就是恰当的设计选择。如果试验者判断正确,分辨度为 的分式因子设计将投影为这 个显著因子的全因子设计。图 8.2 对 设计说明了这一性质:它在任意两个因子的子集中都投影为一个 22 设计。
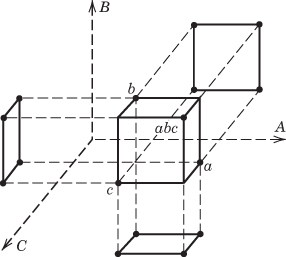
图 8.2 设计投影为三个 22 设计
由于 设计的一半分式可能达到的最大分辨度为 ,所以每个 设计都会投影为原来 个因子中任意 个因子的全因子设计。此外, 设计在任意 个因子的子集中可以投影为全因子设计的两次重复,在任意 个因子的子集中可以投影为四次重复,依此类推。
例 8.1
考虑例 6.2 中的过滤速率试验。表 6.10 所示的原始设计是 24 设计的一次单独重复。在那个例子中,我们发现主效应 、、 以及交互作用 和 不为零。现在我们回到这个试验,模拟一下如果当时做的不是全因子设计,而是 24 设计的一半分式,结果会怎样。
我们将采用 的 设计,因为这样选择生成元可以得到分辨度尽可能高(IV)的设计。为构造该设计,先写出基本设计,它是一个 23 设计,如表 8.3 的前三列所示。该基本设计具有所需的试验次数(八次),但只有三列(因子)。为求出第四个因子的水平,由 解出 ,即 。因此,每次试验中 的水平就是 、 和 三列正负号的乘积。该过程见表 8.3。由于生成元 取正号,这个 设计是主分式。该设计如图 8.3 所示。
表 8.3 定义关系为 的 设计
| 试验 | 基本设计 | 处理组合 | 过滤速率 | |||
|---|---|---|---|---|---|---|
| A | B | C | ||||
| 1 | − | − | − | − | 45 | |
| 2 | + | − | − | + | 100 | |
| 3 | − | + | − | + | 45 | |
| 4 | + | + | − | − | 65 | |
| 5 | − | − | + | + | 75 | |
| 6 | + | − | + | − | 60 | |
| 7 | − | + | + | − | 80 | |
| 8 | + | + | + | + | 96 |
利用定义关系,我们注意到每个主效应都与一个三因子交互作用互为别名,即 、、、。此外,每个两因子交互作用都与另一个两因子交互作用互为别名。这些别名关系为 、、。四个主效应加上三对两因子交互作用别名,正好构成该设计的七个自由度。
此时,我们通常会把这八次试验随机化并实施试验。由于我们已经做过完整的 24 设计,所以我们只需从例 6.2 中选取与 设计各次试验相对应的八个观测过滤速率即可。这些观测值见表 8.3 的最后一列,也见图 8.3。
由这个 设计得到的效应估计见表 8.4。为说明计算过程,与 效应相联系的观测值线性组合为
而 效应则为
从表 8.4 中的信息来看,得出主效应 、 和 较大的结论并非没有道理。 别名链的估计值很小,所以最简单的解释是 和 两个交互作用都可以忽略(否则 和 都很大,但大小几乎相同而符号相反——这相当不可能)。此外,如果 、 和 是重要的主效应,那么可以顺理成章地推断:两条交互作用别名链 和 效应较大是因为 和 交互作用也显著。换句话说,如果 、 和 显著,那么显著的交互作用最可能是 和 。这是奥卡姆剃刀(Ockham’s razor,得名于奥卡姆的威廉)的一个应用:当面对某一现象的几种不同可能解释时,最简单的解释通常才是正确的。注意,这一解释与例 6.2 中分析完整 24 设计所得的结论一致。
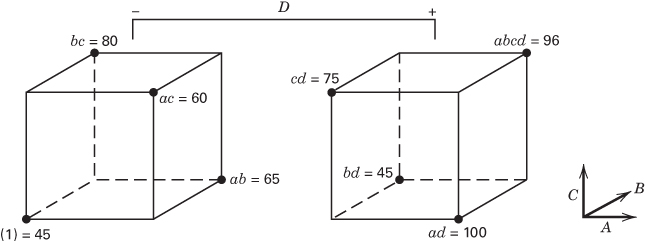
图 8.3 例 8.1 中过滤速率试验的 设计
表 8.4 例 8.1 的效应估计与别名
| 估计 | 别名结构 |
|---|---|
显著效应以粗体显示。
看这一解释的另一个角度是效应遗传性。假设 显著,且主效应 和 都显著。这称为强遗传性(strong heredity),也是通常的情形(若交互作用显著而其中只有一个主效应显著,则称为弱遗传性(weak heredity),这种情况相对较少见)。所以在本例中, 显著而 不显著,这支持了 不显著的假定。
由于因子 不显著,我们可以把它从考虑中剔除。于是,可以把该 设计投影为因子 、 和 的 23 设计的一次单独重复,如图 8.4 所示。对这一立方体图作直观考察,会让我们对上述结论更有信心。注意,如果温度()处于低水平,则浓度()有很大的正效应;而如果温度处于高水平,则浓度的影响非常小。这很可能是由 交互作用造成的。此外,如果温度处于低水平,搅拌速率()的影响可以忽略;而如果温度处于高水平,搅拌速率有很大的正效应。这很可能是前面初步识别出的 交互作用造成的。
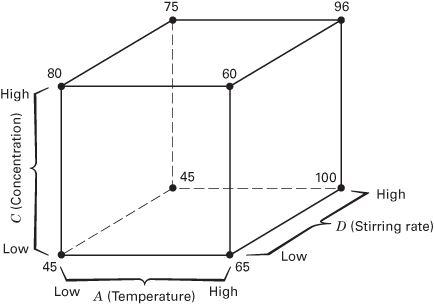
图 8.4 例 8.1 中 设计投影为 、 和 的 23 设计
基于上述分析,现在我们可以得到在试验区域内预测过滤速率的模型。该模型为
其中 、 和 是表示 、 和 的编码变量(), 是回归系数,可以像前面那样由效应估计求得。因此,预测方程为
记住,截距 是设计八次试验上全部响应的平均值。该模型与例 6.2 中完整 因子设计所得的模型非常相似。
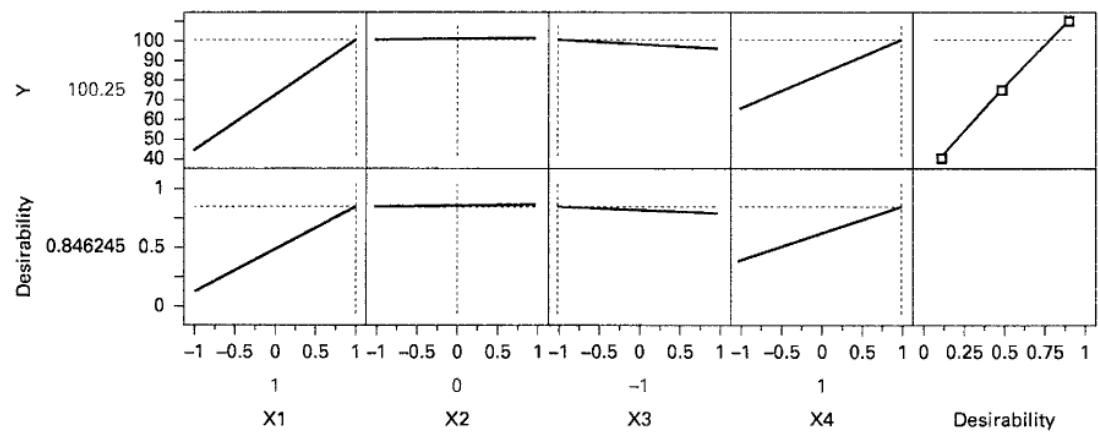
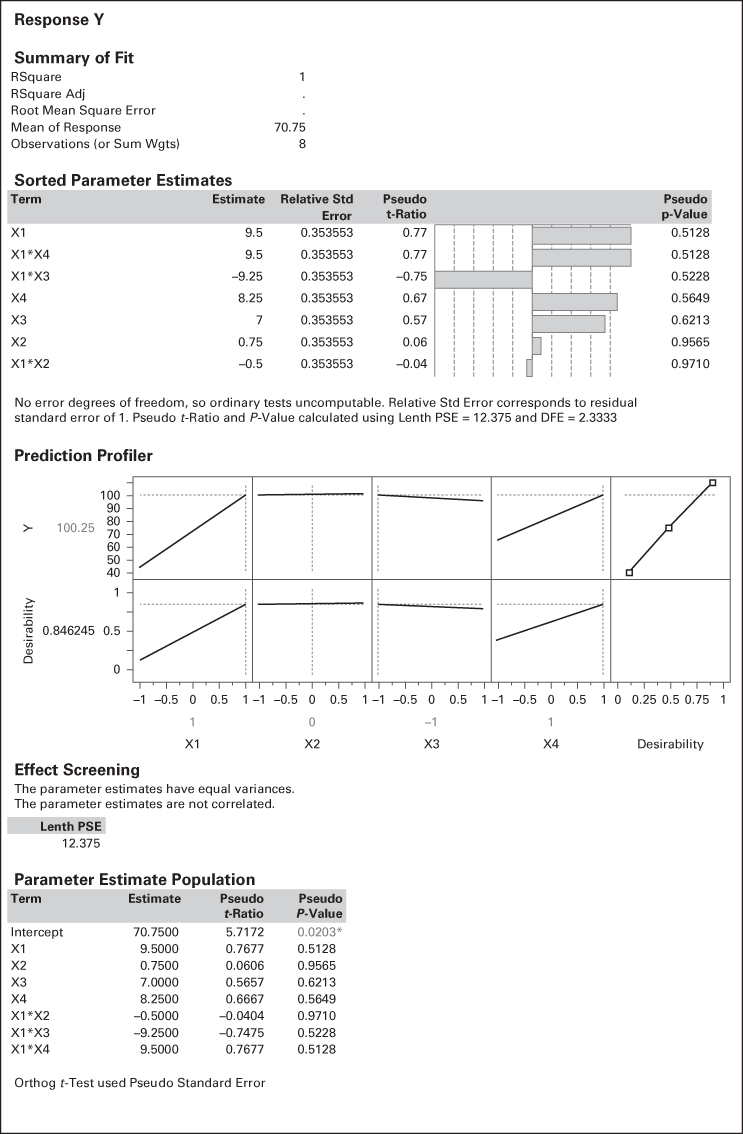
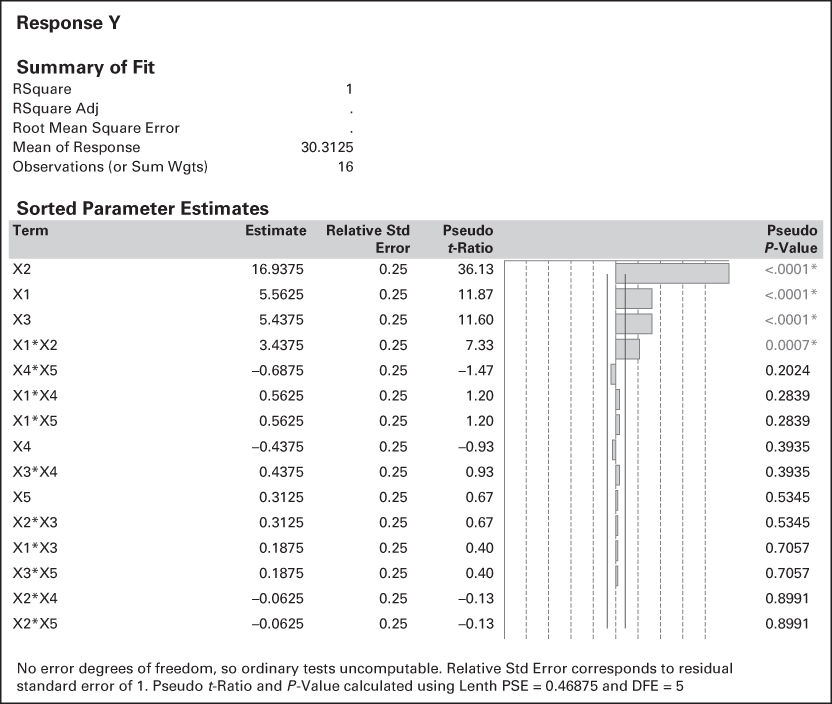
例 8.1 的 JMP 筛选分析见下面的方框显示。由于只有八次试验和七个自由度,我们在模型中只纳入截距、四个主效应以及六个两因子交互作用中的三个(及其别名)。由 Lenth 方法得到的所有 值都很大。八次试验、五个活跃效应,不足以由 Lenth 方法给出可靠的误差估计。另外请注意, 统计量为 1,而且由于模型是饱和的,未报告调整 和均方误差的平方根的值。不过,最大的效应正是例 8.1 中前面识别出的三个主效应和两个两因子交互作用。输出中的预测刻画器(prediction profiler)部分已设定为使过滤速率最大的活跃因子水平。
Prediction Profiler
| Response Y | |
|---|---|
| Summary of Fit | |
| RSquare | 1 |
| RSquare Adj | . |
| Root Mean Square Error | . |
| Mean of Response | 70.75 |
| Observations (or Sum Wgts) | 8 |
Sorted Parameter Estimates
| Term | Estimate | Relative Std Error | Pseudo t-Ratio | Pseudo p-Value |
|---|---|---|---|---|
| X1 | 9.5 | 0.353553 | 0.77 | 0.5128 |
| X1*X4 | 9.5 | 0.353553 | 0.77 | 0.5128 |
| X1*X3 | −9.25 | 0.353553 | −0.75 | 0.5228 |
| X4 | 8.25 | 0.353553 | 0.67 | 0.5649 |
| X3 | 7 | 0.353553 | 0.57 | 0.6213 |
| X2 | 0.75 | 0.353553 | 0.06 | 0.9565 |
| X1*X2 | −0.5 | 0.353553 | −0.04 | 0.9710 |
No error degrees of freedom, so ordinary tests uncomputable. Relative Std Error corresponds to residual standard error of 1. Pseudo t-Ratio and -Value calculated using Lenth PSE = 12.375 and DFE = 2.3333
Parameter Estimate Population
| Term | Estimate | Pseudo t-Ratio | Pseudo P-Value |
|---|---|---|---|
| Intercept | 70.7500 | 5.7172 | 0.0203* |
| X1 | 9.5000 | 0.7677 | 0.5128 |
| X2 | 0.7500 | 0.0606 | 0.9565 |
| X3 | 7.0000 | 0.5657 | 0.6213 |
| X4 | 8.2500 | 0.6667 | 0.5649 |
| X1*X2 | −0.5000 | −0.0404 | 0.9710 |
| X1*X3 | −9.2500 | −0.7475 | 0.5228 |
| X1*X4 | 9.5000 | 0.7677 | 0.5128 |
Orthog t-Test used Pseudo Standard Error
例 8.2 用于过程改进的 设计
在一个集成电路制造过程中,用 设计研究了五个因子,目标是改进过程产率。这五个因子是 = 口径设置(小、大), = 曝光时间(比标称值低 20%、比标称值高 20%), = 显影时间(30 秒和 45 秒), = 掩模尺寸(小、大), = 刻蚀时间(14.5 分钟和 15.5 分钟)。 设计的构造见表 8.5。注意,该设计的构造方法是:先写出含 16 次试验的基本设计(、、、 的 24 设计),选取 作为生成元,然后令第五个因子 的水平。图 8.5 给出了该设计的图示。
该设计的定义关系为 。因此,每个主效应都与一个四因子交互作用互为别名(例如 ),每个两因子交互作用都与一个三因子交互作用互为别名(例如 )。所以该设计是分辨度 V 的。我们可以预期这个 设计能提供关于主效应和两因子交互作用的极好信息。
表 8.6 给出该试验 15 个效应的效应估计、平方和以及模型回归系数。图 8.6 给出了该试验效应估计的正态概率图。主效应 、、 以及 交互作用较大。记住,由于存在别名,这些效应实际上是 、、 和 。不过,由于三因子及更高阶交互作用可以忽略似乎是合理的,我们可以放心地得出只有 、、 和 是重要效应的结论。
表 8.5 例 8.2 的 设计
| 试验 | 基本设计 | 处理组合 | 产率 | ||||
|---|---|---|---|---|---|---|---|
| A | B | C | D | ||||
| 1 | − | − | − | − | + | 8 | |
| 2 | + | − | − | − | − | 9 | |
| 3 | − | + | − | − | − | 34 | |
| 4 | + | + | − | − | + | 52 | |
| 5 | − | − | + | − | − | 16 | |
| 6 | + | − | + | − | + | 22 | |
| 7 | − | + | + | − | + | 45 | |
| 8 | + | + | + | − | − | 60 | |
| 9 | − | − | − | + | − | 6 | |
| 10 | + | − | − | + | + | 10 | |
| 11 | − | + | − | + | + | 30 | |
| 12 | + | + | − | + | − | 50 | |
| 13 | − | − | + | + | + | 15 | |
| 14 | + | − | + | + | − | 21 | |
| 15 | − | + | + | + | − | 44 | |
| 16 | + | + | + | + | + | 63 |
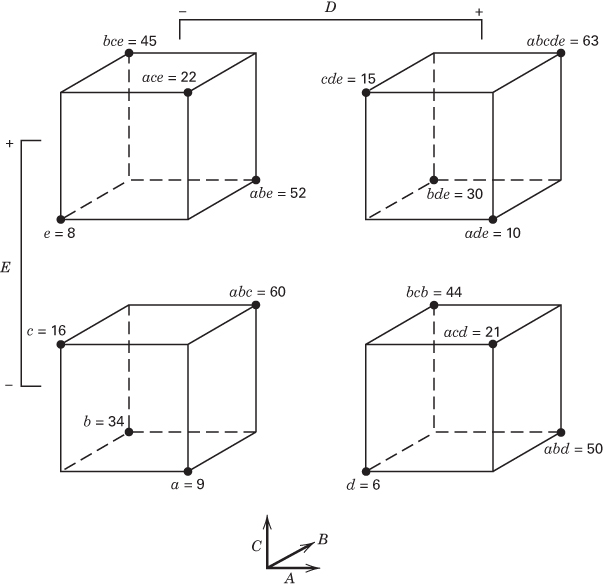
图 8.5 例 8.2 的 设计
表 8.6 例 8.2 的效应、回归系数与平方和
| 变量 | 名称 | −1 水平 | +1 水平 |
|---|---|---|---|
| A | Aperture(口径) | 小 | 大 |
| B | Exposure time(曝光时间) | −20% | +20% |
| C | Develop time(显影时间) | 30 秒 | 40 秒 |
| D | Mask dimension(掩模尺寸) | 小 | 大 |
| E | Etch time(刻蚀时间) | 14.5 分钟 | 15.5 分钟 |
| 变量 | 回归系数 | 效应估计 | 平方和 |
|---|---|---|---|
| 总平均 | 30.3125 | ||
| A | 5.5625 | 11.1250 | 495.062 |
| B | 16.9375 | 33.8750 | 4590.062 |
| C | 5.4375 | 10.8750 | 473.062 |
| D | −0.4375 | −0.8750 | 3.063 |
| E | 0.3125 | 0.6250 | 1.563 |
| AB | 3.4375 | 6.8750 | 189.063 |
| 变量 | 回归系数 | 效应估计 | 平方和 |
|---|---|---|---|
| AC | 0.1875 | 0.3750 | 0.563 |
| AD | 0.5625 | 1.1250 | 5.063 |
| AE | 0.5625 | 1.1250 | 5.063 |
| BC | 0.3125 | 0.6250 | 1.563 |
| BD | −0.0625 | −0.1250 | 0.063 |
| BE | −0.0625 | −0.1250 | 0.063 |
| CD | 0.4375 | 0.8750 | 3.063 |
| CE | 0.1875 | 0.3750 | 0.563 |
| DE | −0.6875 | −1.3750 | 7.563 |
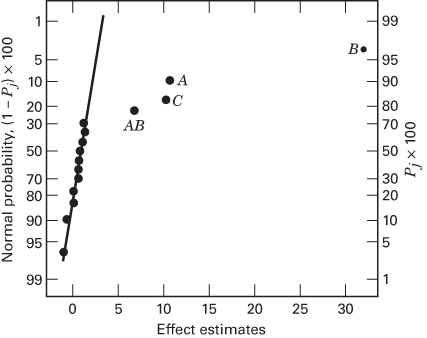
图 8.6 例 8.2 效应的正态概率图
表 8.7 汇总了该试验的方差分析。模型平方和为 ,它解释了产率总变异的 99% 以上。图 8.7 给出残差的正态概率图,图 8.8 是残差对预测值的图。两图都令人满意。
三个因子 、 和 有很大的正效应。(即口径-曝光时间)交互作用如图 8.9 所示。该图证实:当 和 都处于高水平时产率更高。
设计会坍缩为原来五个因子中任意三个因子的 23 设计的两次重复。(参考图 8.5 有助于你直观地理解这一点。)图 8.10 是因子 、 和 的立方体图,八个角上标有平均产率。从立方体图可以清楚地看出,当 、 和 都处于高水平时产率最高。因子 和 对平均过程产率几乎没有影响,可以把它们设置到能使其他目标(如成本)最优的取值上。
表 8.7 例 8.2 的方差分析
| 变异来源 | 平方和 | 自由度 | 均方 | 值 | |
|---|---|---|---|---|---|
| A(口径) | 495.0625 | 1 | 495.0625 | 193.20 | <0.0001 |
| B(曝光时间) | 4590.0625 | 1 | 4590.0625 | 1791.24 | <0.0001 |
| C(显影时间) | 473.0625 | 1 | 473.0625 | 184.61 | <0.0001 |
| AB | 189.0625 | 1 | 189.0625 | 73.78 | <0.0001 |
| 误差 | 28.1875 | 11 | 2.5625 | ||
| 总计 | 5775.4375 | 15 |
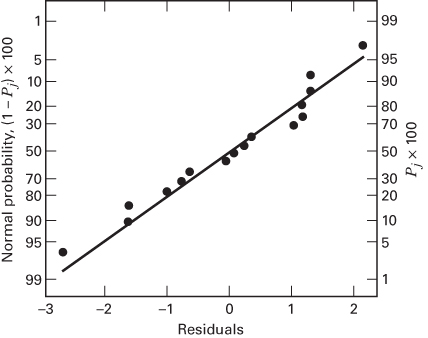
图 8.7 例 8.2 残差的正态概率图
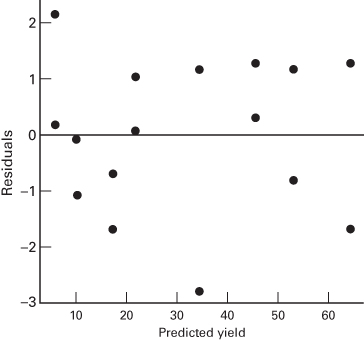
图 8.8 例 8.2 残差对预测产率的图
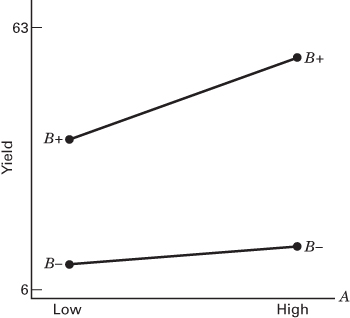
图 8.9 例 8.2 的口径-曝光时间交互作用
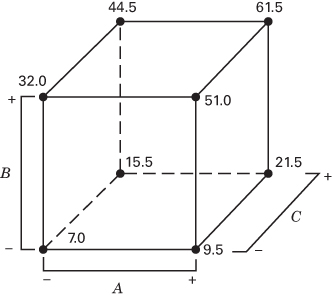
图 8.10 例 8.2 中 设计投影为因子 、、 的 23 设计的两次重复
JMP 筛选分析的输出见下面的显示。JMP 筛选平台用 Lenth 方法确定活跃效应。其结果与例 8.2 所用的效应正态概率图方法一致。由于当模型中包含全部主效应和两因子交互作用时设计是饱和的,没有可用于估计误差的自由度。因此 ,而调整 和均方误差的平方根都无法计算。
分式因子设计的序列。 使用分式因子设计常常能在试验中带来很大的经济性和效率,特别是当试验可以序贯进行时。例如,假设我们正在研究 个因子( 次试验)。几乎总是更可取的做法是:先运行一个 分式设计(八次试验),分析结果,然后决定下一步最好做哪一组试验。如果需要消除歧义,我们总可以再运行另一个分式,从而完成 24 设计。用这种方法完成设计时,两个一半分式代表完整设计的两个区组,最高阶交互作用与区组混杂(这里混杂的是 )。因此,序贯试验的结果只损失最高阶交互作用上的信息。它的好处是:在许多情况下,我们从一半分式中学到的东西已足以进入下一个试验阶段,这可能涉及增加或剔除因子、改变响应,或者在新的范围内变动某些因子。图 8.11 用图形说明了其中一些可能性。
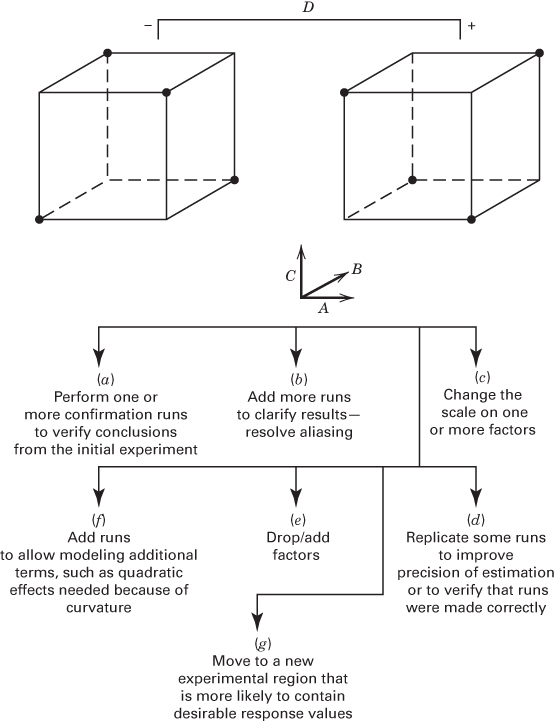
图 8.11 初始分式因子试验之后可供后续试验的几种可能
例 8.3
重新考虑例 8.1 中的试验。我们使用了一个 设计,并初步识别出三个较大的主效应——、 和 。还有两个与两因子交互作用相联系的大效应,即 与 。在例 8.2 中,我们利用主效应 可忽略这一事实,初步断定重要的交互作用是 和 。有时试验者拥有过程知识,可以帮助区分哪些交互作用可能重要。不过,我们总可以通过运行由 给出的另一个分式来把显著的交互作用分离出来。容易证明,该设计及其响应如下:
| 试验 | 基本设计 | 处理组合 | 过滤速率 | |||
|---|---|---|---|---|---|---|
| A | B | C | ||||
| 1 | − | − | − | + | 43 | |
| 2 | + | − | − | − | 71 | |
| 3 | − | + | − | − | 48 | |
| 4 | + | + | − | + | 104 | |
| 5 | − | − | + | − | 68 | |
| 6 | + | − | + | + | 86 | |
| 7 | − | + | + | + | 70 | |
| 8 | + | + | + | − | 65 |
由这个另半分式得到的效应估计(及其别名)为
这些估计可以与原来一半分式所得的估计合并,得到如下效应估计:
| 由 | 由 | |
|---|---|---|
| A | 21.63 → A | −2.63 → BCD |
| B | 3.13 → B | −1.63 → ACD |
| C | 9.88 → C | 4.13 → ABD |
| D | 14.63 → D | 1.88 → ABC |
| AB | 10.13 → AB | −1.13 → CD |
| AC | −18.13 → AC | −0.38 → BD |
| AD | 16.63 → AD | 2.38 → BC |
这些估计与把数据作为 24 因子设计一次单独重复所作原始分析(见例 6.2)的结果完全一致。显然, 和 交互作用较大。
确认试验。 把另半分式与主分式相加,可以看作一种确认试验,因为它提供的信息能让我们强化关于两因子交互作用效应的初始结论。我们将在 8.5 节和 8.6 节考察把分式因子设计组合起来以分离交互作用的其他一些方面。
确认试验不必如此复杂。一个非常简单的确认试验是:用模型方程预测设计空间中某个关注点处的响应(该点不应当是当前设计中的某次试验),然后实际做该处理组合(也许重复若干次),把预测响应与观测响应作比较。若两者相当接近,说明对分式因子设计的解释是正确的;而若出现严重偏差,则说明解释存在问题,也就意味着需要做更多试验来消除歧义。
为说明这一点,考虑例 8.1 中的 分式因子设计。试验者想找到一组条件使响应变量过滤速率较高,同时低的甲醛浓度(因子 )是可取的。这提示因子 和 应取高水平,而因子 应取低水平。查看图 8.3 可以发现,当 取低水平时,该处理组合已在分式因子设计中做过,观测响应为 100。而 取高水平的那个处理组合不在原来的分式中,所以它适合作为确认试验。取 、、 为高水平、 为低水平,用例 8.1 的模型方程计算预测响应如下:
该处理组合处的观测响应为 104(参见图 6.10,那里给出了完整 24 因子设计的响应数据)。由于过滤速率的观测值与预测值非常接近,这是一次成功的确认试验。这也是我们对该分式因子设计的解释正确的又一证据。
有些情况下,确认试验中的预测值与观测值不会这么接近,这时就需要回答一个问题:这两个值是否足够接近,可以合理地断定对分式设计的解释是正确的。回答这个问题的一种方法是针对确认试验的未来观测构造预测区间,然后看实际观测值是否落在该预测区间内。我们将在 10.6 节引入回归模型的预测区间时,用这个例子说明具体做法。