3.9 随机效应模型
3.9.1 单个随机因子 ¶ 试验者常常关注某个有大量可能水平的因子。如果试验者从该因子的水平总体中随机选取其中 a a a 随机的 。由于试验中实际使用的因子水平是随机选定的,因此所作的推断是针对因子水平的整个总体的。我们假定因子水平总体要么是无限大的,要么大到可以看作无限大。因子水平总体小到需要采用有限总体方法的情形并不常见。关于有限总体情形,参见 Bennett 和 Franklin(1954)以及 Searle 和 Fawcett(1970)。
线性统计模型为
y i j = μ + τ i + ϵ i j { i = 1 , 2 , … , a j = 1 , 2 , … , n (3.44) y_{ij} = \mu+\tau_{i}+\epsilon_{ij} \quad \left\{ \begin{array}{l} i = 1, 2, \ldots, a \\ j = 1, 2, \ldots, n \end{array} \right. \tag{3.44} y ij = μ + τ i + ϵ ij { i = 1 , 2 , … , a j = 1 , 2 , … , n ( 3.44 ) 其中处理效应 τ i \tau_{i} τ i ϵ i j \epsilon_{ij} ϵ ij τ i \tau_{i} τ i N I D ( 0 , σ τ 2 ) \mathrm{NID}(0,\sigma_{\tau}^{2}) NID ( 0 , σ τ 2 ) [1] N I D ( 0 , σ 2 ) \mathrm{NID}(0,\sigma^{2}) NID ( 0 , σ 2 ) τ i \tau_{i} τ i ϵ i j \epsilon_{ij} ϵ ij τ i \tau_{i} τ i ϵ i j \epsilon_{ij} ϵ ij
V ( y i j ) = σ τ 2 + σ 2 V(y_{ij}) = \sigma_{\tau}^{2}+\sigma^{2} V ( y ij ) = σ τ 2 + σ 2 方差 σ τ 2 \sigma_{\tau}^{2} σ τ 2 σ 2 \sigma^{2} σ 2 方差分量 (variance component),模型(式 3.44)称为方差分量模型 或随机效应模型 。随机效应模型中的观测值服从正态分布,因为它们是两个正态独立随机变量 τ i \tau_{i} τ i ϵ i j \epsilon_{ij} ϵ ij y i j y_{ij} y ij y i j y_{ij} y ij
Cov ( y i j , y i j ′ ) = σ τ 2 j ≠ j ′ Cov ( y i j , y i ′ j ′ ) = 0 i ≠ i ′ \begin{array}{ll}
\operatorname{Cov}(y_{ij},y_{ij'}) = \sigma_{\tau}^{2} & j \neq j' \\
\operatorname{Cov}(y_{ij},y_{i'j'}) = 0 & i \neq i'
\end{array} Cov ( y ij , y i j ′ ) = σ τ 2 Cov ( y ij , y i ′ j ′ ) = 0 j = j ′ i = i ′ 注意同一因子水平内的观测值都具有相同的协方差,因为在实施试验之前,我们预期该因子水平下的观测值彼此相似,因为它们具有相同的随机分量。一旦试验实施完毕,我们就可以假定所有观测值都相互独立,因为参数 τ i \tau_{i} τ i
单因子随机效应模型中观测值的协方差结构可以用观测值的协方差矩阵来表示。为说明这一点,假设我们有 a = 3 a=3 a = 3 n = 2 n=2 n = 2 N = 6 N=6 N = 6
y = [ y 11 y 12 y 21 y 22 y 31 y 32 ] \mathbf{y} = \left[ \begin{array}{c} y_{11} \\ y_{12} \\ y_{21} \\ y_{22} \\ y_{31} \\ y_{32} \end{array} \right] y = ⎣ ⎡ y 11 y 12 y 21 y 22 y 31 y 32 ⎦ ⎤ 这些观测值的 6 × 6 6 \times 6 6 × 6
Cov ( y ) = [ σ τ 2 + σ 2 σ τ 2 0 0 0 0 σ τ 2 σ τ 2 + σ 2 0 0 0 0 0 0 σ τ 2 + σ 2 σ τ 2 0 0 0 0 σ τ 2 σ τ 2 + σ 2 0 0 0 0 0 0 σ τ 2 + σ 2 σ τ 2 0 0 0 0 σ τ 2 σ τ 2 + σ 2 ] \operatorname{Cov}(\mathbf{y}) = \left[ \begin{array}{cccccc}
\sigma_{\tau}^{2}+\sigma^{2} & \sigma_{\tau}^{2} & 0 & 0 & 0 & 0 \\
\sigma_{\tau}^{2} & \sigma_{\tau}^{2}+\sigma^{2} & 0 & 0 & 0 & 0 \\
0 & 0 & \sigma_{\tau}^{2}+\sigma^{2} & \sigma_{\tau}^{2} & 0 & 0 \\
0 & 0 & \sigma_{\tau}^{2} & \sigma_{\tau}^{2}+\sigma^{2} & 0 & 0 \\
0 & 0 & 0 & 0 & \sigma_{\tau}^{2}+\sigma^{2} & \sigma_{\tau}^{2} \\
0 & 0 & 0 & 0 & \sigma_{\tau}^{2} & \sigma_{\tau}^{2}+\sigma^{2}
\end{array} \right] Cov ( y ) = ⎣ ⎡ σ τ 2 + σ 2 σ τ 2 0 0 0 0 σ τ 2 σ τ 2 + σ 2 0 0 0 0 0 0 σ τ 2 + σ 2 σ τ 2 0 0 0 0 σ τ 2 σ τ 2 + σ 2 0 0 0 0 0 0 σ τ 2 + σ 2 σ τ 2 0 0 0 0 σ τ 2 σ τ 2 + σ 2 ⎦ ⎤ 该矩阵的主对角线元素是每个观测值的方差,每个非对角线元素是一对观测值的协方差。
3.9.2 随机模型的方差分析 ¶ 基本的方差分析平方和恒等式
S S T = S S 处理 + S S E (3.45) SS_{T} = SS_{\text{处理}}+SS_{E} \tag{3.45} S S T = S S 处理 + S S E ( 3.45 ) 仍然成立。也就是说,我们把观测值的总变异分解为一个度量处理之间变异的成分(S S 处理 SS_{\text{处理}} S S 处理 S S E SS_{E} S S E σ τ 2 \sigma_{\tau}^{2} σ τ 2
H 0 : σ τ 2 = 0 H 1 : σ τ 2 > 0 (3.46) \begin{array}{l}
H_{0}: \sigma_{\tau}^{2} = 0 \\
H_{1}: \sigma_{\tau}^{2} > 0
\end{array} \tag{3.46} H 0 : σ τ 2 = 0 H 1 : σ τ 2 > 0 ( 3.46 ) 若 σ τ 2 = 0 \sigma_{\tau}^{2}=0 σ τ 2 = 0 σ τ 2 > 0 \sigma_{\tau}^{2}>0 σ τ 2 > 0 [2] S S E / σ 2 SS_{E}/\sigma^{2} S S E / σ 2 N − a N-a N − a S S 处理 / σ 2 SS_{\text{处理}}/\sigma^{2} S S 处理 / σ 2 a − 1 a-1 a − 1 σ τ 2 = 0 \sigma_{\tau}^{2}=0 σ τ 2 = 0
F 0 = S S 处理 a − 1 S S E N − a = M S 处理 M S E (3.47) F_{0} = \frac{\frac{SS_{\text{处理}}}{a-1}}{\frac{SS_{E}}{N-a}} = \frac{MS_{\text{处理}}}{MS_{E}} \tag{3.47} F 0 = N − a S S E a − 1 S S 处理 = M S E M S 处理 ( 3.47 ) 服从分子自由度为 a − 1 a-1 a − 1 N − a N-a N − a F F F
考虑
E ( M S 处理 ) = 1 a − 1 E ( S S 处理 ) = 1 a − 1 E [ ∑ i = 1 a y i . 2 n − y . . 2 N ] = 1 a − 1 E [ 1 n ∑ i = 1 a ( ∑ j = 1 n μ + τ i + ϵ i j ) 2 − 1 N ( ∑ i = 1 a ∑ j = 1 n μ + τ i + ϵ i j ) 2 ] \begin{aligned}
E(MS_{\text{处理}}) &= \frac{1}{a-1}E(SS_{\text{处理}}) = \frac{1}{a-1}E\left[\sum_{i=1}^{a}\frac{y_{i.}^{2}}{n}-\frac{y_{..}^{2}}{N}\right] \\
&= \frac{1}{a-1}E\left[\frac{1}{n}\sum_{i=1}^{a}\left(\sum_{j=1}^{n}\mu+\tau_{i}+\epsilon_{ij}\right)^{2}-\frac{1}{N}\left(\sum_{i=1}^{a}\sum_{j=1}^{n}\mu+\tau_{i}+\epsilon_{ij}\right)^{2}\right]
\end{aligned} E ( M S 处理 ) = a − 1 1 E ( S S 处理 ) = a − 1 1 E [ i = 1 ∑ a n y i . 2 − N y .. 2 ] = a − 1 1 E ⎣ ⎡ n 1 i = 1 ∑ a ( j = 1 ∑ n μ + τ i + ϵ ij ) 2 − N 1 ( i = 1 ∑ a j = 1 ∑ n μ + τ i + ϵ ij ) 2 ⎦ ⎤ 对括号内的量作平方并取期望时,我们看到涉及 τ i 2 \tau_{i}^{2} τ i 2 σ τ 2 \sigma_{\tau}^{2} σ τ 2 E ( τ i ) = 0 E(\tau_{i})=0 E ( τ i ) = 0 ϵ i . 2 \epsilon_{i.}^{2} ϵ i . 2 ϵ . . 2 \epsilon_{..}^{2} ϵ .. 2 ∑ i = 1 a ∑ j = 1 n τ i 2 \sum_{i=1}^{a}\sum_{j=1}^{n}\tau_{i}^{2} ∑ i = 1 a ∑ j = 1 n τ i 2 n σ 2 n\sigma^{2} n σ 2 a n σ 2 an\sigma^{2} an σ 2 a n 2 an^{2} a n 2 [3] τ i \tau_{i} τ i ϵ i j \epsilon_{ij} ϵ ij
E ( M S 处理 ) = 1 a − 1 [ N μ 2 + N σ τ 2 + a σ 2 − N μ 2 − n σ τ 2 − σ 2 ] E(MS_{\text{处理}}) = \frac{1}{a-1}[N\mu^{2}+N\sigma_{\tau}^{2}+a\sigma^{2}-N\mu^{2}-n\sigma_{\tau}^{2}-\sigma^{2}] E ( M S 处理 ) = a − 1 1 [ N μ 2 + N σ τ 2 + a σ 2 − N μ 2 − n σ τ 2 − σ 2 ] 即
E ( M S 处理 ) = σ 2 + n σ τ 2 (3.48) E(MS_{\text{处理}}) = \sigma^{2}+n\sigma_{\tau}^{2} \tag{3.48} E ( M S 处理 ) = σ 2 + n σ τ 2 ( 3.48 ) 类似地,可以证明
E ( M S E ) = σ 2 (3.49) E(MS_{E}) = \sigma^{2} \tag{3.49} E ( M S E ) = σ 2 ( 3.49 ) 由期望均方可见,在 H 0 H_{0} H 0 σ 2 \sigma^{2} σ 2 H 1 H_{1} H 1 F 0 F_{0} F 0 H 0 H_{0} H 0 F 0 > F α , a − 1 , N − a F_{0} > F_{\alpha,a-1,N-a} F 0 > F α , a − 1 , N − a H 0 H_{0} H 0
随机效应模型的计算程序和方差分析与固定效应情形完全相同。然而结论差别很大,因为它们适用于处理的整个总体。
3.9.3 模型参数的估计 ¶ 我们通常关注模型中方差分量(σ 2 \sigma^{2} σ 2 σ τ 2 \sigma_{\tau}^{2} σ τ 2 σ 2 \sigma^{2} σ 2 σ τ 2 \sigma_{\tau}^{2} σ τ 2 方差分析法 (analysis of variance method),因为它利用方差分析表中的各行。该程序把期望均方与方差分析表中的观测值相等同,并解出方差分量。在单因子随机效应模型中把观测均方与期望均方相等,我们得到
M S 处理 = σ 2 + n σ τ 2 MS_{\text{处理}} = \sigma^{2}+n\sigma_{\tau}^{2} M S 处理 = σ 2 + n σ τ 2 和
M S E = σ 2 MS_{E} = \sigma^{2} M S E = σ 2 因此,方差分量的估计量为
σ ^ 2 = M S E (3.50) \hat{\sigma}^{2} = MS_{E} \tag{3.50} σ ^ 2 = M S E ( 3.50 ) 和
σ ^ τ 2 = M S 处理 − M S E n (3.51) \hat{\sigma}_{\tau}^{2} = \frac{MS_{\text{处理}}-MS_{E}}{n} \tag{3.51} σ ^ τ 2 = n M S 处理 − M S E ( 3.51 ) 对样本量不等的情形,把式 3.51 中的 n n n
n 0 = 1 a − 1 [ ∑ i = 1 a n i − ∑ i = 1 a n i 2 ∑ i = 1 a n i ] (3.52) n_{0} = \frac{1}{a-1}\left[\sum_{i=1}^{a} n_{i}-\frac{\sum_{i=1}^{a} n_{i}^{2}}{\sum_{i=1}^{a} n_{i}}\right] \tag{3.52} n 0 = a − 1 1 [ i = 1 ∑ a n i − ∑ i = 1 a n i ∑ i = 1 a n i 2 ] ( 3.52 ) 方差分量估计的方差分析法是一种矩法 (method of moments)程序。它不需要正态性假定,并且给出的 σ 2 \sigma^{2} σ 2 σ τ 2 \sigma_{\tau}^{2} σ τ 2 最佳二次无偏 的(也就是说,在观测值的所有无偏二次函数中,这些估计量的方差最小)。还有一种基于最大似然的方法可以用来估计方差分量,稍后将会介绍。
有时方差分析法会产生方差分量的负估计。显然,按定义方差分量是非负的,因此方差分量的负估计令人有些担忧。一种做法是接受该估计,并把它当作方差分量真值为零的证据,假定负估计是抽样变异造成的。这有直观吸引力,但在理论上有些困难。例如,用零代替负估计会干扰其他估计的统计性质。另一种做法是用一种总能给出非负估计的方法重新估计该负的方差分量。还有一种做法是把负估计视为所假定的线性模型不正确的证据,并重新审视问题。关于方差分量估计的全面论述,见 Searle(1971a,1971b)、Searle、Casella 和 McCullogh(1992)以及 Burdick 和 Graybill(1992)。
例 3.10 ¶ 一家纺织公司在许多台织机上织造某种织物。它希望各织机是齐同的,以便获得强度一致的织物。工艺工程师怀疑,除了同一织机上织物样本内通常存在的强度变异之外,织机之间可能还存在显著的强度变异。为考察这一点,她随机选取四台织机,并在每台织机生产的织物上作四次强度测定。该试验按随机顺序进行,所得数据见表 3.18。所作方差分析见表 3.19。由方差分析我们得出结论:厂内的织机之间存在显著差异。
方差分量估计为 σ ^ 2 = 1.90 \hat{\sigma}^{2}=1.90 σ ^ 2 = 1.90
σ ^ τ 2 = 29.73 − 1.90 4 = 6.96 \hat{\sigma}_{\tau}^{2} = \frac{29.73-1.90}{4} = 6.96 σ ^ τ 2 = 4 29.73 − 1.90 = 6.96 因此,任一强度观测值的方差估计为
σ ^ y = σ ^ 2 + σ ^ τ 2 = 1.90 + 6.96 = 8.86 \hat{\sigma}_{y} = \hat{\sigma}^{2}+\hat{\sigma}_{\tau}^{2} = 1.90+6.96 = 8.86 σ ^ y = σ ^ 2 + σ ^ τ 2 = 1.90 + 6.96 = 8.86 这一变异的大部分可归因于织机之间的差异。
表 3.18 例 3.10 的强度数据
织机 观测值 1 2 3 4 y i . y_{i.} y i . 1 98 97 99 96 390 2 91 90 93 92 366 3 96 95 97 95 383 4 95 96 99 98 388 y . . = 1527 y_{..} = 1527 y .. = 1527
表 3.19 强度数据的方差分析
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 P P P 织机 89.19 3 29.73 15.68 <0.001 误差 22.75 12 1.90 总计 111.94 15
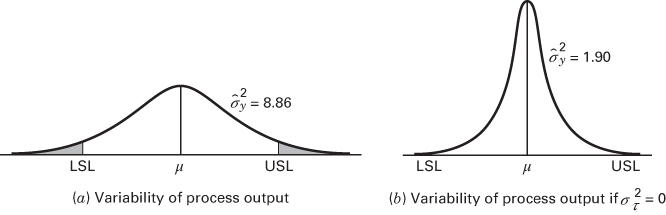
图 3.19 纤维强度问题中的过程输出
这个例子说明了方差分量的一个重要用途——分离影响产品或系统的不同变异来源。产品变异问题在质量保证中经常出现,而且往往难以分离出变异来源。例如,这项研究可能源于一个观察:织物强度的变异太大,如图 3.19a 所示。该图把过程输出(纤维强度)表示为方差 σ ^ y 2 = 8.86 \hat{\sigma}_{y}^{2}=8.86 σ ^ y 2 = 8.86
工艺工程师现在必须设法分离出织机性能差异的具体原因。如果她能找出并消除这些织机间变异来源,过程输出的方差就可以大为降低,或许能低至 σ ^ y 2 = 1.90 \hat{\sigma}_{y}^{2}=1.90 σ ^ y 2 = 1.90 σ ^ y 2 = 1.90 \hat{\sigma}_{y}^{2}=1.90 σ ^ y 2 = 1.90
我们很容易求出方差分量 σ 2 \sigma^{2} σ 2 ( N − a ) M S E / σ 2 (N-a)MS_{E}/\sigma^{2} ( N − a ) M S E / σ 2 χ N − a 2 \chi_{N-a}^{2} χ N − a 2
P [ χ 1 − ( α / 2 ) , N − a 2 ≤ ( N − a ) M S E σ 2 ≤ χ α / 2 , N − a 2 ] = 1 − α P\left[\chi_{1-(\alpha/2),N-a}^{2} \leq \frac{(N-a)MS_{E}}{\sigma^{2}} \leq \chi_{\alpha/2,N-a}^{2}\right] = 1-\alpha P [ χ 1 − ( α /2 ) , N − a 2 ≤ σ 2 ( N − a ) M S E ≤ χ α /2 , N − a 2 ] = 1 − α σ 2 \sigma^{2} σ 2 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
( N − a ) M S E χ α / 2 , N − a 2 ≤ σ 2 ≤ ( N − a ) M S E χ 1 − ( α / 2 ) , N − a 2 (3.53) \frac{(N-a)MS_{E}}{\chi_{\alpha/2,N-a}^{2}} \leq \sigma^{2} \leq \frac{(N-a)MS_{E}}{\chi_{1-(\alpha/2),N-a}^{2}} \tag{3.53} χ α /2 , N − a 2 ( N − a ) M S E ≤ σ 2 ≤ χ 1 − ( α /2 ) , N − a 2 ( N − a ) M S E ( 3.53 ) 由于 M S E = 1.90 MS_{E}=1.90 M S E = 1.90 N = 16 N=16 N = 16 a = 4 a=4 a = 4 χ 0.025 , 12 2 = 23.3367 \chi_{0.025,12}^{2}=23.3367 χ 0.025 , 12 2 = 23.3367 χ 0.975 , 12 2 = 4.4038 \chi_{0.975,12}^{2}=4.4038 χ 0.975 , 12 2 = 4.4038 σ 2 \sigma^{2} σ 2 0.9770 ≤ σ 2 ≤ 5.1775 0.9770 \leq \sigma^{2} \leq 5.1775 0.9770 ≤ σ 2 ≤ 5.1775 [4]
现在考虑方差分量 σ τ 2 \sigma_{\tau}^{2} σ τ 2
σ ^ τ 2 = M S 处理 − M S E n \hat{\sigma}_{\tau}^{2} = \frac{MS_{\text{处理}}-MS_{E}}{n} σ ^ τ 2 = n M S 处理 − M S E 随机变量 ( a − 1 ) M S 处理 / ( σ 2 + n σ τ 2 ) (a-1)MS_{\text{处理}}/(\sigma^{2}+n\sigma_{\tau}^{2}) ( a − 1 ) M S 处理 / ( σ 2 + n σ τ 2 ) χ a − 1 2 \chi_{a-1}^{2} χ a − 1 2 ( N − a ) M S E / σ 2 (N-a)MS_{E}/\sigma^{2} ( N − a ) M S E / σ 2 χ N − a 2 \chi_{N-a}^{2} χ N − a 2 σ ^ τ 2 \hat{\sigma}_{\tau}^{2} σ ^ τ 2
u 1 χ a − 1 2 − u 2 χ N − a 2 u_{1}\chi_{a-1}^{2}-u_{2}\chi_{N-a}^{2} u 1 χ a − 1 2 − u 2 χ N − a 2 其中
u 1 = σ 2 + n σ τ 2 n ( a − 1 ) 和 u 2 = σ 2 n ( N − a ) u_{1} = \frac{\sigma^{2}+n\sigma_{\tau}^{2}}{n(a-1)} \quad \text{和} \quad u_{2} = \frac{\sigma^{2}}{n(N-a)} u 1 = n ( a − 1 ) σ 2 + n σ τ 2 和 u 2 = n ( N − a ) σ 2 遗憾的是,这一卡方随机变量线性组合的分布无法得到闭式表达式。因此,无法构造 σ τ 2 \sigma_{\tau}^{2} σ τ 2
对于比值 σ τ 2 / ( σ τ 2 + σ 2 ) \sigma_{\tau}^{2}/(\sigma_{\tau}^{2}+\sigma^{2}) σ τ 2 / ( σ τ 2 + σ 2 ) 组内相关系数 (intraclass correlation coefficient),它反映观测值方差[回忆 V ( y i j ) = σ τ 2 + σ 2 V(y_{ij})=\sigma_{\tau}^{2}+\sigma^{2} V ( y ij ) = σ τ 2 + σ 2 M S 处理 MS_{\text{处理}} M S 处理 M S E MS_{E} M S E
M S 处理 / ( n σ τ 2 + σ 2 ) M S E / σ 2 ∼ F a − 1 , N − a \frac{MS_{\text{处理}}/(n\sigma_{\tau}^{2}+\sigma^{2})}{MS_{E}/\sigma^{2}} \sim F_{a-1,N-a} M S E / σ 2 M S 处理 / ( n σ τ 2 + σ 2 ) ∼ F a − 1 , N − a 因此
P ( F 1 − α / 2 , a − 1 , N − a ≤ M S 处理 M S E σ 2 n σ τ 2 + σ 2 ≤ F α / 2 , a − 1 , N − a ) = 1 − α (3.54) P\left(F_{1-\alpha/2,a-1,N-a} \leq \frac{MS_{\text{处理}}}{MS_{E}}\frac{\sigma^{2}}{n\sigma_{\tau}^{2}+\sigma^{2}} \leq F_{\alpha/2,a-1,N-a}\right) = 1-\alpha \tag{3.54} P ( F 1 − α /2 , a − 1 , N − a ≤ M S E M S 处理 n σ τ 2 + σ 2 σ 2 ≤ F α /2 , a − 1 , N − a ) = 1 − α ( 3.54 ) 对式 3.54 作整理,可以得到
P ( L ≤ σ τ 2 σ 2 ≤ U ) = 1 − α (3.55) P\left(L \leq \frac{\sigma_{\tau}^{2}}{\sigma^{2}} \leq U\right) = 1-\alpha \tag{3.55} P ( L ≤ σ 2 σ τ 2 ≤ U ) = 1 − α ( 3.55 ) 其中
L = 1 n ( M S 处理 M S E 1 F α / 2 , a − 1 , N − a − 1 ) (3.56a) L = \frac{1}{n}\left(\frac{MS_{\text{处理}}}{MS_{E}}\frac{1}{F_{\alpha/2,a-1,N-a}}-1\right) \tag{3.56a} L = n 1 ( M S E M S 处理 F α /2 , a − 1 , N − a 1 − 1 ) ( 3.56a ) 和
U = 1 n ( M S 处理 M S E 1 F 1 − α / 2 , a − 1 , N − a − 1 ) (3.56b) U = \frac{1}{n}\left(\frac{MS_{\text{处理}}}{MS_{E}}\frac{1}{F_{1-\alpha/2,a-1,N-a}}-1\right) \tag{3.56b} U = n 1 ( M S E M S 处理 F 1 − α /2 , a − 1 , N − a 1 − 1 ) ( 3.56b ) 注意 L L L U U U σ τ 2 / σ 2 \sigma_{\tau}^{2}/\sigma^{2} σ τ 2 / σ 2 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) σ τ 2 / ( σ τ 2 + σ 2 ) \sigma_{\tau}^{2}/(\sigma_{\tau}^{2}+\sigma^{2}) σ τ 2 / ( σ τ 2 + σ 2 ) 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
L 1 + L ≤ σ τ 2 σ τ 2 + σ 2 ≤ U 1 + U (3.57) \frac{L}{1+L} \leq \frac{\sigma_{\tau}^{2}}{\sigma_{\tau}^{2}+\sigma^{2}} \leq \frac{U}{1+U} \tag{3.57} 1 + L L ≤ σ τ 2 + σ 2 σ τ 2 ≤ 1 + U U ( 3.57 ) 为说明这一程序,我们对例 3.10 的强度数据求出 σ τ 2 / ( σ τ 2 + σ 2 ) \sigma_{\tau}^{2}/(\sigma_{\tau}^{2}+\sigma^{2}) σ τ 2 / ( σ τ 2 + σ 2 ) M S 处理 = 29.73 MS_{\text{处理}}=29.73 M S 处理 = 29.73 M S E = 1.90 MS_{E}=1.90 M S E = 1.90 a = 4 a=4 a = 4 n = 4 n=4 n = 4 F 0.025 , 3 , 12 = 4.47 F_{0.025,3,12}=4.47 F 0.025 , 3 , 12 = 4.47 F 0.975 , 3 , 12 = 1 / F 0.025 , 12 , 3 = 1 / 14.34 = 0.070 F_{0.975,3,12}=1/F_{0.025,12,3}=1/14.34=0.070 F 0.975 , 3 , 12 = 1/ F 0.025 , 12 , 3 = 1/14.34 = 0.070
L = 1 4 [ ( 29.73 1.90 ) ( 1 4.47 ) − 1 ] = 0.625 L = \frac{1}{4}\left[\left(\frac{29.73}{1.90}\right)\left(\frac{1}{4.47}\right)-1\right] = 0.625 L = 4 1 [ ( 1.90 29.73 ) ( 4.47 1 ) − 1 ] = 0.625 U = 1 4 [ ( 29.73 1.90 ) ( 1 0.070 ) − 1 ] = 55.633 U = \frac{1}{4}\left[\left(\frac{29.73}{1.90}\right)\left(\frac{1}{0.070}\right)-1\right] = 55.633 U = 4 1 [ ( 1.90 29.73 ) ( 0.070 1 ) − 1 ] = 55.633 由式 3.57,σ τ 2 / ( σ τ 2 + σ 2 ) \sigma_{\tau}^{2}/(\sigma_{\tau}^{2}+\sigma^{2}) σ τ 2 / ( σ τ 2 + σ 2 )
0.625 1.625 ≤ σ τ 2 σ τ 2 + σ 2 ≤ 55.633 56.633 \frac{0.625}{1.625} \leq \frac{\sigma_{\tau}^{2}}{\sigma_{\tau}^{2}+\sigma^{2}} \leq \frac{55.633}{56.633} 1.625 0.625 ≤ σ τ 2 + σ 2 σ τ 2 ≤ 56.633 55.633 即
0.38 ≤ σ τ 2 σ τ 2 + σ 2 ≤ 0.98 0.38 \leq \frac{\sigma_{\tau}^{2}}{\sigma_{\tau}^{2}+\sigma^{2}} \leq 0.98 0.38 ≤ σ τ 2 + σ 2 σ τ 2 ≤ 0.98 我们得出结论:织机之间的变异占所观测到的织物强度变异的 38% 到 98%。由于试验中使用的织机数量很少,这一置信区间相对较宽。然而显然,织机之间的变异(σ τ 2 \sigma_{\tau}^{2} σ τ 2
总均值 μ \mu μ 在许多随机效应试验中,试验者关注总均值 μ \mu μ
μ ^ = y ‾ . . \hat{\mu} = \overline{y}_{..} μ ^ = y .. 所以例 3.10 中总平均强度的估计为
μ ^ = y ‾ . . = y . . N = 1527 16 = 95.44 \hat{\mu} = \overline{y}_{..} = \frac{y_{..}}{N} = \frac{1527}{16} = 95.44 μ ^ = y .. = N y .. = 16 1527 = 95.44 也可以求出总均值的 100 ( 1 − α ) % 100(1-\alpha)\% 100 ( 1 − α ) % y ˉ \bar{y} y ˉ
V ( y ‾ . . ) = V ( ∑ i = 1 a ∑ j = 1 n y i j a n ) = n σ τ 2 + σ 2 a n V(\overline{y}_{..}) = V\left(\frac{\sum_{i=1}^{a}\sum_{j=1}^{n} y_{ij}}{an}\right) = \frac{n\sigma_{\tau}^{2}+\sigma^{2}}{an} V ( y .. ) = V ( an ∑ i = 1 a ∑ j = 1 n y ij ) = an n σ τ 2 + σ 2 这一比值的分子由处理均方来估计,因此 V ( y ‾ ) V(\overline{y}) V ( y )
V ^ ( y ‾ . . ) = M S 处理 a n \hat{V}(\overline{y}_{..}) = \frac{MS_{\text{处理}}}{an} V ^ ( y .. ) = an M S 处理 因此总均值的 100 ( 1 − α ) % 100(1-\alpha)\% 100 ( 1 − α ) %
y ‾ . . − t α / 2 , a ( n − 1 ) M S 处理 a n ≤ μ ≤ y ‾ . . + t α / 2 , a ( n − 1 ) M S 处理 a n (3.58) \overline{y}_{..}-t_{\alpha/2,a(n-1)}\sqrt{\frac{MS_{\text{处理}}}{an}} \leq \mu \leq \overline{y}_{..}+t_{\alpha/2,a(n-1)}\sqrt{\frac{MS_{\text{处理}}}{an}} \tag{3.58} y .. − t α /2 , a ( n − 1 ) an M S 处理 ≤ μ ≤ y .. + t α /2 , a ( n − 1 ) an M S 处理 ( 3.58 ) 为求例 3.10 织物强度试验中总均值的 95% 置信区间,需要 M S 处理 = 29.73 MS_{\text{处理}}=29.73 M S 处理 = 29.73 t 0.025 , 12 = 2.18 t_{0.025,12}=2.18 t 0.025 , 12 = 2.18
y ‾ . . − t α / 2 , a ( n − 1 ) M S 处理 a n ≤ μ ≤ y ‾ . . + t α / 2 , a ( n − 1 ) M S 处理 a n \overline{y}_{..}-t_{\alpha/2,a(n-1)}\sqrt{\frac{MS_{\text{处理}}}{an}} \leq \mu \leq \overline{y}_{..}+t_{\alpha/2,a(n-1)}\sqrt{\frac{MS_{\text{处理}}}{an}} y .. − t α /2 , a ( n − 1 ) an M S 处理 ≤ μ ≤ y .. + t α /2 , a ( n − 1 ) an M S 处理 95.44 − 2.18 29.73 16 ≤ μ ≤ 95.44 + 2.18 29.73 16 95.44-2.18\sqrt{\frac{29.73}{16}} \leq \mu \leq 95.44+2.18\sqrt{\frac{29.73}{16}} 95.44 − 2.18 16 29.73 ≤ μ ≤ 95.44 + 2.18 16 29.73 92.47 ≤ μ ≤ 98.41 92.47 \leq \mu \leq 98.41 92.47 ≤ μ ≤ 98.41 所以,在 95% 置信水平下,该厂织机所生产织物的平均强度在 92.47 与 98.41 之间。这是一个相对较宽的置信区间,因为抽样选取的织机数量很少,而且织机之间存在很大的差异——这体现在织机间差异解释了总变异中很大的一部分。
方差分量的最大似然估计。 本节前面介绍了方差分量估计的方差分析法。该方法应用起来相对直接,并利用了熟悉的量——方差分析表中的均方。然而它也有一些缺点。如前所述,它是一种矩法估计,而数理统计学家一般不喜欢用矩法做参数估计,因为它往往给出不具备良好统计性质的参数估计。一个明显的问题是,它并不总能提供构造所关注方差分量置信区间的简便途径。例如在单因子随机模型中,没有构造 σ τ 2 \sigma_{\tau}^{2} σ τ 2 σ τ 2 \sigma_{\tau}^{2} σ τ 2 最大似然法 (method of maximum likelihood)。该方法的具体实施可能有些繁复,尤其是对试验设计模型而言;但它已被纳入一些支持设计试验的现代计算机软件包中,包括 JMP。
完整介绍最大似然法超出本书范围,但其基本思想可以很容易地说明。假设 x x x f ( x , θ ) f(x,\theta) f ( x , θ ) θ \theta θ x 1 , x 2 , … , x n x_{1}, x_{2}, \ldots, x_{n} x 1 , x 2 , … , x n n n n ∏ i = 1 n f ( x i , θ ) \prod_{i=1}^{n} f(x_{i},\theta) ∏ i = 1 n f ( x i , θ ) 似然函数 就是把样本观测值视为固定、参数 θ \theta θ
L ( x 1 , x 2 , … , x n ; θ ) = ∏ i = 1 n f ( x i , θ ) L(x_{1}, x_{2}, \ldots, x_{n};\theta) = \prod_{i=1}^{n} f(x_{i},\theta) L ( x 1 , x 2 , … , x n ; θ ) = i = 1 ∏ n f ( x i , θ ) 现在只是未知参数 θ \theta θ θ \theta θ L ( x 1 , x 2 , … , x n ; θ ) L(x_{1}, x_{2}, \ldots, x_{n};\theta) L ( x 1 , x 2 , … , x n ; θ ) θ \theta θ y \mathbf{y} y a a a n n n a n × 1 an \times 1 an × 1 Σ \Sigma Σ a n × a n an \times an an × an a = 3 a=3 a = 3 n = 2 n=2 n = 2
L ( x 11 , x 12 , … , x a , n ; μ , σ τ 2 , σ 2 ) = 1 ( 2 π ) N / 2 ∣ Σ ∣ 1 / 2 exp [ − 1 2 ( y − j N μ ) ′ Σ − 1 ( y − j N μ ) ] L(x_{11}, x_{12}, \ldots, x_{a,n};\mu,\sigma_{\tau}^{2},\sigma^{2}) = \frac{1}{(2\pi)^{N/2}|\Sigma|^{1/2}}\exp\left[-\frac{1}{2}(\mathbf{y}-\mathbf{j}_{N}\mu)'\Sigma^{-1}(\mathbf{y}-\mathbf{j}_{N}\mu)\right] L ( x 11 , x 12 , … , x a , n ; μ , σ τ 2 , σ 2 ) = ( 2 π ) N /2 ∣Σ ∣ 1/2 1 exp [ − 2 1 ( y − j N μ ) ′ Σ − 1 ( y − j N μ ) ] 其中 N = a n N=an N = an j N \mathbf{j}_{N} j N N × 1 N \times 1 N × 1 μ \mu μ μ \mu μ σ τ 2 \sigma_{\tau}^{2} σ τ 2 σ 2 \sigma^{2} σ 2
最大似然估计量(maximum likelihood estimator,MLE)有一些非常有用的性质。对大样本,它们是无偏的,并且服从正态分布。此外,似然函数的二阶导数矩阵的逆(乘以 -1)就是 MLE 的协方差矩阵。这使得求 MLE 的近似置信区间相对容易。
用于估计方差分量的标准最大似然估计变体称为残差最大似然法 (residual maximum likelihood,REML)。它很流行,因为它给出无偏估计量,并且像所有 MLE 一样容易求置信区间。REML 的基本特点是:在估计随机效应时它把模型中的位置参数考虑在内。举一个简单的例子,假设我们希望用最大似然法估计一个正态分布的均值和方差。容易证明 MLE 为
μ ^ = ∑ i = 1 n y i n = y ‾ \hat{\mu} = \frac{\sum_{i=1}^{n} y_{i}}{n} = \overline{y} μ ^ = n ∑ i = 1 n y i = y σ ^ 2 = ∑ i = 1 n ( y i − y ‾ ) 2 n \hat{\sigma}^{2} = \frac{\sum_{i=1}^{n} (y_{i}-\overline{y})^{2}}{n} σ ^ 2 = n ∑ i = 1 n ( y i − y ) 2 注意 MLE σ ^ 2 \hat{\sigma}^{2} σ ^ 2 μ \mu μ
S 2 = ∑ i = 1 n ( y i − y ‾ ) 2 n − 1 S^{2} = \frac{\sum_{i=1}^{n} (y_{i}-\overline{y})^{2}}{n-1} S 2 = n − 1 ∑ i = 1 n ( y i − y ) 2 REML 估计量是无偏的。
表 3.20 例 3.10 织机试验的 JMP 输出
Response Y Summary of Fit RSquare 0.793521 RSquare Adj 0.793521 Root Mean Square Error 1.376893 Mean of Response 95.4375 Observations (or Sum Wgts) 16 Parameter Estimates Term Estimate Std Error DFDen t Ratio Prob > |t| Intercept 95.4375 1.363111 3 70.01 < .0001* REML Variance Component Estimates Random Effect Var Ratio Var Component Std Error 95% Lower 95% Upper X1 3.6703297 6.9583333 6.0715247 -4.941636 18.858303 Residual 1.8958333 0.7739707 0.9748608 5.1660065 Total 8.8541667 Covariance Matrix of Variance Component Estimates Random Effect X1 Residual X1 36.863412 -0.149758 Residual -0.149758 0.5990307
为说明 REML 方法,表 3.20 给出了例 3.10 织机试验的 JMP 输出。输出中显示了模型参数 μ \mu μ σ τ 2 \sigma_{\tau}^{2} σ τ 2 σ 2 \sigma^{2} σ 2 θ ^ \hat{\theta} θ ^ θ \theta θ σ ^ ( θ ^ ) \hat{\sigma}(\hat{\theta}) σ ^ ( θ ^ ) θ \theta θ 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
θ ^ − Z α / 2 σ ^ ( θ ^ ) ≤ θ ≤ θ ^ + Z α / 2 σ ^ ( θ ^ ) \hat{\theta}-Z_{\alpha/2}\hat{\sigma}(\hat{\theta}) \leq \theta \leq \hat{\theta}+Z_{\alpha/2}\hat{\sigma}(\hat{\theta}) θ ^ − Z α /2 σ ^ ( θ ^ ) ≤ θ ≤ θ ^ + Z α /2 σ ^ ( θ ^ ) JMP 就用这一途径求出输出中所示的 σ τ 2 \sigma_{\tau}^{2} σ τ 2 σ 2 \sigma^{2} σ 2 σ 2 \sigma^{2} σ 2