3.3 固定效应模型的分析
本节我们建立固定效应模型的单因子方差分析。回忆一下,y i . y_{i.} y i . i i i y ‾ i . \overline{y}_{i.} y i . i i i y . . y_{..} y .. y ‾ . . \overline{y}_{..} y ..
y i . = ∑ j = 1 n y i j y ‾ i . = y i . / n i = 1 , 2 , … , a (3.3) y_{i.} = \sum_{j=1}^{n} y_{ij} \qquad \overline{y}_{i.} = y_{i.}/n \qquad i = 1, 2, \ldots, a \tag{3.3} y i . = j = 1 ∑ n y ij y i . = y i . / n i = 1 , 2 , … , a ( 3.3 ) y . . = ∑ i = 1 a ∑ j = 1 n y i j y ‾ . . = y . . / N y_{..} = \sum_{i=1}^{a}\sum_{j=1}^{n} y_{ij} \qquad \overline{y}_{..} = y_{..}/N y .. = i = 1 ∑ a j = 1 ∑ n y ij y .. = y .. / N 其中 N = a n N = an N = an
我们感兴趣的是检验 a a a E ( y i j ) = μ + τ i = μ i E(y_{ij}) = \mu+\tau_{i} = \mu_{i} E ( y ij ) = μ + τ i = μ i i = 1 , 2 , … , a i = 1, 2, \ldots, a i = 1 , 2 , … , a
H 0 : μ 1 = μ 2 = ⋯ = μ a H 1 : μ i ≠ μ j 至少有一对 ( i , j ) (3.4) \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} = \cdots = \mu_{a} \\
H_{1}: \mu_{i} \neq \mu_{j} \quad \text{至少有一对 } (i, j)
\end{array} \tag{3.4} H 0 : μ 1 = μ 2 = ⋯ = μ a H 1 : μ i = μ j 至少有一对 ( i , j ) ( 3.4 ) 在效应模型中,我们把第 i i i μ i \mu_{i} μ i μ i = μ + τ i \mu_{i} = \mu+\tau_{i} μ i = μ + τ i μ \mu μ
∑ i = 1 a μ i a = μ \frac{\sum_{i=1}^{a} \mu_{i}}{a} = \mu a ∑ i = 1 a μ i = μ 这一含义表明
∑ i = 1 a τ i = 0 \sum_{i=1}^{a} \tau_{i} = 0 i = 1 ∑ a τ i = 0 也就是说,处理效应或因子效应可以看作对总均值的偏离。[1] τ i \tau_{i} τ i
H 0 : τ 1 = τ 2 = ⋯ = τ a = 0 H 1 : τ i ≠ 0 至少有一个 i \begin{array}{l}
H_{0}: \tau_{1} = \tau_{2} = \cdots = \tau_{a} = 0 \\
H_{1}: \tau_{i} \neq 0 \quad \text{至少有一个 } i
\end{array} H 0 : τ 1 = τ 2 = ⋯ = τ a = 0 H 1 : τ i = 0 至少有一个 i 于是我们说,这是检验处理均值是否相等,或者检验处理效应(τ i \tau_{i} τ i a a a
3.3.1 总平方和的分解 ¶ 方差分析 这个名称来源于把总变异分解成其各个组成部分。总校正平方和
S S T = ∑ i = 1 a ∑ j = 1 n ( y i j − y ‾ . . ) 2 SS_{T} = \sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\overline{y}_{..})^{2} S S T = i = 1 ∑ a j = 1 ∑ n ( y ij − y .. ) 2 用来作为数据总变异的度量。直观上这是合理的,因为如果把 S S T SS_{T} S S T a n − 1 = N − 1 an-1 = N-1 an − 1 = N − 1 y y y
注意,总校正平方和 S S T SS_{T} S S T
∑ i = 1 a ∑ j = 1 n ( y i j − y ‾ . . ) 2 = ∑ i = 1 a ∑ j = 1 n [ ( y ‾ i . − y ‾ . . ) + ( y i j − y ‾ i . ) ] 2 (3.5) \sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\overline{y}_{..})^{2} = \sum_{i=1}^{a}\sum_{j=1}^{n} [(\overline{y}_{i.}-\overline{y}_{..})+(y_{ij}-\overline{y}_{i.})]^{2} \tag{3.5} i = 1 ∑ a j = 1 ∑ n ( y ij − y .. ) 2 = i = 1 ∑ a j = 1 ∑ n [( y i . − y .. ) + ( y ij − y i . ) ] 2 ( 3.5 ) 或
∑ i = 1 a ∑ j = 1 n ( y i j − y ‾ . . ) 2 = n ∑ i = 1 a ( y ‾ i . − y ‾ . . ) 2 + ∑ i = 1 a ∑ j = 1 n ( y i j − y ‾ i . ) 2 + 2 ∑ i = 1 a ∑ j = 1 n ( y ‾ i . − y ‾ . . ) ( y i j − y ‾ i . ) \begin{aligned}
\sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\overline{y}_{..})^{2} ={}& n\sum_{i=1}^{a} (\overline{y}_{i.}-\overline{y}_{..})^{2}+\sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\overline{y}_{i.})^{2} \\
&+2\sum_{i=1}^{a}\sum_{j=1}^{n} (\overline{y}_{i.}-\overline{y}_{..})(y_{ij}-\overline{y}_{i.})
\end{aligned} i = 1 ∑ a j = 1 ∑ n ( y ij − y .. ) 2 = n i = 1 ∑ a ( y i . − y .. ) 2 + i = 1 ∑ a j = 1 ∑ n ( y ij − y i . ) 2 + 2 i = 1 ∑ a j = 1 ∑ n ( y i . − y .. ) ( y ij − y i . ) 然而,上式中的交叉乘积项为零,因为
∑ j = 1 n ( y i j − y ‾ i . ) = y i . − n y ‾ i . = y i . − n ( y i . / n ) = 0 \sum_{j=1}^{n} (y_{ij}-\overline{y}_{i.}) = y_{i.}-n\overline{y}_{i.} = y_{i.}-n(y_{i.}/n) = 0 j = 1 ∑ n ( y ij − y i . ) = y i . − n y i . = y i . − n ( y i . / n ) = 0 因此有
∑ i = 1 a ∑ j = 1 n ( y i j − y ˉ . . ) 2 = n ∑ i = 1 a ( y ˉ i . − y ˉ . . ) 2 + ∑ i = 1 a ∑ j = 1 n ( y i j − y ˉ i . ) 2 (3.6) \sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\bar{y}_{..})^{2} = n\sum_{i=1}^{a} (\bar{y}_{i.}-\bar{y}_{..})^{2}+\sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\bar{y}_{i.})^{2} \tag{3.6} i = 1 ∑ a j = 1 ∑ n ( y ij − y ˉ .. ) 2 = n i = 1 ∑ a ( y ˉ i . − y ˉ .. ) 2 + i = 1 ∑ a j = 1 ∑ n ( y ij − y ˉ i . ) 2 ( 3.6 ) 式 3.6 就是方差分析的基本恒等式 。它说明:用总校正平方和度量的数据总变异,可以分解为各处理平均与总平均之差的平方和,加上各处理内观测值与该处理平均之差的平方和。现在,观测到的处理平均与总平均之差是处理均值之间差异的度量;而处理内观测值与该处理平均之差则只能由随机误差引起。因此,我们可以把式 3.6 符号化地写成
S S T = S S 处理 + S S E SS_{T} = SS_{\text{处理}} + SS_{E} S S T = S S 处理 + S S E 其中 S S 处理 SS_{\text{处理}} S S 处理 处理平方和 (即处理之间的平方和),S S E SS_{E} S S E 误差平方和 (即处理内部的平方和)。总共有 a n = N an = N an = N S S T SS_{T} S S T N − 1 N-1 N − 1 a a a a a a S S 处理 SS_{\text{处理}} S S 处理 a − 1 a-1 a − 1 n n n n − 1 n-1 n − 1 a a a a ( n − 1 ) = a n − a = N − a a(n-1) = an-a = N-a a ( n − 1 ) = an − a = N − a
显式地考察基本恒等式右端的这两项是有启发性的。考虑误差平方和
S S E = ∑ i = 1 a ∑ j = 1 n ( y i j − y ‾ i . ) 2 = ∑ i = 1 a [ ∑ j = 1 n ( y i j − y ‾ i . ) 2 ] SS_{E} = \sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\overline{y}_{i.})^{2} = \sum_{i=1}^{a}\left[\sum_{j=1}^{n} (y_{ij}-\overline{y}_{i.})^{2}\right] S S E = i = 1 ∑ a j = 1 ∑ n ( y ij − y i . ) 2 = i = 1 ∑ a [ j = 1 ∑ n ( y ij − y i . ) 2 ] 在这种形式下容易看出,方括号内的项若除以 n − 1 n-1 n − 1 i i i
S i 2 = ∑ j = 1 n ( y i j − y ‾ i . ) 2 n − 1 i = 1 , 2 , … , a S_{i}^{2} = \frac{\sum_{j=1}^{n} (y_{ij}-\overline{y}_{i.})^{2}}{n-1} \qquad i = 1, 2, \ldots, a S i 2 = n − 1 ∑ j = 1 n ( y ij − y i . ) 2 i = 1 , 2 , … , a 现在可以把 a a a
( n − 1 ) S 1 2 + ( n − 1 ) S 2 2 + ⋯ + ( n − 1 ) S a 2 ( n − 1 ) + ( n − 1 ) + ⋯ + ( n − 1 ) = ∑ i = 1 a [ ∑ j = 1 n ( y i j − y ‾ i . ) 2 ] ∑ i = 1 a ( n − 1 ) = S S E ( N − a ) \begin{aligned}
\frac{(n-1)S_{1}^{2}+(n-1)S_{2}^{2}+\cdots+(n-1)S_{a}^{2}}{(n-1)+(n-1)+\cdots+(n-1)}
&= \frac{\sum_{i=1}^{a}\left[\sum_{j=1}^{n} (y_{ij}-\overline{y}_{i.})^{2}\right]}{\sum_{i=1}^{a}(n-1)} \\
&= \frac{SS_{E}}{(N-a)}
\end{aligned} ( n − 1 ) + ( n − 1 ) + ⋯ + ( n − 1 ) ( n − 1 ) S 1 2 + ( n − 1 ) S 2 2 + ⋯ + ( n − 1 ) S a 2 = ∑ i = 1 a ( n − 1 ) ∑ i = 1 a [ ∑ j = 1 n ( y ij − y i . ) 2 ] = ( N − a ) S S E 因此,S S E / ( N − a ) SS_{E}/(N-a) S S E / ( N − a ) a a a 合并估计 。
类似地,如果 a a a σ 2 \sigma^{2} σ 2
S S 处理 a − 1 = n ∑ i = 1 a ( y ‾ i . − y ‾ . . ) 2 a − 1 \frac{SS_{\text{处理}}}{a-1} = \frac{n\sum_{i=1}^{a} (\overline{y}_{i.}-\overline{y}_{..})^{2}}{a-1} a − 1 S S 处理 = a − 1 n ∑ i = 1 a ( y i . − y .. ) 2 当处理均值相等时是 σ 2 \sigma^{2} σ 2 ∑ i = 1 a ( y ‾ i . − y ‾ . . ) 2 / ( a − 1 ) \sum_{i=1}^{a} (\overline{y}_{i.}-\overline{y}_{..})^{2}/(a-1) ∑ i = 1 a ( y i . − y .. ) 2 / ( a − 1 ) σ 2 / n \sigma^{2}/n σ 2 / n n ∑ i = 1 a ( y ‾ i . − y ‾ . . ) 2 / ( a − 1 ) n\sum_{i=1}^{a} (\overline{y}_{i.}-\overline{y}_{..})^{2}/(a-1) n ∑ i = 1 a ( y i . − y .. ) 2 / ( a − 1 ) σ 2 \sigma^{2} σ 2
我们看到,方差分析恒等式(式 3.6)为我们提供了 σ 2 \sigma^{2} σ 2
量
M S 处理 = S S 处理 a − 1 MS_{\text{处理}} = \frac{SS_{\text{处理}}}{a-1} M S 处理 = a − 1 S S 处理 和
M S E = S S E N − a MS_{E} = \frac{SS_{E}}{N-a} M S E = N − a S S E 称为均方 (mean square)。现在考察这些均方的期望值。考虑
E ( M S E ) = E ( S S E N − a ) = 1 N − a E [ ∑ i = 1 a ∑ j = 1 n ( y i j − y ‾ i . ) 2 ] = 1 N − a E [ ∑ i = 1 a ∑ j = 1 n ( y i j 2 − 2 y i j y ‾ i . + y ‾ i . 2 ) ] = 1 N − a E [ ∑ i = 1 a ∑ j = 1 n y i j 2 − 2 n ∑ i = 1 a y ‾ i . 2 + n ∑ i = 1 a y ‾ i . 2 ] = 1 N − a E [ ∑ i = 1 a ∑ j = 1 n y i j 2 − 1 n ∑ i = 1 a y ‾ i . 2 ] \begin{aligned}
E(MS_{E}) &= E\left(\frac{SS_{E}}{N-a}\right) = \frac{1}{N-a} E\left[\sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}-\overline{y}_{i.})^{2}\right] \\
&= \frac{1}{N-a} E\left[\sum_{i=1}^{a}\sum_{j=1}^{n} (y_{ij}^{2}-2y_{ij}\overline{y}_{i.}+\overline{y}_{i.}^{2})\right] \\
&= \frac{1}{N-a} E\left[\sum_{i=1}^{a}\sum_{j=1}^{n} y_{ij}^{2}-2n\sum_{i=1}^{a}\overline{y}_{i.}^{2}+n\sum_{i=1}^{a}\overline{y}_{i.}^{2}\right] \\
&= \frac{1}{N-a} E\left[\sum_{i=1}^{a}\sum_{j=1}^{n} y_{ij}^{2}-\frac{1}{n}\sum_{i=1}^{a}\overline{y}_{i.}^{2}\right]
\end{aligned} E ( M S E ) = E ( N − a S S E ) = N − a 1 E [ i = 1 ∑ a j = 1 ∑ n ( y ij − y i . ) 2 ] = N − a 1 E [ i = 1 ∑ a j = 1 ∑ n ( y ij 2 − 2 y ij y i . + y i . 2 ) ] = N − a 1 E [ i = 1 ∑ a j = 1 ∑ n y ij 2 − 2 n i = 1 ∑ a y i . 2 + n i = 1 ∑ a y i . 2 ] = N − a 1 E [ i = 1 ∑ a j = 1 ∑ n y ij 2 − n 1 i = 1 ∑ a y i . 2 ] 把模型(式 3.1)代入这一方程,得到
E ( M S E ) = 1 N − a E [ ∑ i = 1 a ∑ j = 1 n ( μ + τ i + ϵ i j ) 2 − 1 n ∑ i = 1 a ( ∑ j = 1 n μ + τ i + ϵ i j ) 2 ] E(MS_{E}) = \frac{1}{N-a} E\left[\sum_{i=1}^{a}\sum_{j=1}^{n} (\mu+\tau_{i}+\epsilon_{ij})^{2}-\frac{1}{n}\sum_{i=1}^{a}\left(\sum_{j=1}^{n} \mu+\tau_{i}+\epsilon_{ij}\right)^{2}\right] E ( M S E ) = N − a 1 E ⎣ ⎡ i = 1 ∑ a j = 1 ∑ n ( μ + τ i + ϵ ij ) 2 − n 1 i = 1 ∑ a ( j = 1 ∑ n μ + τ i + ϵ ij ) 2 ⎦ ⎤ 现在对括号内的量作平方并取期望时,我们看到涉及 ϵ i j 2 \epsilon_{ij}^{2} ϵ ij 2 ϵ i . 2 \epsilon_{i.}^{2} ϵ i . 2 σ 2 \sigma^{2} σ 2 n σ 2 n\sigma^{2} n σ 2 E ( ϵ i j ) = 0 E(\epsilon_{ij})=0 E ( ϵ ij ) = 0 ϵ i j \epsilon_{ij} ϵ ij
E ( M S E ) = 1 N − a [ N μ 2 + n ∑ i = 1 a τ i 2 + N σ 2 − N μ 2 − n ∑ i = 1 a τ i 2 − a σ 2 ] E(MS_{E}) = \frac{1}{N-a}\left[N\mu^{2}+n\sum_{i=1}^{a}\tau_{i}^{2}+N\sigma^{2}-N\mu^{2}-n\sum_{i=1}^{a}\tau_{i}^{2}-a\sigma^{2}\right] E ( M S E ) = N − a 1 [ N μ 2 + n i = 1 ∑ a τ i 2 + N σ 2 − N μ 2 − n i = 1 ∑ a τ i 2 − a σ 2 ] 即
E ( M S E ) = σ 2 E(MS_{E}) = \sigma^{2} E ( M S E ) = σ 2 用类似的方法还可以证明[2]
E ( M S 处理 ) = σ 2 + n ∑ i = 1 a τ i 2 a − 1 E(MS_{\text{处理}}) = \sigma^{2}+\frac{n\sum_{i=1}^{a}\tau_{i}^{2}}{a-1} E ( M S 处理 ) = σ 2 + a − 1 n ∑ i = 1 a τ i 2 因此,正如我们作启发式论证时所说,M S E = S S E / ( N − a ) MS_{E} = SS_{E}/(N-a) M S E = S S E / ( N − a ) σ 2 \sigma^{2} σ 2 τ i = 0 \tau_{i}=0 τ i = 0 M S 处理 = S S 处理 / ( a − 1 ) MS_{\text{处理}} = SS_{\text{处理}}/(a-1) M S 处理 = S S 处理 / ( a − 1 ) σ 2 \sigma^{2} σ 2 σ 2 \sigma^{2} σ 2
由此看来很清楚:通过比较 M S 处理 MS_{\text{处理}} M S 处理 M S E MS_{E} M S E
3.3.2 统计分析 ¶ 现在我们研究如何对处理均值无差异这一假设(H 0 : μ 1 = μ 2 = ⋯ = μ a H_{0}:\mu_{1}=\mu_{2}=\cdots=\mu_{a} H 0 : μ 1 = μ 2 = ⋯ = μ a H 0 : τ 1 = τ 2 = ⋯ = τ a = 0 H_{0}:\tau_{1}=\tau_{2}=\cdots=\tau_{a}=0 H 0 : τ 1 = τ 2 = ⋯ = τ a = 0 ϵ i j \epsilon_{ij} ϵ ij σ 2 \sigma^{2} σ 2 y i j y_{ij} y ij μ + τ i \mu+\tau_{i} μ + τ i σ 2 \sigma^{2} σ 2 S S T SS_{T} S S T S S T / σ 2 SS_{T}/\sigma^{2} S S T / σ 2 N − 1 N-1 N − 1 S S E / σ 2 SS_{E}/\sigma^{2} S S E / σ 2 N − a N-a N − a H 0 : τ i = 0 H_{0}:\tau_{i}=0 H 0 : τ i = 0 S S 处理 / σ 2 SS_{\text{处理}}/\sigma^{2} S S 处理 / σ 2 a − 1 a-1 a − 1 S S 处理 SS_{\text{处理}} S S 处理 S S E SS_{E} S S E S S T SS_{T} S S T S S E SS_{E} S S E S S 处理 SS_{\text{处理}} S S 处理
定理 3-1 Cochran 定理 ¶ 设 Z i Z_{i} Z i i = 1 , 2 , … , v i = 1, 2, \ldots, v i = 1 , 2 , … , v
∑ i = 1 v Z i 2 = Q 1 + Q 2 + ⋯ + Q s \sum_{i=1}^{v} Z_{i}^{2} = Q_{1}+Q_{2}+\cdots+Q_{s} i = 1 ∑ v Z i 2 = Q 1 + Q 2 + ⋯ + Q s 其中 s ≤ v s \leq v s ≤ v Q i Q_{i} Q i v i v_{i} v i i = 1 , 2 , … , s i = 1, 2, \ldots, s i = 1 , 2 , … , s Q 1 , Q 2 , … , Q s Q_{1}, Q_{2}, \ldots, Q_{s} Q 1 , Q 2 , … , Q s v 1 , v 2 , … , v s v_{1}, v_{2}, \ldots, v_{s} v 1 , v 2 , … , v s
v = v 1 + v 2 + ⋯ + v s v = v_{1}+v_{2}+\cdots+v_{s} v = v 1 + v 2 + ⋯ + v s 由于 S S 处理 SS_{\text{处理}} S S 处理 S S E SS_{E} S S E N − 1 N-1 N − 1 S S 处理 / σ 2 SS_{\text{处理}}/\sigma^{2} S S 处理 / σ 2 S S E / σ 2 SS_{E}/\sigma^{2} S S E / σ 2
F 0 = S S 处理 / ( a − 1 ) S S E / ( N − a ) = M S 处理 M S E (3.7) F_{0} = \frac{SS_{\text{处理}}/(a-1)}{SS_{E}/(N-a)} = \frac{MS_{\text{处理}}}{MS_{E}} \tag{3.7} F 0 = S S E / ( N − a ) S S 处理 / ( a − 1 ) = M S E M S 处理 ( 3.7 ) 服从分子自由度为 a − 1 a-1 a − 1 N − a N-a N − a F F F
由期望均方可见,一般地 M S E MS_{E} M S E σ 2 \sigma^{2} σ 2 M S 处理 MS_{\text{处理}} M S 处理 σ 2 \sigma^{2} σ 2 M S 处理 MS_{\text{处理}} M S 处理 σ 2 \sigma^{2} σ 2 H 0 H_{0} H 0
F 0 > F α , a − 1 , N − a F_{0} > F_{\alpha, a-1, N-a} F 0 > F α , a − 1 , N − a 我们就应当拒绝 H 0 H_{0} H 0 F 0 F_{0} F 0 P P P F F F P P P
平方和可以用几种方法计算。一种直接的做法是利用定义
y i j − y ˉ . . = ( y ˉ i . − y ˉ . . ) + ( y i j − y ˉ i . ) y_{ij}-\bar{y}_{..} = (\bar{y}_{i.}-\bar{y}_{..})+(y_{ij}-\bar{y}_{i.}) y ij − y ˉ .. = ( y ˉ i . − y ˉ .. ) + ( y ij − y ˉ i . ) 用电子表格为每个观测值计算这三项,然后把平方求和,得到 S S T SS_{T} S S T S S 处理 SS_{\text{处理}} S S 处理 S S E SS_{E} S S E S S 处理 SS_{\text{处理}} S S 处理 S S T SS_{T} S S T
S S T = ∑ i = 1 a ∑ j = 1 n y i j 2 − y . . 2 N (3.8) SS_{T} = \sum_{i=1}^{a}\sum_{j=1}^{n} y_{ij}^{2}-\frac{y_{..}^{2}}{N} \tag{3.8} S S T = i = 1 ∑ a j = 1 ∑ n y ij 2 − N y .. 2 ( 3.8 ) S S 处理 = 1 n ∑ i = 1 a y i . 2 − y . . 2 N (3.9) SS_{\text{处理}} = \frac{1}{n}\sum_{i=1}^{a} y_{i.}^{2}-\frac{y_{..}^{2}}{N} \tag{3.9} S S 处理 = n 1 i = 1 ∑ a y i . 2 − N y .. 2 ( 3.9 ) 以及
S S E = S S T − S S 处理 (3.10) SS_{E} = SS_{T}-SS_{\text{处理}} \tag{3.10} S S E = S S T − S S 处理 ( 3.10 ) 这种做法很好,因为有些计算器可以把输入数字之和累加在一个寄存器中、把其平方和累加在另一个寄存器中,这样每个数字只需输入一次。在实践中,我们使用计算机软件来完成这些工作。
检验程序概括在表 3.3 中,这称为方差分析表 (analysis of variance table,ANOVA 表)。
表 3.3 单因子固定效应模型的方差分析表
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 处理之间 S S 处理 = n ∑ i = 1 a ( y ‾ i . − y ‾ . . ) 2 SS_{\text{处理}} = n\sum_{i=1}^{a}(\overline{y}_{i.}-\overline{y}_{..})^{2} S S 处理 = n ∑ i = 1 a ( y i . − y .. ) 2 a − 1 a-1 a − 1 M S 处理 MS_{\text{处理}} M S 处理 F 0 = M S 处理 M S E F_{0} = \dfrac{MS_{\text{处理}}}{MS_{E}} F 0 = M S E M S 处理 误差(处理内部) S S E = S S T − S S 处理 SS_{E} = SS_{T}-SS_{\text{处理}} S S E = S S T − S S 处理 N − a N-a N − a M S E MS_{E} M S E 总计 S S T = ∑ i = 1 a ∑ j = 1 n ( y i j − y ‾ . . ) 2 SS_{T} = \sum_{i=1}^{a}\sum_{j=1}^{n}(y_{ij}-\overline{y}_{..})^{2} S S T = ∑ i = 1 a ∑ j = 1 n ( y ij − y .. ) 2 N − 1 N-1 N − 1
例 3.1 等离子体刻蚀试验 ¶ 为说明方差分析,我们回到 3.1 节讨论的第一个例子。回忆一下,这位工程师有兴趣确定 RF 功率设置是否影响刻蚀速率,她已用四个 RF 功率水平和五次重复进行了一次完全随机化试验。为方便起见,这里重复表 3.1 中的数据:
通常这些计算会在计算机上用能够分析设计试验数据的软件包来完成。
RF 功率 (W) 观测刻蚀速率 (Å/min) 1 2 3 4 5 合计 y i . y_{i.} y i . 平均 y ‾ i . \overline{y}_{i.} y i . 160 575 542 530 539 570 2756 551.2 180 565 593 590 579 610 2937 587.4 200 600 651 610 637 629 3127 625.4 220 725 700 715 685 710 3535 707.0 y . . = 12 , 355 y_{..} = 12{,}355 y .. = 12 , 355 y ‾ . . = 617.75 \overline{y}_{..} = 617.75 y .. = 617.75
我们将用方差分析检验 H 0 : μ 1 = μ 2 = μ 3 = μ 4 H_{0}:\mu_{1}=\mu_{2}=\mu_{3}=\mu_{4} H 0 : μ 1 = μ 2 = μ 3 = μ 4 H 1 H_{1} H 1
S S T = ∑ i = 1 4 ∑ j = 1 5 y i j 2 − y . . 2 N = ( 575 ) 2 + ( 542 ) 2 + ⋯ + ( 710 ) 2 − ( 12 , 355 ) 2 20 = 72 , 209.75 \begin{aligned}
SS_{T} &= \sum_{i=1}^{4}\sum_{j=1}^{5} y_{ij}^{2}-\frac{y_{..}^{2}}{N} \\
&= (575)^{2}+(542)^{2}+\cdots+(710)^{2}-\frac{(12{,}355)^{2}}{20} \\
&= 72{,}209.75
\end{aligned} S S T = i = 1 ∑ 4 j = 1 ∑ 5 y ij 2 − N y .. 2 = ( 575 ) 2 + ( 542 ) 2 + ⋯ + ( 710 ) 2 − 20 ( 12 , 355 ) 2 = 72 , 209.75 S S 处理 = 1 n ∑ i = 1 4 y i . 2 − y . . 2 N = 1 5 [ ( 2756 ) 2 + ⋯ + ( 3535 ) 2 ] − ( 12 , 355 ) 2 20 = 66 , 870.55 \begin{aligned}
SS_{\text{处理}} &= \frac{1}{n}\sum_{i=1}^{4} y_{i.}^{2}-\frac{y_{..}^{2}}{N} \\
&= \frac{1}{5}[(2756)^{2}+\cdots+(3535)^{2}]-\frac{(12{,}355)^{2}}{20} \\
&= 66{,}870.55
\end{aligned} S S 处理 = n 1 i = 1 ∑ 4 y i . 2 − N y .. 2 = 5 1 [( 2756 ) 2 + ⋯ + ( 3535 ) 2 ] − 20 ( 12 , 355 ) 2 = 66 , 870.55 S S E = S S T − S S 处理 = 72 , 209.75 − 66 , 870.55 = 5339.20 \begin{aligned}
SS_{E} &= SS_{T}-SS_{\text{处理}} \\
&= 72{,}209.75-66{,}870.55 = 5339.20
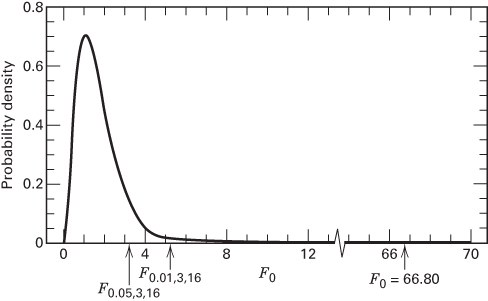
\end{aligned} S S E = S S T − S S 处理 = 72 , 209.75 − 66 , 870.55 = 5339.20 方差分析概括在表 3.4 中。注意 RF 功率(即处理之间)的均方(22 290.18)比处理内部(即误差)的均方(333.70)大许多倍。这表明处理均值相等的可能性不大。更形式化地说,我们可以计算 F F F F 0 = 22 , 290.18 / 333.70 = 66.80 F_{0}=22{,}290.18/333.70=66.80 F 0 = 22 , 290.18/333.70 = 66.80 F 3 , 16 F_{3,16} F 3 , 16 α = 0.05 \alpha=0.05 α = 0.05 F 0.05 , 3 , 16 = 3.24 F_{0.05,3,16}=3.24 F 0.05 , 3 , 16 = 3.24 F 0 = 66.80 > 3.24 F_{0}=66.80>3.24 F 0 = 66.80 > 3.24 H 0 H_{0} H 0 P P P F 0 F_{0} F 0 F 3 , 16 F_{3,16} F 3 , 16 P P P F 0.01 , 3 , 16 = 5.29 F_{0.01,3,16}=5.29 F 0.01 , 3 , 16 = 5.29 F 0 > 5.29 F_{0}>5.29 F 0 > 5.29 P P P P < 0.01 P<0.01 P < 0.01 P P P P = 2.88 × 1 0 − 9 P=2.88\times10^{-9} P = 2.88 × 1 0 − 9
表 3.4 等离子体刻蚀试验的方差分析
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 P P P RF 功率 66,870.55 3 22,290.18 F 0 = 66.80 F_{0} = 66.80 F 0 = 66.80 < 0.01 误差 5339.20 16 333.70 总计 72,209.75 19
图 3.3 例 3.1 中检验统计量 F 0 F_{0} F 0 F 3 , 16 F_{3,16} F 3 , 16
数据的编码。 一般地,我们不必太担心计算问题,因为有许多容易获得的计算机程序可以完成这些计算。这些计算机程序还有助于进行与试验设计相关的许多其他分析(例如残差分析和模型适合性检验)。在许多情况下,这些程序还会帮助试验者建立设计。
然而,当必须手算时,对观测值作编码 (coding)有时会有帮助。例 3.2 说明了这一点。
例 3.2 对观测值编码 ¶ 对观测值编码往往能使方差分析的计算更容易或更精确。例如,考虑例 3.1 中的等离子体刻蚀数据。假设我们从每个观测值中减去 600。编码后的数据见表 3.5。容易验证
S S T = ( − 25 ) 2 + ( − 58 ) 2 + ⋯ + ( 110 ) 2 − ( 355 ) 2 20 = 72 , 209.75 \begin{aligned}
SS_{T} &= (-25)^{2}+(-58)^{2}+\cdots+(110)^{2}-\frac{(355)^{2}}{20} \\
&= 72{,}209.75
\end{aligned} S S T = ( − 25 ) 2 + ( − 58 ) 2 + ⋯ + ( 110 ) 2 − 20 ( 355 ) 2 = 72 , 209.75 S S 处理 = ( − 244 ) 2 + ( − 63 ) 2 + ( 127 ) 2 + ( 535 ) 2 5 − ( 355 ) 2 20 = 66 , 870.55 \begin{aligned}
SS_{\text{处理}} &= \frac{(-244)^{2}+(-63)^{2}+(127)^{2}+(535)^{2}}{5}-\frac{(355)^{2}}{20} \\
&= 66{,}870.55
\end{aligned} S S 处理 = 5 ( − 244 ) 2 + ( − 63 ) 2 + ( 127 ) 2 + ( 535 ) 2 − 20 ( 355 ) 2 = 66 , 870.55 以及
S S E = 5339.20 SS_{E} = 5339.20 S S E = 5339.20 把这些平方和与例 3.1 中得到的结果相比较,可见从原始数据中减去一个常数并不改变平方和。
现在假设我们把例 3.1 中每个观测值都乘以 2。容易验证,变换后数据的平方和为 S S T = 288 , 839.00 SS_{T}=288{,}839.00 S S T = 288 , 839.00 S S 处理 = 267 , 482.20 SS_{\text{处理}}=267{,}482.20 S S 处理 = 267 , 482.20 S S E = 21 , 356.80 SS_{E}=21{,}356.80 S S E = 21 , 356.80 22 ),结果就完全相同。例如处理平方和 267 , 482.20 / 4 = 66 , 870.55 267{,}482.20/4=66{,}870.55 267 , 482.20/4 = 66 , 870.55 F F F F = ( 267 , 482.20 / 3 ) / ( 21 , 356.80 / 16 ) = 66.80 F=(267{,}482.20/3)/(21{,}356.80/16)=66.80 F = ( 267 , 482.20/3 ) / ( 21 , 356.80/16 ) = 66.80 F F F
表 3.5 例 3.2 编码后的刻蚀速率数据
RF 功率 (W) 观测值 1 2 3 4 5 合计 y i . y_{i.} y i . 160 -25 -58 -70 -61 -30 -244 180 -35 -7 -10 -21 10 -63 200 0 51 10 37 29 127 220 125 100 115 85 110 535
随机化检验与方差分析。 在建立方差分析 F F F ϵ i j \epsilon_{ij} ϵ ij F F F
处理 1 处理 2 y 11 y_{11} y 11 y 21 y_{21} y 21 y 12 y_{12} y 12 y 22 y_{22} y 22 y 13 y_{13} y 13 y 23 y_{23} y 23 y 14 y_{14} y 14 y 24 y_{24} y 24 y 15 y_{15} y 15 y 25 y_{25} y 25
我们可以用方差分析 F F F H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 10 ! / 5 ! 5 ! = 252 10!/5!5!=252 10 ! /5 ! 5 ! = 252 F F F F F F 随机化分布 (randomization distribution),F F F H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 F F F F F F α = 5 / 252 = 0.0198 \alpha=5/252=0.0198 α = 5/252 = 0.0198 H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2
这种做法的困难在于,即使对相对较小的问题,精确枚举随机化分布在计算上也是不可行的。然而,大量研究表明,精确的随机化分布可以用通常的正态理论 F F F F F F
3.3.3 模型参数的估计 ¶ 下面我们给出单因子模型
y i j = μ + τ i + ϵ i j y_{ij} = \mu+\tau_{i}+\epsilon_{ij} y ij = μ + τ i + ϵ ij 中各参数的估计量,以及处理均值的置信区间。稍后我们将证明,总均值和处理效应的合理估计由下式给出:
μ ^ = y ‾ . . τ ^ i = y ‾ i . − y ‾ . . , i = 1 , 2 , … , a (3.11) \begin{array}{l}
\hat{\mu} = \overline{y}_{..} \\
\hat{\tau}_{i} = \overline{y}_{i.}-\overline{y}_{..}, \quad i = 1, 2, \ldots, a
\end{array} \tag{3.11} μ ^ = y .. τ ^ i = y i . − y .. , i = 1 , 2 , … , a ( 3.11 ) 这些估计量有很强的直观吸引力;注意总均值由观测值的总平均来估计,而任一处理效应就是该处理平均与总平均之差。
第 i i i i i i
μ i = μ + τ i \mu_{i} = \mu+\tau_{i} μ i = μ + τ i μ i \mu_{i} μ i μ ^ i = μ ^ + τ ^ i = y ‾ i . \hat{\mu}_{i} = \hat{\mu}+\hat{\tau}_{i} = \overline{y}_{i.} μ ^ i = μ ^ + τ ^ i = y i . y ‾ i . \overline{y}_{i.} y i . N I D ( μ i , σ 2 / n ) \mathrm{NID}(\mu_{i},\sigma^{2}/n) NID ( μ i , σ 2 / n ) σ 2 \sigma^{2} σ 2 M S E MS_{E} M S E σ 2 \sigma^{2} σ 2 t t t i i i μ i \mu_{i} μ i 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
y ‾ i . − t α / 2 , N − a M S E n ≤ μ i ≤ y ‾ i . + t α / 2 , N − a M S E n (3.12) \overline{y}_{i.}-t_{\alpha/2, N-a}\sqrt{\frac{MS_{E}}{n}} \leq \mu_{i} \leq \overline{y}_{i.}+t_{\alpha/2, N-a}\sqrt{\frac{MS_{E}}{n}} \tag{3.12} y i . − t α /2 , N − a n M S E ≤ μ i ≤ y i . + t α /2 , N − a n M S E ( 3.12 ) 处理之间的差异往往具有很大的实际意义。任意两个处理均值之差(例如 μ i − μ j \mu_{i}-\mu_{j} μ i − μ j 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
y ‾ i . − y ‾ j . − t α / 2 , N − a 2 M S E n ≤ μ i − μ j ≤ y ‾ i . − y ‾ j . + t α / 2 , N − a 2 M S E n (3.13) \overline{y}_{i.}-\overline{y}_{j.}-t_{\alpha/2, N-a}\sqrt{\frac{2MS_{E}}{n}} \leq \mu_{i}-\mu_{j} \leq \overline{y}_{i.}-\overline{y}_{j.}+t_{\alpha/2, N-a}\sqrt{\frac{2MS_{E}}{n}} \tag{3.13} y i . − y j . − t α /2 , N − a n 2 M S E ≤ μ i − μ j ≤ y i . − y j . + t α /2 , N − a n 2 M S E ( 3.13 ) 例 3.3 ¶ 利用例 3.1 中的数据,我们可以求得总均值和处理效应的估计为 μ ^ = 12 , 355 / 20 = 617.75 \hat{\mu}=12{,}355/20=617.75 μ ^ = 12 , 355/20 = 617.75
τ ^ 1 = y ‾ 1. − y ‾ . . = 551.20 − 617.75 = − 66.55 τ ^ 2 = y ˉ 2. − y ˉ . . = 587.40 − 617.75 = − 30.35 τ ^ 3 = y ‾ 3. − y ‾ . . = 625.40 − 617.75 = 7.65 τ ^ 4 = y ‾ 4. − y ‾ . . = 707.00 − 617.75 = 89.25 \begin{aligned}
\hat{\tau}_{1} &= \overline{y}_{1.}-\overline{y}_{..} = 551.20-617.75 = -66.55 \\
\hat{\tau}_{2} &= \bar{y}_{2.}-\bar{y}_{..} = 587.40-617.75 = -30.35 \\
\hat{\tau}_{3} &= \overline{y}_{3.}-\overline{y}_{..} = 625.40-617.75 = 7.65 \\
\hat{\tau}_{4} &= \overline{y}_{4.}-\overline{y}_{..} = 707.00-617.75 = 89.25
\end{aligned} τ ^ 1 τ ^ 2 τ ^ 3 τ ^ 4 = y 1. − y .. = 551.20 − 617.75 = − 66.55 = y ˉ 2. − y ˉ .. = 587.40 − 617.75 = − 30.35 = y 3. − y .. = 625.40 − 617.75 = 7.65 = y 4. − y .. = 707.00 − 617.75 = 89.25 处理 4(RF 功率 220 W)均值的 95% 置信区间按式 3.12 计算:
707.00 − 2.120 333.70 5 ≤ μ 4 ≤ 707.00 + 2.120 333.70 5 707.00-2.120\sqrt{\frac{333.70}{5}} \leq \mu_{4} \leq 707.00+2.120\sqrt{\frac{333.70}{5}} 707.00 − 2.120 5 333.70 ≤ μ 4 ≤ 707.00 + 2.120 5 333.70 或
707.00 − 17.32 ≤ μ 4 ≤ 707.00 + 17.32 707.00-17.32 \leq \mu_{4} \leq 707.00+17.32 707.00 − 17.32 ≤ μ 4 ≤ 707.00 + 17.32 因此所求的 95% 置信区间为 689.68 ≤ μ 4 ≤ 724.32 689.68 \leq \mu_{4} \leq 724.32 689.68 ≤ μ 4 ≤ 724.32
同时置信区间。 式 3.12 和式 3.13 给出的置信区间表达式是一次一个 的置信区间。也就是说,置信水平 1 − α 1-\alpha 1 − α r r r 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) r r r 同时 正确的概率至少为 1 − r α 1-r\alpha 1 − r α r α r\alpha r α 试验误差率 或总置信系数 。r r r r = 5 r=5 r = 5 α = 0.05 \alpha=0.05 α = 0.05 r = 10 r=10 r = 10 α = 0.05 \alpha=0.05 α = 0.05
确保同时置信水平不过小的一种做法,是把一次一个置信区间公式(式 3.12 和式 3.13)中的 α / 2 \alpha/2 α /2 α / ( 2 r ) \alpha/(2r) α / ( 2 r ) Bonferroni 方法 ,它使试验者能够构造一组 r r r 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) r r r
3.3.4 非平衡数据 ¶ 在一些单因子试验中,每个处理下取的观测值个数可能不同,此时我们说设计是非平衡的 (unbalanced)。上述方差分析仍然可以使用,但平方和公式必须稍作修改。设在处理 i i i n i n_{i} n i i = 1 , 2 , … , a i = 1, 2, \ldots, a i = 1 , 2 , … , a N = ∑ i = 1 a n i N = \sum_{i=1}^{a} n_{i} N = ∑ i = 1 a n i S S T SS_{T} S S T S S 处理 SS_{\text{处理}} S S 处理
S S T = ∑ i = 1 a ∑ j = 1 n i y i j 2 − y . . 2 N (3.14) SS_{T} = \sum_{i=1}^{a}\sum_{j=1}^{n_{i}} y_{ij}^{2}-\frac{y_{..}^{2}}{N} \tag{3.14} S S T = i = 1 ∑ a j = 1 ∑ n i y ij 2 − N y .. 2 ( 3.14 ) 以及
S S 处理 = ∑ i = 1 a y i . 2 n i − y . . 2 N (3.15) SS_{\text{处理}} = \sum_{i=1}^{a}\frac{y_{i.}^{2}}{n_{i}}-\frac{y_{..}^{2}}{N} \tag{3.15} S S 处理 = i = 1 ∑ a n i y i . 2 − N y .. 2 ( 3.15 ) 方差分析中不需要其他改动。
选择平衡设计有两点好处。第一,若样本量相等,检验统计量对各处理等方差假定的轻微偏离相对不敏感;样本量不等时则不然。第二,若各样本大小相等,检验的功效最大。