3.5 结果的实用解释
在实施试验、完成统计分析并考察基本假定之后,试验者就可以就所研究的问题得出实用结论了。这往往相对容易,而且对目前所考虑的这类简单试验来说,或许可以不太正式地进行,例如通过检视图 3.1 和图 3.2 那样的箱线图和散点图。然而,在某些情况下需要应用更形式化的技术。本节介绍其中一些技术。
3.5.1 回归模型 ¶ 试验中涉及的因子可以是定量的 或定性的 。定量因子 是其水平可以与数值尺度上的点相联系的因子,例如温度、压力或时间。定性因子 则是其水平无法按大小顺序排列的因子。操作人员、原料批次和班次是典型的定性因子,因为没有理由按任何特定的数值顺序对它们排序。
就试验的初始设计与分析而言,两类因子的处理方式完全相同。试验者感兴趣的是确定因子各水平之间是否存在差异。事实上,方差分析把设计因子当作定性(即分类)变量来处理。如果因子确实是定性的(例如操作人员),那么考虑在该因子的某个中间水平上进行后续运行的响应就毫无意义。然而对于时间这样的定量因子,试验者通常关注所用取值的整个范围,特别是中间因子水平上后续运行的响应。也就是说,如果试验中使用了 1.0、2.0 和 3.0 小时这三个水平,我们可能希望预测 2.5 小时处的响应。因此,试验者常常希望为试验中的响应变量建立一个插值方程 。这个方程就是所研究过程的一个经验模型 。
拟合经验模型的一般方法称为回归分析 (regression analysis),第 10 章将详细讨论。也可参见本章的补充材料。本节用例 3.1 的刻蚀速率数据简要说明这一技术。
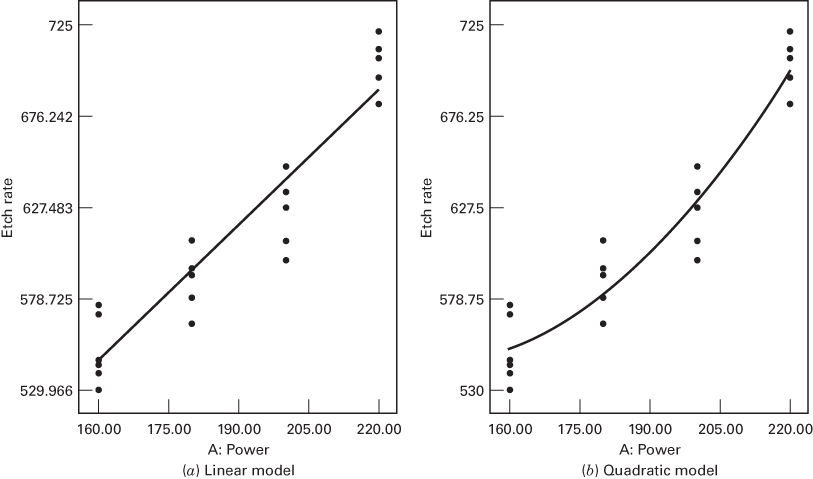
图 3.10 给出了例 3.1 试验中刻蚀速率 y y y x x x
y = β 0 + β 1 x + ϵ y = \beta_{0}+\beta_{1}x+\epsilon y = β 0 + β 1 x + ϵ 其中 β 0 \beta_{0} β 0 β 1 \beta_{1} β 1 ϵ \epsilon ϵ 最小二乘法 (method of least squares),即选择 β \beta β ϵ \epsilon ϵ
y ^ = 137.62 + 2.527 x \hat{y} = 137.62+2.527x y ^ = 137.62 + 2.527 x (如果你不熟悉回归方法,请参见第 10 章和本章补充材料。)
这一线性模型如图 3.10a 所示。在较高的功率设置下它似乎不太令人满意。或许在 x x x
y ^ = 1147.77 − 8.2555 x + 0.028375 x 2 \hat{y} = 1147.77-8.2555x+0.028375x^{2} y ^ = 1147.77 − 8.2555 x + 0.028375 x 2 这一二次拟合如图 3.10b 所示。二次模型看来优于线性模型,因为它在较高功率设置处给出了更好的拟合。
一般地,我们希望拟合能充分描述系统或过程的最低阶多项式。在本例中,二次多项式似乎比线性模型拟合得更好,因此二次模型额外的复杂性是有道理的。然而,选择逼近多项式的阶数并不总是容易的,而且比较容易过拟合 ,也就是说,加入并不能真正改善拟合的高阶多项式项,反而增加了模型的复杂性,并常常损害它作为预测或插值方程的实用性。
在本例中,经验模型可以用来预测试验区域内各功率设置下的刻蚀速率。在另一些情况下,经验模型可以用来进行过程最优化 ,即找出使响应达到最好值的设计变量水平。这些问题的讨论和示例将在本书后面展开。
图 3.10 例 3.1 刻蚀速率数据的散点图与回归模型
3.5.2 处理均值之间的比较 ¶ 假设对固定效应模型作方差分析时原假设被拒绝。这样我们就知道处理均值之间存在差异,但究竟哪些均值不同并未明确指出。在这种情形下,有时对处理均值做进一步的比较和分组分析可能有用。第 i i i μ i = μ + τ i \mu_{i} = \mu+\tau_{i} μ i = μ + τ i μ i \mu_{i} μ i y ‾ i . \overline{y}_{i.} y i . { y i . } \{y_{i.}\} { y i . } { y ‾ i . } \{\overline{y}_{i.}\} { y i . } 多重比较方法 (multiple comparison methods)。下面几节讨论对各个处理均值或若干组处理均值进行比较的方法。
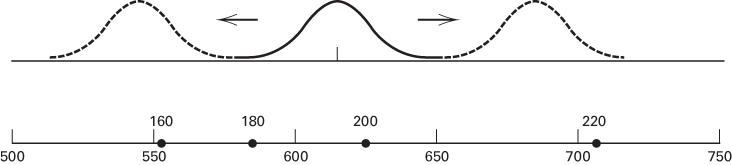
3.5.3 均值的图形比较 ¶ 在方差分析之后,构造一个用于比较均值的图形程序非常容易。假设所关注的因子有 a a a y ‾ 1. , y ‾ 2. , … , y ‾ a . \overline{y}_{1.},\overline{y}_{2.},\ldots,\overline{y}_{a.} y 1. , y 2. , … , y a . σ \sigma σ σ / n \sigma/\sqrt{n} σ / n y ‾ i . \overline{y}_{i.} y i . y ‾ i . \overline{y}_{i.} y i . σ / n \sigma/\sqrt{n} σ / n y ‾ 1. , y ‾ 2. , … , y ‾ a . \overline{y}_{1.},\overline{y}_{2.},\ldots,\overline{y}_{a.} y 1. , y 2. , … , y a . y ‾ i . \overline{y}_{i.} y i . y ‾ i . \overline{y}_{i.} y i .
这一逻辑唯一的缺陷是 σ \sigma σ M S E \sqrt{MS_{E}} M S E σ \sigma σ M S E / n \sqrt{MS_{E}/n} M S E / n t t t t t t
要勾画出图 3.11 中的 t t t t t t
M S E / n = 330.70 / 5 = 8.13 \sqrt{MS_{E}/n} = \sqrt{330.70/5} = 8.13 M S E / n = 330.70/5 = 8.13 并把该点处 t t t [1] t t t t t t y ‾ i . \overline{y}_{i.} y i .
现在设想把图 3.11 中的 t t t μ 1 ≠ μ 2 ≠ μ 3 ≠ μ 4 \mu_{1} \neq \mu_{2} \neq \mu_{3} \neq \mu_{4} μ 1 = μ 2 = μ 3 = μ 4
对许多多重比较问题来说,这个简单的程序是一种粗略但有效的技术。不过还有更形式化的方法,下面简要讨论其中的一些。
图 3.11 例 3.1 的刻蚀速率平均值与尺度因子为 M S E / n = 330.70 / 5 = 8.13 \sqrt{MS_{E}/n}=\sqrt{330.70/5}=8.13 M S E / n = 330.70/5 = 8.13 t t t
3.5.4 对照 ¶ 许多多重比较方法都用到对照 (contrast)的概念。考虑例 3.1 的等离子体刻蚀试验。由于原假设被拒绝,我们知道某些功率设置产生的刻蚀速率与另一些不同,但究竟是哪些造成了这一差异?我们可能在试验一开始就怀疑 200 W 与 220 W 产生相同的刻蚀速率,这意味着我们希望检验假设
H 0 : μ 3 = μ 4 H 1 : μ 3 ≠ μ 4 \begin{array}{l}
H_{0}: \mu_{3} = \mu_{4} \\
H_{1}: \mu_{3} \neq \mu_{4}
\end{array} H 0 : μ 3 = μ 4 H 1 : μ 3 = μ 4 或等价地
H 0 : μ 3 − μ 4 = 0 H 1 : μ 3 − μ 4 ≠ 0 (3.23) \begin{array}{l}
H_{0}: \mu_{3}-\mu_{4} = 0 \\
H_{1}: \mu_{3}-\mu_{4} \neq 0
\end{array} \tag{3.23} H 0 : μ 3 − μ 4 = 0 H 1 : μ 3 − μ 4 = 0 ( 3.23 ) 如果我们在试验开始时怀疑最低功率水平的平均与最高功率水平的平均没有差异,那么假设应是
H 0 : μ 1 + μ 2 = μ 3 + μ 4 H 1 : μ 1 + μ 2 ≠ μ 3 + μ 4 \begin{array}{l}
H_{0}: \mu_{1}+\mu_{2} = \mu_{3}+\mu_{4} \\
H_{1}: \mu_{1}+\mu_{2} \neq \mu_{3}+\mu_{4}
\end{array} H 0 : μ 1 + μ 2 = μ 3 + μ 4 H 1 : μ 1 + μ 2 = μ 3 + μ 4 或
H 0 : μ 1 + μ 2 − μ 3 − μ 4 = 0 H 1 : μ 1 + μ 2 − μ 3 − μ 4 ≠ 0 (3.24) \begin{array}{l}
H_{0}: \mu_{1}+\mu_{2}-\mu_{3}-\mu_{4} = 0 \\
H_{1}: \mu_{1}+\mu_{2}-\mu_{3}-\mu_{4} \neq 0
\end{array} \tag{3.24} H 0 : μ 1 + μ 2 − μ 3 − μ 4 = 0 H 1 : μ 1 + μ 2 − μ 3 − μ 4 = 0 ( 3.24 ) 一般地,对照 是形如
Γ = ∑ i = 1 a c i μ i \Gamma = \sum_{i=1}^{a} c_{i}\mu_{i} Γ = i = 1 ∑ a c i μ i 的参数线性组合,其中对照常数 c 1 , c 2 , … , c a c_{1}, c_{2}, \ldots, c_{a} c 1 , c 2 , … , c a ∑ i = 1 a c i = 0 \sum_{i=1}^{a} c_{i} = 0 ∑ i = 1 a c i = 0
H 0 : ∑ i = 1 a c i μ i = 0 H 1 : ∑ i = 1 a c i μ i ≠ 0 (3.25) \begin{array}{l}
H_{0}: \sum_{i=1}^{a} c_{i}\mu_{i} = 0 \\
H_{1}: \sum_{i=1}^{a} c_{i}\mu_{i} \neq 0
\end{array} \tag{3.25} H 0 : ∑ i = 1 a c i μ i = 0 H 1 : ∑ i = 1 a c i μ i = 0 ( 3.25 ) 式 3.23 中假设的对照常数为 c 1 = c 2 = 0 c_{1}=c_{2}=0 c 1 = c 2 = 0 c 3 = + 1 c_{3}=+1 c 3 = + 1 c 4 = − 1 c_{4}=-1 c 4 = − 1 c 1 = c 2 = + 1 c_{1}=c_{2}=+1 c 1 = c 2 = + 1 c 3 = c 4 = − 1 c_{3}=c_{4}=-1 c 3 = c 4 = − 1
检验涉及对照的假设有两种基本做法。第一种做法使用 t t t
C = ∑ i = 1 a c i y ‾ i . C = \sum_{i=1}^{a} c_{i}\overline{y}_{i.} C = i = 1 ∑ a c i y i . 当各处理的样本量相等时,C C C
V ( C ) = σ 2 n ∑ i = 1 a c i 2 (3.26) V(C) = \frac{\sigma^{2}}{n}\sum_{i=1}^{a} c_{i}^{2} \tag{3.26} V ( C ) = n σ 2 i = 1 ∑ a c i 2 ( 3.26 ) 如果式 3.25 中的原假设为真,则比值
∑ i = 1 a c i y ‾ i . σ 2 n ∑ i = 1 a c i 2 \frac{\sum_{i=1}^{a} c_{i}\overline{y}_{i.}}{\sqrt{\frac{\sigma^{2}}{n}\sum_{i=1}^{a} c_{i}^{2}}} n σ 2 ∑ i = 1 a c i 2 ∑ i = 1 a c i y i . 服从 N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) σ 2 \sigma^{2} σ 2 M S E MS_{E} M S E
t 0 = ∑ i = 1 a c i y ‾ i . M S E n ∑ i = 1 a c i 2 (3.27) t_{0} = \frac{\sum_{i=1}^{a} c_{i}\overline{y}_{i.}}{\sqrt{\frac{MS_{E}}{n}\sum_{i=1}^{a} c_{i}^{2}}} \tag{3.27} t 0 = n M S E ∑ i = 1 a c i 2 ∑ i = 1 a c i y i . ( 3.27 ) 来检验式 3.25 中的假设。若式 3.27 中的 ∣ t 0 ∣ |t_{0}| ∣ t 0 ∣ t α / 2 , N − a t_{\alpha/2,N-a} t α /2 , N − a
第二种做法使用 F F F v v v t t t v v v F F F
F 0 = t 0 2 = ( ∑ i = 1 a c i y ‾ i . ) 2 M S E n ∑ i = 1 a c i 2 (3.28) F_{0} = t_{0}^{2} = \frac{\left(\sum_{i=1}^{a} c_{i}\overline{y}_{i.}\right)^{2}}{\frac{MS_{E}}{n}\sum_{i=1}^{a} c_{i}^{2}} \tag{3.28} F 0 = t 0 2 = n M S E ∑ i = 1 a c i 2 ( ∑ i = 1 a c i y i . ) 2 ( 3.28 ) 作为检验式 3.25 的 F F F F 0 > F α , 1 , N − a F_{0} > F_{\alpha,1,N-a} F 0 > F α , 1 , N − a
F 0 = M S C M S E = S S C / 1 M S E F_{0} = \frac{MS_{C}}{MS_{E}} = \frac{SS_{C}/1}{MS_{E}} F 0 = M S E M S C = M S E S S C /1 其中单自由度的对照平方和 为
S S C = ( ∑ i = 1 a c i y ‾ i . ) 2 1 n ∑ i = 1 a c i 2 (3.29) SS_{C} = \frac{\left(\sum_{i=1}^{a} c_{i}\overline{y}_{i.}\right)^{2}}{\frac{1}{n}\sum_{i=1}^{a} c_{i}^{2}} \tag{3.29} S S C = n 1 ∑ i = 1 a c i 2 ( ∑ i = 1 a c i y i . ) 2 ( 3.29 ) 对照的置信区间。 与检验关于对照的假设相比,构造置信区间有时更有用。设所关注的对照为
Γ = ∑ i = 1 a c i μ i \Gamma = \sum_{i=1}^{a} c_{i}\mu_{i} Γ = i = 1 ∑ a c i μ i 把处理均值换成处理平均,得到
C = ∑ i = 1 a c i y ‾ i . C = \sum_{i=1}^{a} c_{i}\overline{y}_{i.} C = i = 1 ∑ a c i y i . 因为
E ( ∑ i = 1 a c i y ˉ i . ) = ∑ i = 1 a c i μ i 且 V ( C ) = σ 2 / n ∑ i = 1 a c i 2 E\left(\sum_{i=1}^{a} c_{i}\bar{y}_{i.}\right) = \sum_{i=1}^{a} c_{i}\mu_{i} \quad \text{且} \quad V(C) = \sigma^{2}/n\sum_{i=1}^{a} c_{i}^{2} E ( i = 1 ∑ a c i y ˉ i . ) = i = 1 ∑ a c i μ i 且 V ( C ) = σ 2 / n i = 1 ∑ a c i 2 所以对照 ∑ i = 1 a c i μ i \sum_{i=1}^{a} c_{i}\mu_{i} ∑ i = 1 a c i μ i 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
∑ i = 1 a c i y ‾ i . − t α / 2 , N − a M S E n ∑ i = 1 a c i 2 ≤ ∑ i = 1 a c i μ i ≤ ∑ i = 1 a c i y ‾ i . + t α / 2 , N − a M S E n ∑ i = 1 a c i 2 (3.30) \sum_{i=1}^{a} c_{i}\overline{y}_{i.}-t_{\alpha/2,N-a}\sqrt{\frac{MS_{E}}{n}\sum_{i=1}^{a} c_{i}^{2}} \leq \sum_{i=1}^{a} c_{i}\mu_{i} \leq \sum_{i=1}^{a} c_{i}\overline{y}_{i.}+t_{\alpha/2,N-a}\sqrt{\frac{MS_{E}}{n}\sum_{i=1}^{a} c_{i}^{2}} \tag{3.30} i = 1 ∑ a c i y i . − t α /2 , N − a n M S E i = 1 ∑ a c i 2 ≤ i = 1 ∑ a c i μ i ≤ i = 1 ∑ a c i y i . + t α /2 , N − a n M S E i = 1 ∑ a c i 2 ( 3.30 ) 注意我们用 M S E MS_{E} M S E σ 2 \sigma^{2} σ 2
标准化对照。 当关注的对照多于一个时,把它们放在同一尺度上评价往往很有用。一种做法是把对照标准化,使其方差为 σ 2 \sigma^{2} σ 2 ∑ i = 1 a c i μ i \sum_{i=1}^{a} c_{i}\mu_{i} ∑ i = 1 a c i μ i ∑ i = 1 a c i y ‾ i . \sum_{i=1}^{a} c_{i}\overline{y}_{i.} ∑ i = 1 a c i y i . ( 1 / n ) ∑ i = 1 a c i 2 \sqrt{(1/n)\sum_{i=1}^{a} c_{i}^{2}} ( 1/ n ) ∑ i = 1 a c i 2 σ 2 \sigma^{2} σ 2 标准化对照 。于是标准化对照实际上就是
∑ i = 1 a c i ∗ y ‾ i . \sum_{i=1}^{a} c_{i}^{*}\overline{y}_{i.} i = 1 ∑ a c i ∗ y i . 其中
c i ∗ = c i 1 n ∑ i = 1 a c i 2 c_{i}^{*} = \frac{c_{i}}{\sqrt{\frac{1}{n}\sum_{i=1}^{a} c_{i}^{2}}} c i ∗ = n 1 ∑ i = 1 a c i 2 c i 样本量不等。 当各处理的样本量不同时,上述结果要作少许修改。首先注意,对照的定义现在要求
∑ i = 1 a n i c i = 0 \sum_{i=1}^{a} n_{i}c_{i} = 0 i = 1 ∑ a n i c i = 0 其他需要的改动都很直接。例如,式 3.27 中的 t t t
t 0 = ∑ i = 1 a c i y ‾ i . M S E ∑ i = 1 a c i 2 n i t_{0} = \frac{\sum_{i=1}^{a} c_{i}\overline{y}_{i.}}{\sqrt{MS_{E}\sum_{i=1}^{a}\frac{c_{i}^{2}}{n_{i}}}} t 0 = M S E ∑ i = 1 a n i c i 2 ∑ i = 1 a c i y i . 而式 3.29 的对照平方和变为
S S C = ( ∑ i = 1 a c i y ‾ i . ) 2 ∑ i = 1 a c i 2 n i SS_{C} = \frac{\left(\sum_{i=1}^{a} c_{i}\overline{y}_{i.}\right)^{2}}{\sum_{i=1}^{a}\frac{c_{i}^{2}}{n_{i}}} S S C = ∑ i = 1 a n i c i 2 ( ∑ i = 1 a c i y i . ) 2 3.5.5 正交对照 ¶ 3.5.4 节程序的一个有用的特例是正交对照 (orthogonal contrasts)。系数为 { c i } \{c_{i}\} { c i } { d i } \{d_{i}\} { d i }
∑ i = 1 a c i d i = 0 \sum_{i=1}^{a} c_{i}d_{i} = 0 i = 1 ∑ a c i d i = 0 或者对非平衡设计,如果
∑ i = 1 a c i d i / n i = 0 \sum_{i=1}^{a} c_{i}d_{i}/n_{i} = 0 i = 1 ∑ a c i d i / n i = 0 对 a a a a − 1 a-1 a − 1 a − 1 a-1 a − 1
为一组处理选择正交对照系数有许多方式。通常,试验本身的性质应当提示哪些比较是值得关注的。例如,若有 a = 3 a=3 a = 3
处理 正交对照系数 1(对照) -2 0 2(水平 1) 1 -1 3(水平 2) 1 1
注意系数为 c i = − 2 , 1 , 1 c_{i} = -2, 1, 1 c i = − 2 , 1 , 1 d i = 0 , − 1 , 1 d_{i} = 0, -1, 1 d i = 0 , − 1 , 1
一般地,对照(或正交对照)方法对所谓的预先计划的比较 (preplanned comparisons)很有用。也就是说,对照是在实施试验和考察数据之前就确定好的。原因是:如果在考察数据之后才选择比较,大多数试验者都会构造对应于所观测到的较大均值差异的检验。这些较大差异可能来自真实效应的存在,也可能来自随机误差。如果试验者总是挑最大的差异来比较,就会放大检验的第 I 类错误,因为在所选择的比较中,观测差异由误差造成的比例很可能会异常高。考察数据以挑选可能关注的比较,通常称为数据窥探 (data snooping)。下一节讨论的用于所有比较的 Scheffé 方法 允许数据窥探。
例 3.6 ¶ 考虑例 3.1 的等离子体刻蚀试验。共有四个处理均值,处理之间有 3 个自由度。假设在实施试验之前就确定了下面这组处理均值之间的比较(以及相应的对照):
假设 对照 H 0 : μ 1 = μ 2 H_{0}: \mu_{1} = \mu_{2} H 0 : μ 1 = μ 2 C 1 = y ‾ 1. − y ‾ 2. C_{1} = \overline{y}_{1.}-\overline{y}_{2.} C 1 = y 1. − y 2. H 0 : μ 1 + μ 2 = μ 3 + μ 4 H_{0}: \mu_{1}+\mu_{2} = \mu_{3}+\mu_{4} H 0 : μ 1 + μ 2 = μ 3 + μ 4 C 2 = y ‾ 1. + y ‾ 2. − y ‾ 3. − y ‾ 4. C_{2} = \overline{y}_{1.}+\overline{y}_{2.}-\overline{y}_{3.}-\overline{y}_{4.} C 2 = y 1. + y 2. − y 3. − y 4. H 0 : μ 3 = μ 4 H_{0}: \mu_{3} = \mu_{4} H 0 : μ 3 = μ 4 C 3 = y ‾ 3. − y ‾ 4. C_{3} = \overline{y}_{3.}-\overline{y}_{4.} C 3 = y 3. − y 4.
注意这些对照系数是正交的。利用表 3.4 中的数据,我们求得各对照的数值以及平方和如下:
C 1 = + 1 ( 551.2 ) − 1 ( 587.4 ) = − 36.2 C_{1} = +1(551.2)-1(587.4) = -36.2 C 1 = + 1 ( 551.2 ) − 1 ( 587.4 ) = − 36.2 S S C 1 = ( − 36.2 ) 2 1 5 ( 2 ) = 3276.10 SS_{C_{1}} = \frac{(-36.2)^{2}}{\frac{1}{5}(2)} = 3276.10 S S C 1 = 5 1 ( 2 ) ( − 36.2 ) 2 = 3276.10 C 2 = + 1 ( 551.2 ) + 1 ( 587.4 ) − 1 ( 625.4 ) − 1 ( 707.0 ) = − 193.8 C_{2} = \begin{array}{l} +1(551.2)+1(587.4) \\ -1(625.4)-1(707.0) \end{array} = -193.8 C 2 = + 1 ( 551.2 ) + 1 ( 587.4 ) − 1 ( 625.4 ) − 1 ( 707.0 ) = − 193.8 S S C 2 = ( − 193.8 ) 2 1 5 ( 4 ) = 46 , 948.05 SS_{C_{2}} = \frac{(-193.8)^{2}}{\frac{1}{5}(4)} = 46{,}948.05 S S C 2 = 5 1 ( 4 ) ( − 193.8 ) 2 = 46 , 948.05 C 3 = + 1 ( 625.4 ) − 1 ( 707.0 ) = − 81.6 C_{3} = +1(625.4)-1(707.0) = -81.6 C 3 = + 1 ( 625.4 ) − 1 ( 707.0 ) = − 81.6 S S C 3 = ( − 81.6 ) 2 1 5 ( 2 ) = 16 , 646.40 SS_{C_{3}} = \frac{(-81.6)^{2}}{\frac{1}{5}(2)} = 16{,}646.40 S S C 3 = 5 1 ( 2 ) ( − 81.6 ) 2 = 16 , 646.40 这些对照平方和完全分解了处理平方和。对这些正交对照的检验通常并入方差分析,如表 3.11 所示。由 P P P α = 0.05 \alpha=0.05 α = 0.05
表 3.11 等离子体刻蚀试验的方差分析
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 P P P 功率设置 66,870.55 3 22,290.18 66.80 < 0.001 正交对照 C 1 : μ 1 = μ 2 C_{1}: \mu_{1} = \mu_{2} C 1 : μ 1 = μ 2 (3276.10) 1 3276.10 9.82 < 0.01 C 2 : μ 1 + μ 2 = μ 3 + μ 4 C_{2}: \mu_{1}+\mu_{2} = \mu_{3}+\mu_{4} C 2 : μ 1 + μ 2 = μ 3 + μ 4 (46,948.05) 1 46,948.05 140.69 < 0.001 C 3 : μ 3 = μ 4 C_{3}: \mu_{3} = \mu_{4} C 3 : μ 3 = μ 4 (16,646.40) 1 16,646.40 49.88 < 0.001 误差 5,339.20 16 333.70 总计 72,209.75 19
3.5.6 比较所有对照的 Scheffé 方法 ¶ 在许多情形下,试验者可能事先并不知道希望比较哪些对照,或者关注的比较可能多于 a − 1 a-1 a − 1 α \alpha α
假设已确定了一组 m m m
Γ u = c 1 u μ 1 + c 2 u μ 2 + ⋯ + c a u μ a u = 1 , 2 , … , m (3.31) \Gamma_{u} = c_{1u}\mu_{1}+c_{2u}\mu_{2}+\cdots+c_{au}\mu_{a} \quad u = 1, 2, \ldots, m \tag{3.31} Γ u = c 1 u μ 1 + c 2 u μ 2 + ⋯ + c a u μ a u = 1 , 2 , … , m ( 3.31 ) 相应的处理平均的对照为
C u = c 1 u y ‾ 1. + c 2 u y ‾ 2. + ⋯ + c a u y ‾ a . u = 1 , 2 , … , m (3.32) C_{u} = c_{1u}\overline{y}_{1.}+c_{2u}\overline{y}_{2.}+\cdots+c_{au}\overline{y}_{a.} \quad u = 1, 2, \ldots, m \tag{3.32} C u = c 1 u y 1. + c 2 u y 2. + ⋯ + c a u y a . u = 1 , 2 , … , m ( 3.32 ) 该对照的标准误为
S C u = M S E ∑ i = 1 a ( c i u 2 / n i ) (3.33) S_{C_{u}} = \sqrt{MS_{E}\sum_{i=1}^{a} (c_{iu}^{2}/n_{i})} \tag{3.33} S C u = M S E i = 1 ∑ a ( c i u 2 / n i ) ( 3.33 ) 其中 n i n_{i} n i i i i C u C_{u} C u
S α , u = S C u ( a − 1 ) F α , a − 1 , N − a (3.34) S_{\alpha,u} = S_{C_{u}}\sqrt{(a-1)F_{\alpha,a-1,N-a}} \tag{3.34} S α , u = S C u ( a − 1 ) F α , a − 1 , N − a ( 3.34 ) 要检验对照 Γ u \Gamma_{u} Γ u C u C_{u} C u ∣ C u ∣ > S α , u |C_{u}| > S_{\alpha,u} ∣ C u ∣ > S α , u Γ u \Gamma_{u} Γ u
Scheffé 程序也可以用来构造处理均值之间所有可能对照的置信区间。所得到的区间,即 C u − S α , u ≤ Γ u ≤ C u + S α , u C_{u}-S_{\alpha,u} \leq \Gamma_{u} \leq C_{u}+S_{\alpha,u} C u − S α , u ≤ Γ u ≤ C u + S α , u 同时置信区间 ,因为所有这些区间同时成立的概率至少为 1 − α 1-\alpha 1 − α
为说明这一程序,考虑例 3.1 中的数据,假设关注的对照为
Γ 1 = μ 1 + μ 2 − μ 3 − μ 4 \Gamma_{1} = \mu_{1}+\mu_{2}-\mu_{3}-\mu_{4} Γ 1 = μ 1 + μ 2 − μ 3 − μ 4 和
Γ 2 = μ 1 − μ 4 \Gamma_{2} = \mu_{1}-\mu_{4} Γ 2 = μ 1 − μ 4 这些对照的数值为
C 1 = y ‾ 1. + y ‾ 2. − y ‾ 3. − y ‾ 4. = 551.2 + 587.4 − 625.4 − 707.0 = − 193.80 \begin{aligned}
C_{1} &= \overline{y}_{1.}+\overline{y}_{2.}-\overline{y}_{3.}-\overline{y}_{4.} \\
&= 551.2+587.4-625.4-707.0 = -193.80
\end{aligned} C 1 = y 1. + y 2. − y 3. − y 4. = 551.2 + 587.4 − 625.4 − 707.0 = − 193.80 和
C 2 = y ‾ 1. − y ‾ 4. = 551.2 − 707.0 = − 155.8 \begin{aligned}
C_{2} &= \overline{y}_{1.}-\overline{y}_{4.} \\
&= 551.2-707.0 = -155.8
\end{aligned} C 2 = y 1. − y 4. = 551.2 − 707.0 = − 155.8 由式 3.33 求得标准误为
S C 1 = M S E ∑ i = 1 5 ( c i 1 2 / n i ) = 333.70 ( 1 + 1 + 1 + 1 ) / 5 = 16.34 S_{C_{1}} = \sqrt{MS_{E}\sum_{i=1}^{5} (c_{i1}^{2}/n_{i})} = \sqrt{333.70(1+1+1+1)/5} = 16.34 S C 1 = M S E i = 1 ∑ 5 ( c i 1 2 / n i ) = 333.70 ( 1 + 1 + 1 + 1 ) /5 = 16.34 和
S C 2 = M S E ∑ i = 1 5 ( c i 2 2 / n i ) = 333.70 ( 1 + 1 ) / 5 = 11.55 S_{C_{2}} = \sqrt{MS_{E}\sum_{i=1}^{5} (c_{i2}^{2}/n_{i})} = \sqrt{333.70(1+1)/5} = 11.55 S C 2 = M S E i = 1 ∑ 5 ( c i 2 2 / n i ) = 333.70 ( 1 + 1 ) /5 = 11.55 由式 3.34,1% 的临界值为
S 0.01 , 1 = S C 1 ( a − 1 ) F 0.01 , a − 1 , N − a = 16.34 3 ( 5.29 ) = 65.09 S_{0.01,1} = S_{C_{1}}\sqrt{(a-1)F_{0.01,a-1,N-a}} = 16.34\sqrt{3(5.29)} = 65.09 S 0.01 , 1 = S C 1 ( a − 1 ) F 0.01 , a − 1 , N − a = 16.34 3 ( 5.29 ) = 65.09 和
S 0.01 , 2 = S C 2 ( a − 1 ) F 0.01 , a − 1 , N − a = 11.55 3 ( 5.29 ) = 45.97 S_{0.01,2} = S_{C_{2}}\sqrt{(a-1)F_{0.01,a-1,N-a}} = 11.55\sqrt{3(5.29)} = 45.97 S 0.01 , 2 = S C 2 ( a − 1 ) F 0.01 , a − 1 , N − a = 11.55 3 ( 5.29 ) = 45.97 因为 ∣ C 1 ∣ > S 0.01 , 1 |C_{1}| > S_{0.01,1} ∣ C 1 ∣ > S 0.01 , 1 Γ 1 = μ 1 + μ 2 − μ 3 − μ 4 \Gamma_{1} = \mu_{1}+\mu_{2}-\mu_{3}-\mu_{4} Γ 1 = μ 1 + μ 2 − μ 3 − μ 4 ∣ C 2 ∣ > S 0.01 , 2 |C_{2}| > S_{0.01,2} ∣ C 2 ∣ > S 0.01 , 2 Γ 2 = μ 1 − μ 4 \Gamma_{2} = \mu_{1}-\mu_{4} Γ 2 = μ 1 − μ 4
3.5.7 处理均值对的比较 ¶ 在许多实际情形中,我们只希望比较各对均值。我们常常可以通过检验所有处理均值对之间的差异来确定哪些均值不同。因此,我们关注的是形如 Γ = μ i − μ j \Gamma = \mu_{i}-\mu_{j} Γ = μ i − μ j i ≠ j i \neq j i = j a a a
假设我们关注 a a a H 0 : μ i = μ j H_{0}: \mu_{i} = \mu_{j} H 0 : μ i = μ j i ≠ j i \neq j i = j
Tukey 检验。 假设在一次拒绝了处理均值相等这一原假设的方差分析之后,我们希望检验所有两两均值比较:
H 0 : μ i = μ j H 1 : μ i ≠ μ j \begin{array}{l}
H_{0}: \mu_{i} = \mu_{j} \\
H_{1}: \mu_{i} \neq \mu_{j}
\end{array} H 0 : μ i = μ j H 1 : μ i = μ j 对所有 i ≠ j i \neq j i = j α \alpha α α \alpha α 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) α \alpha α
Tukey 程序使用学生化极差统计量 (studentized range statistic)的分布
q = y ‾ max − y ‾ min M S E / n q = \frac{\overline{y}_{\max}-\overline{y}_{\min}}{\sqrt{MS_{E}/n}} q = M S E / n y m a x − y m i n 其中 y ‾ max \overline{y}_{\max} y m a x y ‾ min \overline{y}_{\min} y m i n p p p q α ( p , f ) q_{\alpha}(p,f) q α ( p , f ) q q q α \alpha α f f f M S E MS_{E} M S E
T α = q α ( a , f ) M S E n (3.35) T_{\alpha} = q_{\alpha}(a,f)\sqrt{\frac{MS_{E}}{n}} \tag{3.35} T α = q α ( a , f ) n M S E ( 3.35 ) Tukey 检验就判定这两个均值显著不同。等价地,我们可以按如下方式构造所有均值对的 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
y ‾ i . − y ‾ j . − q α ( a , f ) M S E n ≤ μ i − μ j ≤ y ‾ i . − y ‾ j . + q α ( a , f ) M S E n , i ≠ j . (3.36) \begin{aligned}
&\overline{y}_{i.}-\overline{y}_{j.}-q_{\alpha}(a,f)\sqrt{\frac{MS_{E}}{n}} \leq \mu_{i}-\mu_{j} \\
&\qquad \leq \overline{y}_{i.}-\overline{y}_{j.}+q_{\alpha}(a,f)\sqrt{\frac{MS_{E}}{n}}, \; i \neq j.
\end{aligned} \tag{3.36} y i . − y j . − q α ( a , f ) n M S E ≤ μ i − μ j ≤ y i . − y j . + q α ( a , f ) n M S E , i = j . ( 3.36 ) 当样本量不相等时,式 3.35 和式 3.36 分别变为
T α = q α ( a , f ) 2 M S E ( 1 n i + 1 n j ) (3.37) T_{\alpha} = \frac{q_{\alpha}(a,f)}{\sqrt{2}}\sqrt{MS_{E}\left(\frac{1}{n_{i}}+\frac{1}{n_{j}}\right)} \tag{3.37} T α = 2 q α ( a , f ) M S E ( n i 1 + n j 1 ) ( 3.37 ) 和
y ‾ i . − y ‾ j . − q α ( a , f ) 2 M S E ( 1 n i + 1 n j ) ≤ μ i − μ j ≤ y ‾ i . − y ‾ j . + q α ( a , f ) 2 M S E ( 1 n i + 1 n j ) , i ≠ j (3.38) \begin{aligned}
&\overline{y}_{i.}-\overline{y}_{j.}-\frac{q_{\alpha}(a,f)}{\sqrt{2}}\sqrt{MS_{E}\left(\frac{1}{n_{i}}+\frac{1}{n_{j}}\right)} \leq \mu_{i}-\mu_{j} \\
&\qquad \leq \overline{y}_{i.}-\overline{y}_{j.}+\frac{q_{\alpha}(a,f)}{\sqrt{2}}\sqrt{MS_{E}\left(\frac{1}{n_{i}}+\frac{1}{n_{j}}\right)}, \; i \neq j
\end{aligned} \tag{3.38} y i . − y j . − 2 q α ( a , f ) M S E ( n i 1 + n j 1 ) ≤ μ i − μ j ≤ y i . − y j . + 2 q α ( a , f ) M S E ( n i 1 + n j 1 ) , i = j ( 3.38 ) 样本量不等的版本有时称为 Tukey–Kramer 程序 。
式 3.36 中 Tukey 置信区间的推导对等样本量而言很直接。对学生化极差统计量 q q q
P ( max ( y ‾ i . − μ i ) − min ( y ‾ i . − μ i ) M S E / n ≤ q α ( a , f ) ) = 1 − α P\left(\frac{\max(\overline{y}_{i.}-\mu_{i})-\min(\overline{y}_{i.}-\mu_{i})}{\sqrt{MS_{E}/n}} \leq q_{\alpha}(a,f)\right) = 1-\alpha P ( M S E / n max ( y i . − μ i ) − min ( y i . − μ i ) ≤ q α ( a , f ) ) = 1 − α 若 max ( y ‾ i . − μ i ) − min ( y ‾ i . − μ i ) \max(\overline{y}_{i.}-\mu_{i})-\min(\overline{y}_{i.}-\mu_{i}) max ( y i . − μ i ) − min ( y i . − μ i ) q α ( a , f ) M S E / n q_{\alpha}(a,f)\sqrt{MS_{E}/n} q α ( a , f ) M S E / n ∣ ( y ‾ i . − μ i ) − ( y ‾ j . − μ j ) ∣ ≤ q α ( a , f ) M S E / n |(\overline{y}_{i.}-\mu_{i})-(\overline{y}_{j.}-\mu_{j})| \leq q_{\alpha}(a,f)\sqrt{MS_{E}/n} ∣ ( y i . − μ i ) − ( y j . − μ j ) ∣ ≤ q α ( a , f ) M S E / n
P ( − q α ( a , f ) M S E n ≤ y ‾ i . − y ‾ j . − ( μ i − μ j ) ≤ q α ( a , f ) M S E n ) = 1 − α P\left(-q_{\alpha}(a,f)\sqrt{\frac{MS_{E}}{n}} \leq \overline{y}_{i.}-\overline{y}_{j.}-(\mu_{i}-\mu_{j}) \leq q_{\alpha}(a,f)\sqrt{\frac{MS_{E}}{n}}\right) = 1-\alpha P ( − q α ( a , f ) n M S E ≤ y i . − y j . − ( μ i − μ j ) ≤ q α ( a , f ) n M S E ) = 1 − α 把这一表达式整理,将 μ i − μ j \mu_{i}-\mu_{j} μ i − μ j 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
例 3.7 ¶ 为说明 Tukey 检验,我们使用例 3.1 中等离子体刻蚀试验的数据。取 α = 0.05 \alpha=0.05 α = 0.05 f = 16 f=16 f = 16 q 0.05 ( 4 , 16 ) = 4.05 q_{0.05}(4,16)=4.05 q 0.05 ( 4 , 16 ) = 4.05
T 0.05 = q 0.05 ( 4 , 16 ) M S E n = 4.05 333.70 5 = 33.09 T_{0.05} = q_{0.05}(4,16)\sqrt{\frac{MS_{E}}{n}} = 4.05\sqrt{\frac{333.70}{5}} = 33.09 T 0.05 = q 0.05 ( 4 , 16 ) n M S E = 4.05 5 333.70 = 33.09 于是,任何两个处理平均的绝对差超过 33.09,就意味着相应的这对总体均值显著不同。四个处理平均是
y ‾ 1. = 551.2 y ‾ 2. = 587.4 y ‾ 3. = 625.4 y ‾ 4. = 707.0 \begin{array}{ll}
\overline{y}_{1.} = 551.2 & \overline{y}_{2.} = 587.4 \\
\overline{y}_{3.} = 625.4 & \overline{y}_{4.} = 707.0
\end{array} y 1. = 551.2 y 3. = 625.4 y 2. = 587.4 y 4. = 707.0 平均之差为
y ‾ 1. − y ‾ 2. = 551.2 − 587.4 = − 36.2 0 ∗ \overline{y}_{1.}-\overline{y}_{2.} = 551.2-587.4 = -36.20^{*} y 1. − y 2. = 551.2 − 587.4 = − 36.2 0 ∗ y ‾ 1. − y ‾ 3. = 551.2 − 625.4 = − 74.2 0 ∗ \overline{y}_{1.}-\overline{y}_{3.} = 551.2-625.4 = -74.20^{*} y 1. − y 3. = 551.2 − 625.4 = − 74.2 0 ∗ y ‾ 1. − y ‾ 4. = 551.2 − 707.0 = − 155. 8 ∗ \overline{y}_{1.}-\overline{y}_{4.} = 551.2-707.0 = -155.8^{*} y 1. − y 4. = 551.2 − 707.0 = − 155. 8 ∗ y ‾ 2. − y ‾ 3. = 587.4 − 625.4 = − 38. 0 ∗ \overline{y}_{2.}-\overline{y}_{3.} = 587.4-625.4 = -38.0^{*} y 2. − y 3. = 587.4 − 625.4 = − 38. 0 ∗ y ‾ 2. − y ‾ 4. = 587.4 − 707.0 = − 119. 6 ∗ \overline{y}_{2.}-\overline{y}_{4.} = 587.4-707.0 = -119.6^{*} y 2. − y 4. = 587.4 − 707.0 = − 119. 6 ∗ y ‾ 3. − y ‾ 4. = 625.4 − 707.0 = − 81.6 0 ∗ \overline{y}_{3.}-\overline{y}_{4.} = 625.4-707.0 = -81.60^{*} y 3. − y 4. = 625.4 − 707.0 = − 81.6 0 ∗ 带星号的数值表示显著不同的均值对。注意 Tukey 程序表明所有均值对都不同。因此,每个功率设置产生的平均刻蚀速率都与其他任一功率设置下的平均刻蚀速率不同。
在使用任何均值两两检验程序时,我们偶尔会发现方差分析的总 F F F F F F 所有 可能对照,而不只是两两比较。也就是说,在当前数据中,显著的对照可能不是 μ i − μ j \mu_{i}-\mu_{j} μ i − μ j
Fisher 最小显著差(LSD)法。 Fisher 比较所有均值对的方法控制每次单个两两比较的错误率 α \alpha α t t t H 0 : μ i = μ j H_{0}: \mu_{i} = \mu_{j} H 0 : μ i = μ j
t 0 = y ‾ i . − y ‾ j . M S E ( 1 n i + 1 n j ) (3.39) t_{0} = \frac{\overline{y}_{i.}-\overline{y}_{j.}}{\sqrt{MS_{E}\left(\frac{1}{n_{i}}+\frac{1}{n_{j}}\right)}} \tag{3.39} t 0 = M S E ( n i 1 + n j 1 ) y i . − y j . ( 3.39 ) 假设是双侧备择假设,若 ∣ y ‾ i . − y ‾ j . ∣ > t α / 2 , N − a M S E ( 1 / n i + 1 / n j ) |\overline{y}_{i.}-\overline{y}_{j.}| > t_{\alpha/2,N-a}\sqrt{MS_{E}(1/n_{i}+1/n_{j})} ∣ y i . − y j . ∣ > t α /2 , N − a M S E ( 1/ n i + 1/ n j ) μ i \mu_{i} μ i μ j \mu_{j} μ j
L S D = t α / 2 , N − a M S E ( 1 n i + 1 n j ) (3.40) \mathrm{LSD} = t_{\alpha/2,N-a}\sqrt{MS_{E}\left(\frac{1}{n_{i}}+\frac{1}{n_{j}}\right)} \tag{3.40} LSD = t α /2 , N − a M S E ( n i 1 + n j 1 ) ( 3.40 ) 称为最小显著差 。如果设计是平衡的,n 1 = n 2 = ⋯ = n a = n n_{1}=n_{2}=\cdots=n_{a}=n n 1 = n 2 = ⋯ = n a = n
L S D = t α / 2 , N − a 2 M S E n (3.41) \mathrm{LSD} = t_{\alpha/2,N-a}\sqrt{\frac{2MS_{E}}{n}} \tag{3.41} LSD = t α /2 , N − a n 2 M S E ( 3.41 ) 使用 Fisher LSD 程序时,我们只需把每一对平均之间观测到的差异与相应的 LSD 比较。若 ∣ y ‾ i . − y ‾ j . ∣ > L S D |\overline{y}_{i.}-\overline{y}_{j.}| > \mathrm{LSD} ∣ y i . − y j . ∣ > LSD μ i \mu_{i} μ i μ j \mu_{j} μ j t t t
例 3.8 ¶ 为说明这一程序,如果使用例 3.1 试验的数据,α = 0.05 \alpha = 0.05 α = 0.05
L S D = t . 025 , 16 2 M S E n = 2.120 2 ( 333.70 ) 5 = 24.49 \mathrm{LSD} = t_{.025,16}\sqrt{\frac{2MS_{E}}{n}} = 2.120\sqrt{\frac{2(333.70)}{5}} = 24.49 LSD = t .025 , 16 n 2 M S E = 2.120 5 2 ( 333.70 ) = 24.49 于是,任何两个处理平均的绝对差超过 24.49,就意味着相应的这对总体均值显著不同。平均之差为
y ‾ 1. − y ‾ 2. = 551.2 − 587.4 = − 36. 2 ∗ \overline{y}_{1.}-\overline{y}_{2.} = 551.2-587.4 = -36.2^{*} y 1. − y 2. = 551.2 − 587.4 = − 36. 2 ∗ y ‾ 1. − y ‾ 3. = 551.2 − 625.4 = − 74. 2 ∗ \overline{y}_{1.}-\overline{y}_{3.} = 551.2-625.4 = -74.2^{*} y 1. − y 3. = 551.2 − 625.4 = − 74. 2 ∗ y ‾ 1. − y ‾ 4. = 551.2 − 707.0 = − 155. 8 ∗ \overline{y}_{1.}-\overline{y}_{4.} = 551.2-707.0 = -155.8^{*} y 1. − y 4. = 551.2 − 707.0 = − 155. 8 ∗ y ‾ 2. − y ‾ 3. = 587.4 − 625.4 = − 38. 0 ∗ \overline{y}_{2.}-\overline{y}_{3.} = 587.4-625.4 = -38.0^{*} y 2. − y 3. = 587.4 − 625.4 = − 38. 0 ∗ y ‾ 2. − y ‾ 4. = 587.4 − 707.0 = − 119. 6 ∗ \overline{y}_{2.}-\overline{y}_{4.} = 587.4-707.0 = -119.6^{*} y 2. − y 4. = 587.4 − 707.0 = − 119. 6 ∗ y ‾ 3. − y ‾ 4. = 625.4 − 707.0 = − 81. 6 ∗ \overline{y}_{3.}-\overline{y}_{4.} = 625.4-707.0 = -81.6^{*} y 3. − y 4. = 625.4 − 707.0 = − 81. 6 ∗ 带星号的数值表示显著不同的均值对。显然,所有均值对都显著不同。
注意使用这一方法可能使总的 α \alpha α a a a
我该用哪种两两比较方法? 此时一个合乎逻辑的问题当然是:我应当使用这些程序中的哪一个?遗憾的是,这个问题没有明确的答案,而且专业统计学家常常对各种程序的实用性持不同意见。Carmer 和 Swanson(1973)对若干多重比较程序(包括这里未讨论的其他程序)作了 Monte Carlo 模拟研究。他们报告说,最小显著差法如果只在方差分析的 F F F
如上所述,还有其他若干多重比较程序。关于这些方法的文献,见 O’Neill 和 Wetherill(1971)、Miller(1977)以及 Nelson(1989)。Miller(1991)和 Hsu(1996)的著作也值得推荐。
3.5.8 处理均值与对照的比较 ¶ 在许多试验中,其中一个处理是对照 ,分析者关注的是把其余 a − 1 a-1 a − 1 a − 1 a-1 a − 1 a a a
H 0 : μ i = μ a H 1 : μ i ≠ μ a \begin{array}{l}
H_{0}: \mu_{i} = \mu_{a} \\
H_{1}: \mu_{i} \neq \mu_{a}
\end{array} H 0 : μ i = μ a H 1 : μ i = μ a 其中 i = 1 , 2 , … , a − 1 i = 1, 2, \ldots, a-1 i = 1 , 2 , … , a − 1 t t t
∣ y ‾ i . − y ‾ a . ∣ i = 1 , 2 , … , a − 1 |\overline{y}_{i.}-\overline{y}_{a.}| \quad i = 1, 2, \ldots, a-1 ∣ y i . − y a . ∣ i = 1 , 2 , … , a − 1 若
∣ y ˉ i . − y ˉ a . ∣ > d α ( a − 1 , f ) M S E ( 1 n i + 1 n a ) (3.42) \left|\bar{y}_{i.}-\bar{y}_{a.}\right| > d_{\alpha}(a-1,f)\sqrt{MS_{E}\left(\frac{1}{n_{i}}+\frac{1}{n_{a}}\right)} \tag{3.42} ∣ y ˉ i . − y ˉ a . ∣ > d α ( a − 1 , f ) M S E ( n i 1 + n a 1 ) ( 3.42 ) 则以第 I 类错误率 α \alpha α H 0 : μ i = μ a H_{0}: \mu_{i} = \mu_{a} H 0 : μ i = μ a d α ( a − 1 , f ) d_{\alpha}(a-1,f) d α ( a − 1 , f ) α \alpha α a − 1 a-1 a − 1
例 3.9 ¶ 为说明 Dunnett 检验,考虑例 3.1 的试验,把处理 4 视为对照。本例中 a = 4 a=4 a = 4 a − 1 = 3 a-1=3 a − 1 = 3 f = 16 f=16 f = 16 n i = n = 5 n_{i}=n=5 n i = n = 5 d 0.05 ( 3 , 16 ) = 2.59 d_{0.05}(3,16)=2.59 d 0.05 ( 3 , 16 ) = 2.59
d 0.05 ( 3 , 16 ) 2 M S E n = 2.59 2 ( 333.70 ) 5 = 29.92 d_{0.05}(3,16)\sqrt{\frac{2MS_{E}}{n}} = 2.59\sqrt{\frac{2(333.70)}{5}} = 29.92 d 0.05 ( 3 , 16 ) n 2 M S E = 2.59 5 2 ( 333.70 ) = 29.92 (注意这是平衡设计下式 3.42 的化简形式。)于是,任何与对照的绝对差超过 29.92 的处理均值都将被判定为显著不同。所观测到的差为
1 对 4 : y ‾ 1. − y ‾ 4. = 551.2 − 707.0 = − 155.8 1 \text{ 对 } 4: \overline{y}_{1.}-\overline{y}_{4.} = 551.2-707.0 = -155.8 1 对 4 : y 1. − y 4. = 551.2 − 707.0 = − 155.8 2 对 4 : y ‾ 2. − y ‾ 4. = 587.4 − 707.0 = − 119.6 2 \text{ 对 } 4: \overline{y}_{2.}-\overline{y}_{4.} = 587.4-707.0 = -119.6 2 对 4 : y 2. − y 4. = 587.4 − 707.0 = − 119.6 3 对 4 : y ‾ 3. − y ‾ 4. = 625.4 − 707.0 = − 81.6 3 \text{ 对 } 4: \overline{y}_{3.}-\overline{y}_{4.} = 625.4-707.0 = -81.6 3 对 4 : y 3. − y 4. = 625.4 − 707.0 = − 81.6 注意所有差异都显著。因此我们会得出结论:所有功率设置都与对照不同。
在处理与对照的比较中,一个好的做法是让对照处理取比其他处理(设为 n n n n a n_{a} n a a − 1 a-1 a − 1 n a / n n_{a}/n n a / n n a / n = a n_{a}/n = \sqrt{a} n a / n = a