6.8 在 2^{k} 设计中加入中心点
使用两水平因子设计时,一个潜在的顾虑是因子效应的线性假定。当然,完全线性并非必要,即使线性假定只是很粗略地成立, 体系也工作得相当好。事实上我们已经指出,如果在一阶或主效应模型中加入交互作用项,得到
那么我们就有能力表示响应函数中某种弯曲的模型。这种弯曲当然来自交互作用项 所导致的平面扭曲。
在某些情形中,响应函数中的弯曲不能由式 6.28 充分建模。此时一个合乎逻辑的模型是
其中 表示纯二阶效应或二次效应。式 6.29 称为二阶响应曲面模型。
在进行两水平因子试验时,我们通常预期拟合式 6.28 的一阶模型,但也应当警惕式 6.29 的二阶模型更合适的可能性。有一种在 因子试验中重复某些点的方法,既能对二阶效应引起的弯曲提供防护,又能得到独立的误差估计。这种方法就是在 设计中加入中心点(center points),即在点 处做 次重复。在设计中心处加入重复试验的一个重要理由是,中心点不影响 设计中通常的效应估计。加入中心点时,我们假定 个因子都是定量的。
为说明这一方法,考虑一个 22 设计,在每个因子点 、、 和 处各有一个观测,在中心点 处有 个观测。图 6.37 和图 6.38 说明了这一情形。
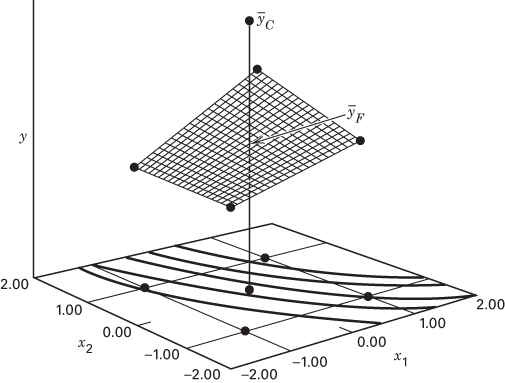
图 6.37 带中心点的 22 设计
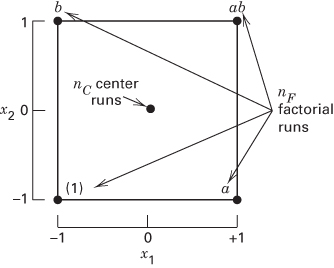
图 6.38 带中心点的 22 设计
设 是四个因子点处四次试验的平均, 是中心点处 次试验的平均。如果差 很小,那么中心点就落在(或接近落在)通过各因子点的平面上,不存在二次弯曲。反之,如果 很大,那么就存在二次弯曲。纯二次弯曲的单自由度平方和由下式给出:
其中一般地 是因子设计点的个数。这个平方和可以纳入方差分析,并与误差均方比较以检验纯二次弯曲。更具体地说,当在 设计的中心加入点时,用式 6.30 所作的弯曲检验实际上是检验假设
此外,如果设计中的因子点没有重复,还可以用 个中心点构造一个具有 个自由度的误差估计。也可以用 检验来检验弯曲。参见本章的补充材料。
例 6.7
我们通过重新考虑例 6.2 中的中间试验工厂试验来说明在 设计中加入中心点。回顾该试验是一个无重复的 24 设计,原试验见表 6.10。假设在该试验中加入四个中心点,在 处观测到的四个过滤速率为 73、75、66 和 69。这四个中心点的平均为 ,16 次因子试验的平均为 。由于 与 非常接近,我们猜想不存在很强的弯曲。
表 6.24 汇总了该试验的方差分析。表的上部我们拟合了全模型。纯误差的均方由中心点按下式计算:
因此,在表 6.24 中[1],
差值 用于按式 6.30 计算方差分析表中的纯二次(弯曲)平方和,如下:
方差分析表明,在所探索的区域内没有二阶弯曲的证据。也就是说,不能拒绝零假设 。显著效应是 A、C、D、AC 和 AD。约简模型的方差分析见表 6.24 的下部。该分析的结果与例 6.2 的结果一致,在例 6.2 中重要效应是用正态概率图法分离出来的。
表 6.24 例 6.7 的方差分析[2]
ANOVA for the Full Model
| 变异来源 | 平方和 | DF | 均方 | Prob > F | |
|---|---|---|---|---|---|
| Model | 5730.94 | 15 | 382.06 | 23.51 | 0.0121 |
| A | 1870.56 | 1 | 1870.56 | 115.11 | 0.0017 |
| B | 39.06 | 1 | 39.06 | 2.40 | 0.2188 |
| C | 390.06 | 1 | 390.06 | 24.00 | 0.0163 |
| D | 855.56 | 1 | 855.56 | 52.65 | 0.0054 |
| AB | 0.063 | 1 | 0.063 | 3.846E-003 | 0.9544 |
| AC | 1314.06 | 1 | 1314.06 | 80.87 | 0.0029 |
| AD | 1105.56 | 1 | 1105.56 | 68.03 | 0.0037 |
| BC | 22.56 | 1 | 22.56 | 1.39 | 0.3236 |
| BD | 0.56 | 1 | 0.56 | 0.035 | 0.8643 |
| CD | 5.06 | 1 | 5.06 | 0.31 | 0.6157 |
| ABC | 14.06 | 1 | 14.06 | 0.87 | 0.4209 |
| ABD | 68.06 | 1 | 68.06 | 4.19 | 0.1332 |
| ACD | 10.56 | 1 | 10.56 | 0.65 | 0.4791 |
| BCD | 27.56 | 1 | 27.56 | 1.70 | 0.2838 |
| ABCD | 7.56 | 1 | 7.56 | 0.47 | 0.5441 |
| Pure quadratic curvature | 1.51 | 1 | 1.51 | 0.093 | 0.7802 |
| Pure error | 48.75 | 3 | 16.25 | ||
| Cor total | 5781.20 | 19 |
ANOVA for the Reduced Model
| 变异来源 | 平方和 | DF | 均方 | Prob > F | |
|---|---|---|---|---|---|
| Model | 5535.81 | 5 | 1107.16 | 59.02 | <0.000 |
| A | 1870.56 | 1 | 1870.56 | 99.71 | <0.000 |
| C | 390.06 | 1 | 390.06 | 20.79 | 0.0005 |
| D | 855.56 | 1 | 855.56 | 45.61 | <0.000 |
| AC | 1314.06 | 1 | 1314.06 | 70.05 | <0.000 |
| AD | 1105.56 | 1 | 1105.56 | 58.93 | <0.000 |
| Pure quadratic curvature | 1.51 | 1 | 1.51 | 0.081 | 0.7809 |
| Residual | 243.87 | 13 | 18.76 | ||
| Lack of fit | 195.12 | 10 | 19.51 | 1.20 | 0.4942 |
| Pure error | 48.75 | 3 | 16.25 | ||
| Cor total | 5781.20 | 19 |
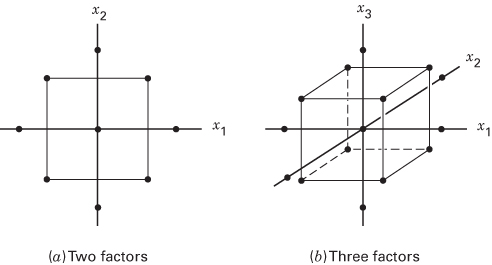
图 6.39 中心复合设计
在例 6.7 中,我们断定没有二次效应的迹象;也就是说,含 和 交互作用的 A、C、D 一阶模型是合适的。不过,总会有些情形需要二次项 。为对 个设计因子的情形加以例示,假设弯曲检验显著,于是我们不得不假定二阶模型,例如
遗憾的是,我们无法估计该模型中的未知参数(各 ),因为有六个参数需要估计,而图 6.38 中的 22 设计加中心点只有五个独立试验。
解决这个问题的办法简单而非常有效:在 设计上再加上四次轴点试验, 的情形如图 6.39a 所示。所得设计称为中心复合设计(central composite design),现在可以用它拟合二阶模型。图 6.39b 给出 个因子的中心复合设计。该设计有 次试验(通常 ),是拟合 个因子、含 10 个参数的二阶模型的高效设计。
中心复合设计广泛用于建立二阶响应曲面模型。这些设计将在第 11 章更详细地讨论。
本节最后给出关于使用中心点的一些补充建议和观察。
当因子试验在一个持续运行的过程中进行时,考虑把当前的操作条件(或配方)作为设计的中心点。这常常能让操作人员放心:试验中至少有部分试验是在他们熟悉的条件下进行的,因此所得结果(至少对这些试验而言)不太可能比通常情况更差。
当因子试验的中心点对应于常用的操作配方时,试验者可以用中心点处观测到的响应粗略检查试验期间是否发生了任何"异常"。也就是说,中心点响应应当与常规过程运行中历史上观测到的响应非常相似。操作人员常常会维护一张控制图来监控过程性能。有时可以把中心点响应直接标在控制图上,以检查试验期间过程运行的方式。
考虑按非随机顺序进行中心点处的重复试验。具体地说,在试验开始处或接近开始处做一两个中心点,在中部附近做一两个,在结束处附近做一两个。通过在时间上分散中心点,试验者就能对试验期间过程的稳定性作粗略检查。例如,如果在试验进行期间响应出现了趋势,把中心点响应对时间顺序作图就可能揭示出来。
有时试验不得不在几乎没有或完全没有关于过程变异的事先信息的情况下进行。在这种情况下,把两三个中心点作为试验的最初几次试验来做会很有帮助。这些试验可以提供变异的初步估计。如果变异的大小看起来合理,就继续;相反,如果观察到的变异比预想(或合理!)的更大,就停下来。在继续做其余试验之前先研究为什么变异如此之大,往往获益很多。
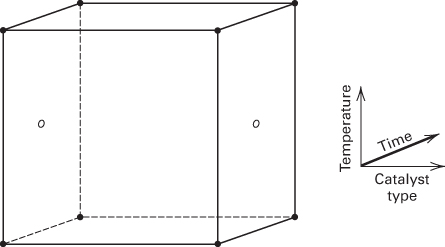
图 6.40 含一个定性因子和中心点的 23 因子设计
通常,当所有设计因子都是定量因子时才会使用中心点。不过有时会有一到几个定性(或分类)变量和几个定量变量。在这些情形下仍然可以使用中心点。为加以例示,考虑一个试验,它有两个定量因子时间和温度,各取两个水平;还有一个定性因子催化剂类型,也取两个水平(有机和无机)。图 6.40 给出这些因子的 23 设计。注意中心点被放在立方体中涉及定量因子的那两个相对面上。换句话说,只要那些子空间只涉及定量因子,中心点就可以在定性因子的高水平与低水平处理组合处进行。
值得注意的是,在 设计中加入中心点从来不是一种 D 最优设计策略。为加以例示,回顾我们在 6.7 节末尾构造的三个因子的 12 次试验 D 最优设计。该设计的 D 效率为 94.28%,而含四个中心点的 23 设计的 D 效率只有 70.64%。此外,在 12 次试验的 D 最优设计中模型参数的相对标准误为 0.306,而在含四个中心点的设计中为 0.354。正如所料,D 最优设计给出的模型参数估计更精确。图 6.41 的设计空间比例图比较了这两个设计的预测方差表现。图中较低的曲线是 D 最优设计的 FDS 曲线。显然,就在几乎整个设计空间上预测响应的能力而言,D 最优设计优于含四个中心点的 23 设计。不过,D 最优设计没有检出响应函数中潜在弯曲的能力。这两个设计之间的取舍需要试验者仔细考虑。
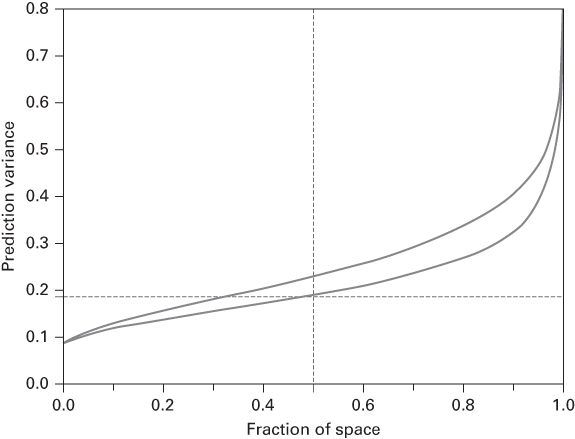
图 6.41 比较 12 次试验的 D 最优设计(下曲线)与含四个中心点的 23 设计(上曲线)的设计空间比例图