6.7 2^{k} 设计是最优设计
两水平因子设计有许多有趣而有用的性质。本节简要介绍其中一些性质。我们在前面几节中已经提到,2 k 2^{k} 2 k
考虑一个最简单的例子:一次重复的 22 设计。这是一个四次试验的设计,处理组合为 (1)、a a a b b b a b ab ab
y = β 0 + β 1 x 1 + β 2 x 2 + β 12 x 1 x 2 + ϵ y = \beta_{0} + \beta_{1} x_{1} + \beta_{2} x_{2} + \beta_{12} x_{1} x_{2} + \epsilon y = β 0 + β 1 x 1 + β 2 x 2 + β 12 x 1 x 2 + ϵ 其中 x 1 x_{1} x 1 x 2 x_{2} x 2 ± 1 \pm1 ± 1 x 1 x 2 x_{1}x_{2} x 1 x 2
( 1 ) = β 0 + β 1 ( − 1 ) + β 2 ( − 1 ) + β 12 ( − 1 ) ( − 1 ) + ϵ 1 a = β 0 + β 1 ( 1 ) + β 2 ( − 1 ) + β 12 ( 1 ) ( − 1 ) + ϵ 2 b = β 0 + β 1 ( − 1 ) + β 2 ( 1 ) + β 12 ( − 1 ) ( 1 ) + ϵ 3 a b = β 0 + β 1 ( 1 ) + β 2 ( 1 ) + β 12 ( 1 ) ( 1 ) + ϵ 4 \begin{array}{r l} & {(1) = \beta_{0} + \beta_{1} (- 1) + \beta_{2} (- 1) + \beta_{12} (- 1) (- 1) + \epsilon_{1}} \\ & {\quad a = \beta_{0} + \beta_{1} (1) + \beta_{2} (- 1) + \beta_{12} (1) (- 1) + \epsilon_{2}} \\ & {\quad b = \beta_{0} + \beta_{1} (- 1) + \beta_{2} (1) + \beta_{12} (- 1) (1) + \epsilon_{3}} \\ & {a b = \beta_{0} + \beta_{1} (1) + \beta_{2} (1) + \beta_{12} (1) (1) + \epsilon_{4}} \end{array} ( 1 ) = β 0 + β 1 ( − 1 ) + β 2 ( − 1 ) + β 12 ( − 1 ) ( − 1 ) + ϵ 1 a = β 0 + β 1 ( 1 ) + β 2 ( − 1 ) + β 12 ( 1 ) ( − 1 ) + ϵ 2 b = β 0 + β 1 ( − 1 ) + β 2 ( 1 ) + β 12 ( − 1 ) ( 1 ) + ϵ 3 ab = β 0 + β 1 ( 1 ) + β 2 ( 1 ) + β 12 ( 1 ) ( 1 ) + ϵ 4 把这四个式子写成矩阵形式要方便得多:
y = X β + ϵ , 其中 y = [ ( 1 ) a b a b ] , X = [ 1 − 1 − 1 1 1 1 − 1 − 1 1 − 1 1 − 1 1 1 1 1 ] , β = [ β 0 β 1 β 2 β 12 ] , 且 ϵ = [ ϵ 1 ϵ 2 ϵ 3 ϵ 4 ] \mathbf{y} = \mathbf{X} \boldsymbol{\beta} + \epsilon, \text{其中} \mathbf{y} = \left[ \begin{array}{c} (1) \\ a \\ b \\ a b \end{array} \right], \mathbf{X} = \left[ \begin{array}{c c c c} 1 & - 1 & - 1 & 1 \\ 1 & 1 & - 1 & - 1 \\ 1 & - 1 & 1 & - 1 \\ 1 & 1 & 1 & 1 \end{array} \right], \boldsymbol{\beta} = \left[ \begin{array}{c} \beta_{0} \\ \beta_{1} \\ \beta_{2} \\ \beta_{12} \end{array} \right], \text{且} \epsilon = \left[ \begin{array}{c} \epsilon_{1} \\ \epsilon_{2} \\ \epsilon_{3} \\ \epsilon_{4} \end{array} \right] y = X β + ϵ , 其中 y = ⎣ ⎡ ( 1 ) a b ab ⎦ ⎤ , X = ⎣ ⎡ 1 1 1 1 − 1 1 − 1 1 − 1 − 1 1 1 1 − 1 − 1 1 ⎦ ⎤ , β = ⎣ ⎡ β 0 β 1 β 2 β 12 ⎦ ⎤ , 且 ϵ = ⎣ ⎡ ϵ 1 ϵ 2 ϵ 3 ϵ 4 ⎦ ⎤ 模型参数的最小二乘估计是使模型误差 ϵ i , i = 1 , 2 , 3 , 4 \epsilon_{i}, i = 1,2,3,4 ϵ i , i = 1 , 2 , 3 , 4 β \beta β
β ^ = ( X ′ X ) − 1 X ′ y (6.26) \hat{\boldsymbol{\beta}} = (\mathbf{X}^{\prime} \mathbf{X})^{- 1} \mathbf{X}^{\prime} \mathbf{y} \tag{6.26} β ^ = ( X ′ X ) − 1 X ′ y ( 6.26 ) 其中撇号 (') 表示转置,( X ′ X ) − 1 (\mathbf{X}'\mathbf{X})^{-1} ( X ′ X ) − 1 X ′ X \mathbf{X}'\mathbf{X} X ′ X 22 设计,量 X ′ X \mathbf{X}'\mathbf{X} X ′ X X ′ y \mathbf{X}'\mathbf{y} X ′ y
X ′ X = [ 1 1 1 1 − 1 1 − 1 1 − 1 − 1 1 1 1 − 1 − 1 1 ] [ 1 − 1 − 1 1 1 1 − 1 − 1 1 − 1 1 − 1 1 1 1 1 ] = [ 4 0 0 0 0 4 0 0 0 0 4 0 0 0 0 4 ] \mathbf{X}^{\prime} \mathbf{X} = \left[ \begin{array}{r r r r} 1 & 1 & 1 & 1 \\ - 1 & 1 & - 1 & 1 \\ - 1 & - 1 & 1 & 1 \\ 1 & - 1 & - 1 & 1 \end{array} \right] \left[ \begin{array}{r r r r} 1 & - 1 & - 1 & 1 \\ 1 & 1 & - 1 & - 1 \\ 1 & - 1 & 1 & - 1 \\ 1 & 1 & 1 & 1 \end{array} \right] = \left[ \begin{array}{r r r r} 4 & 0 & 0 & 0 \\ 0 & 4 & 0 & 0 \\ 0 & 0 & 4 & 0 \\ 0 & 0 & 0 & 4 \end{array} \right] X ′ X = ⎣ ⎡ 1 − 1 − 1 1 1 1 − 1 − 1 1 − 1 1 − 1 1 1 1 1 ⎦ ⎤ ⎣ ⎡ 1 1 1 1 − 1 1 − 1 1 − 1 − 1 1 1 1 − 1 − 1 1 ⎦ ⎤ = ⎣ ⎡ 4 0 0 0 0 4 0 0 0 0 4 0 0 0 0 4 ⎦ ⎤ 以及
X ′ y = [ 1 1 1 1 − 1 1 − 1 1 − 1 − 1 1 1 1 − 1 − 1 1 ] [ ( 1 ) a b a b ] = [ ( 1 ) + a + b + a b − ( 1 ) + a − b + a b − ( 1 ) − a + b + a b ( 1 ) − a − b + a b ] \mathbf{X}^{\prime} \mathbf{y} = \left[ \begin{array}{r r r r} 1 & 1 & 1 & 1 \\ - 1 & 1 & - 1 & 1 \\ - 1 & - 1 & 1 & 1 \\ 1 & - 1 & - 1 & 1 \end{array} \right] \left[ \begin{array}{c} (1) \\ a \\ b \\ a b \end{array} \right] = \left[ \begin{array}{c} (1) + a + b + a b \\ - (1) + a - b + a b \\ - (1) - a + b + a b \\ (1) - a - b + a b \end{array} \right] X ′ y = ⎣ ⎡ 1 − 1 − 1 1 1 1 − 1 − 1 1 − 1 1 − 1 1 1 1 1 ⎦ ⎤ ⎣ ⎡ ( 1 ) a b ab ⎦ ⎤ = ⎣ ⎡ ( 1 ) + a + b + ab − ( 1 ) + a − b + ab − ( 1 ) − a + b + ab ( 1 ) − a − b + ab ⎦ ⎤ X ′ X \mathbf{X}'\mathbf{X} X ′ X 22 设计是正交的。最小二乘估计如下:
β ^ = ( X ′ X ) − 1 X ′ y = [ 4 0 0 0 0 4 0 0 0 0 4 0 0 0 0 4 ] − 1 [ ( 1 ) + a + b + a b − ( 1 ) + a − b + a b − ( 1 ) − a + b + a b ( 1 ) − a − b + a b ] \begin{array}{r} \hat{\boldsymbol{\beta}} = (\mathbf{X}^{\prime} \mathbf{X})^{- 1} \mathbf{X}^{\prime} \mathbf{y} \\ = \left[ \begin{array}{l l l l} 4 & 0 & 0 & 0 \\ 0 & 4 & 0 & 0 \\ 0 & 0 & 4 & 0 \\ 0 & 0 & 0 & 4 \end{array} \right]^{- 1} \left[ \begin{array}{c} (1) + a + b + a b \\ - (1) + a - b + a b \\ - (1) - a + b + a b \\ (1) - a - b + a b \end{array} \right] \end{array} β ^ = ( X ′ X ) − 1 X ′ y = ⎣ ⎡ 4 0 0 0 0 4 0 0 0 0 4 0 0 0 0 4 ⎦ ⎤ − 1 ⎣ ⎡ ( 1 ) + a + b + ab − ( 1 ) + a − b + ab − ( 1 ) − a + b + ab ( 1 ) − a − b + ab ⎦ ⎤ = [ ( 1 ) + a + b + a b 4 − ( 1 ) + a − b + a b 4 − ( 1 ) − a + b + a b 4 ( 1 ) − a − b + a b 4 ] = \left[ \begin{array}{l} \frac{(1) + a + b + a b}{4} \\ \frac{- (1) + a - b + a b}{4} \\ \frac{- (1) - a + b + a b}{4} \\ \frac{(1) - a - b + a b}{4} \end{array} \right] = ⎣ ⎡ 4 ( 1 ) + a + b + ab 4 − ( 1 ) + a − b + ab 4 − ( 1 ) − a + b + ab 4 ( 1 ) − a − b + ab ⎦ ⎤ 模型回归系数的最小二乘估计恰好等于通常效应估计的一半。
结果表明,任一模型回归系数的方差都容易求出:
V ( β ^ ) = σ 2 ( ( X ′ X ) − 1 的对角元素 ) = σ 2 4 (6.27) \begin{array}{r l} V(\hat{\beta}) & = \sigma^{2} \left((\mathbf{X}^{\prime} \mathbf{X})^{- 1} \text{ 的对角元素}\right) \\ & = \frac{\sigma^{2}}{4} \end{array} \tag{6.27} V ( β ^ ) = σ 2 ( ( X ′ X ) − 1 的对角元素 ) = 4 σ 2 ( 6.27 ) 所有模型回归系数的方差都相同。此外,在 ± 1 \pm1 ± 1 n n n 2 k 2^{k} 2 k V ( β ^ ) = σ 2 / ( n 2 k ) = σ 2 / N V(\hat{\beta}) = \sigma^{2}/(n2^{k}) = \sigma^{2}/N V ( β ^ ) = σ 2 / ( n 2 k ) = σ 2 / N N N N
对 22 设计,X ′ X \mathbf{X}'\mathbf{X} X ′ X
∣ ( X ′ X ) ∣ = 256 |(\mathbf{X}^{\prime} \mathbf{X})| = 256 ∣ ( X ′ X ) ∣ = 256 这是四次试验的设计在 ± 1 \pm1 ± 1 体积 与 X ′ X \mathbf{X}'\mathbf{X} X ′ X X ′ X \mathbf{X}'\mathbf{X} X ′ X 22 设计正好做到了这一点。
一般地,使模型回归系数方差最小的设计称为 D 最优设计 (D-optimal design)。之所以用 D 这个字眼,是因为这类设计是通过选择设计中的试验来使 X ′ X \mathbf{X}'\mathbf{X} X ′ X 2 k 2^{k} 2 k
现在考虑 22 设计中预测响应的方差
V [ y ^ ( x 1 x 2 ) ] = V ( β ^ 0 + β ^ 1 x 1 + β ^ 2 x 2 + β ^ 12 x 1 x 2 ) V[\hat{y}(x_{1} x_{2})] = V(\hat{\beta}_{0} + \hat{\beta}_{1} x_{1} + \hat{\beta}_{2} x_{2} + \hat{\beta}_{12} x_{1} x_{2}) V [ y ^ ( x 1 x 2 )] = V ( β ^ 0 + β ^ 1 x 1 + β ^ 2 x 2 + β ^ 12 x 1 x 2 ) 预测响应的方差是被预测点在设计空间中的位置(x 1 x_{1} x 1 x 2 x_{2} x 2 22 设计是正交的,各回归系数的估计相互独立,且方差均为 σ 2 / 4 \sigma^{2}/4 σ 2 /4
V [ y ^ ( x 1 , x 2 ) ] = V ( β 0 ^ + β 1 ^ x 1 + β 2 ^ x 2 + β 12 ^ x 1 x 2 ) = σ 2 4 ( 1 + x 1 2 + x 2 2 + x 1 2 x 2 2 ) \begin{array}{r} V[\hat{y}(x_{1}, x_{2})] = V(\hat{\beta_{0}} + \hat{\beta_{1}} x_{1} + \hat{\beta_{2}} x_{2} + \hat{\beta_{12}} x_{1} x_{2}) \\ = \frac{\sigma^{2}}{4} (1 + x_{1}^{2} + x_{2}^{2} + x_{1}^{2} x_{2}^{2}) \end{array} V [ y ^ ( x 1 , x 2 )] = V ( β 0 ^ + β 1 ^ x 1 + β 2 ^ x 2 + β 12 ^ x 1 x 2 ) = 4 σ 2 ( 1 + x 1 2 + x 2 2 + x 1 2 x 2 2 ) 最大预测方差出现在 x 1 = x 2 = ± 1 x_{1}=x_{2}=\pm1 x 1 = x 2 = ± 1 σ 2 \sigma^{2} σ 2 p σ 2 / N p\sigma^{2}/N p σ 2 / N p p p N N N 22 设计的试验次数 N = 4 N = 4 N = 4 p = 4 p = 4 p = 4 G 最优设计 (G-optimal design)。一般地,2 k 2^{k} 2 k
我们可以在设计空间中任何感兴趣的点处计算预测方差。例如,在设计中心处 x 1 = x 2 = 0 x_{1} = x_{2} = 0 x 1 = x 2 = 0
V [ y ^ ( x 1 = 0 , x 2 = 0 ) ] = σ 2 4 V[\hat{y}(x_{1} = 0, x_{2} = 0)] = \frac{\sigma^{2}}{4} V [ y ^ ( x 1 = 0 , x 2 = 0 )] = 4 σ 2 当 x 1 = 1 x_{1} = 1 x 1 = 1 x 2 = 0 x_{2} = 0 x 2 = 0
V [ y ^ ( x 1 = 1 , x 2 = 0 ) ] = σ 2 2 V[\hat{y}(x_{1} = 1, x_{2} = 0)] = \frac{\sigma^{2}}{2} V [ y ^ ( x 1 = 1 , x 2 = 0 )] = 2 σ 2 除了在设计空间的大量点上计算预测方差外,另一种做法是考虑设计空间上的平均预测方差 。计算这一平均预测方差的一种方式为
I = 1 A ∫ − 1 1 ∫ − 1 1 V [ y ^ ( x 1 , x 2 ) ] d x 1 d x 2 I = \frac{1}{A} \int_{- 1}^{1} \int_{- 1}^{1} V[\hat{y}(x_{1}, x_{2})] d x_{1} d x_{2} I = A 1 ∫ − 1 1 ∫ − 1 1 V [ y ^ ( x 1 , x 2 )] d x 1 d x 2 其中 A A A
有时把 I I I 积分方差准则 (integrated variance criterion)。对 22 设计,设计区域的面积 A = 4 A = 4 A = 4
I = 1 A ∫ − 1 1 ∫ − 1 1 V [ y ^ ( x 1 , x 2 ) ] d x 1 d x 2 = 1 4 ∫ − 1 1 ∫ − 1 1 σ 2 1 4 ( 1 + x 1 2 + x 2 2 + x 1 2 x 2 2 ) d x 1 d x 2 = 4 σ 2 9 \begin{array}{l} I = \frac{1}{A} \int_{- 1}^{1} \int_{- 1}^{1} V[\hat{y}(x_{1}, x_{2})] d x_{1} d x_{2} \\ = \frac{1}{4} \int_{- 1}^{1} \int_{- 1}^{1} \sigma^{2} \frac{1}{4} (1 + x_{1}^{2} + x_{2}^{2} + x_{1}^{2} x_{2}^{2}) d x_{1} d x_{2} \\ = \frac{4 \sigma^{2}}{9} \end{array} I = A 1 ∫ − 1 1 ∫ − 1 1 V [ y ^ ( x 1 , x 2 )] d x 1 d x 2 = 4 1 ∫ − 1 1 ∫ − 1 1 σ 2 4 1 ( 1 + x 1 2 + x 2 2 + x 1 2 x 2 2 ) d x 1 d x 2 = 9 4 σ 2 结果表明,这是用四次试验的设计在该设计空间上拟合含交互作用的一阶模型所能得到的平均预测方差的最小可能值。具有这一性质的设计称为 I 最优设计 (I-optimal design)。一般地,2 k 2^{k} 2 k
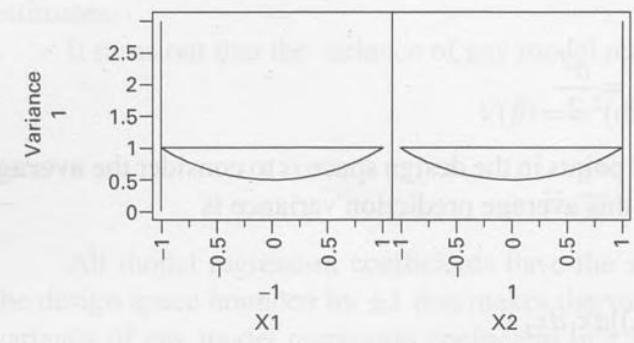
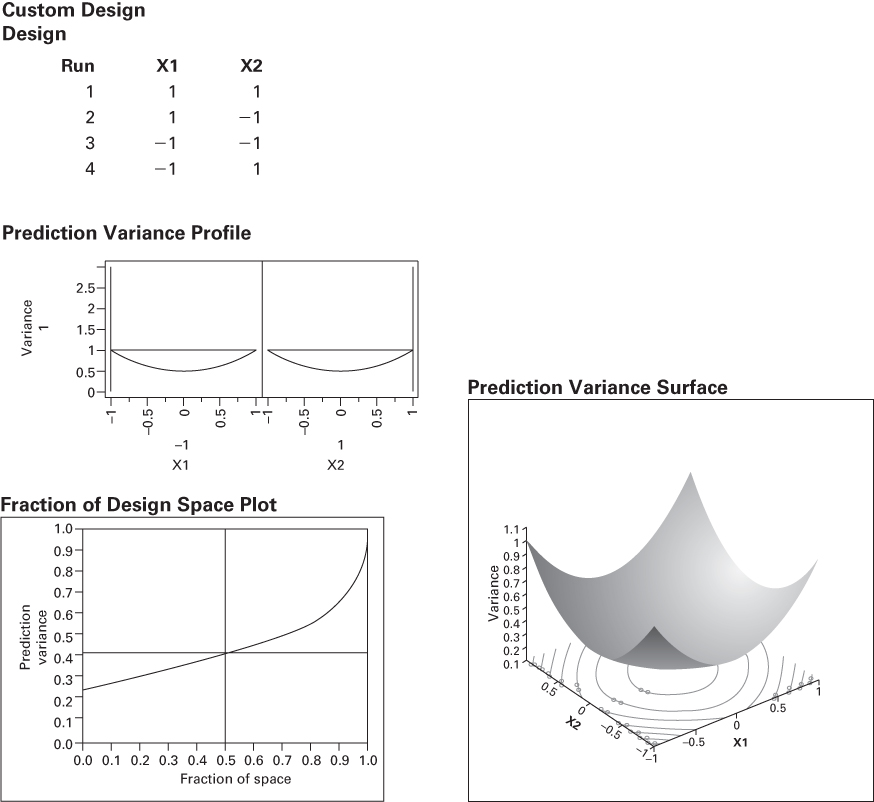
还可以把设计空间上的预测方差用图形显示出来。图 6.36 是 JMP 的输出,例示 22 设计预测方差的三种可能展示。第一张图是预测方差刻画器,它把未标准化的预测方差 (unscaled prediction variance)
U P V = V [ y ^ ( x 1 , x 2 ) ] σ 2 U P V = \frac{V[\hat{y}(x_{1}, x_{2})]}{\sigma^{2}} U P V = σ 2 V [ y ^ ( x 1 , x 2 )] 对每个设计因子的水平作图。图上的"十字准线"可以调节,从而可以在变量 x 1 x_{1} x 1 x 2 x_{2} x 2 x 1 = − 1 x_{1} = -1 x 1 = − 1
Custom Design
Prediction Variance Profile
Prediction Variance Surface
Fraction of Design Space Plot
图 6.36 22 设计预测方差的 JMP 输出
和 x 2 = + 1 x_{2}=+1 x 2 = + 1
U P V = V [ y ^ ( x 1 , x 2 ) ] σ 2 = σ 2 4 ( 1 + x 1 2 + x 2 2 + x 1 2 x 2 2 ) σ 2 = σ 2 4 ( 4 ) σ 2 = 1 \begin{array}{r l} U P V & = \frac{V[\hat{y}(x_{1}, x_{2})]}{\sigma^{2}} \\ & = \frac{\frac{\sigma^{2}}{4} (1 + x_{1}^{2} + x_{2}^{2} + x_{1}^{2} x_{2}^{2})}{\sigma^{2}} \\ & = \frac{\frac{\sigma^{2}}{4} (4)}{\sigma^{2}} \\ & = 1 \end{array} U P V = σ 2 V [ y ^ ( x 1 , x 2 )] = σ 2 4 σ 2 ( 1 + x 1 2 + x 2 2 + x 1 2 x 2 2 ) = σ 2 4 σ 2 ( 4 ) = 1 第二张图是设计空间比例 (fraction of design space,FDS)图,它在纵轴上给出未标准化的预测方差,在横轴上给出设计空间的比例。这张图上同样有可调节的十字准线,图中显示在横轴设计空间比例的 50% 处。十字准线表明,在一段覆盖设计区域 50% 的区域上,未标准化的预测方差至多为 0.425 σ 2 0.425\sigma^{2} 0.425 σ 2 σ 2 \sigma^{2} σ 2
JMP 输出中最后一种展示是未标准化预测方差的曲面图。22 设计的等预测方差等高线是圆;也就是说,设计空间中与设计中心距离相同的所有点都有相同的预测方差。
软件中的最优设计工具可以帮助试验者在试验的要求使得没有现成标准设计可用时构造设计。例如,考虑这样一种情形:试验者关心三个连续因子,每个取两个水平,并希望确保所有主效应和两因子交互作用都能估计出来。同时还希望有重复,以便进行正规的统计检验。合乎逻辑的设计选择似乎是 23 因子设计重复两次,需要 16 次试验。然而试验预算只允许 12 次试验。这一样本量下没有现成的标准设计,所以在这种情形下最优设计是一个合理的替代方案。
下面显示的左侧是用 JMP 的最优设计工具构造的 12 次试验的 D 最优设计。右侧是一些估计效率信息。我们首先注意到的是模型回归系数的相对标准误都相等,但并不等于 1 / 12 = 0.289 1/\sqrt{12}=0.289 1/ 12 = 0.289 σ \sigma σ 等方差设计 (equi-variance design),即所有参数都以相同精度估计。该设计并非严格 D 最优,其 D 效率为 94.28%。这个设计之所以不是 D 最优,是因为它不是正交设计,而本问题情形下没有 12 次试验的正交设计可用。每个模型参数(截距除外)置信区间的长度,相对于若能使用 12 次试验正交设计时的长度增加了 6.1%。该设计在 α = 0.10 \alpha=0.10 α = 0.10
试验 X1 X2 X3 1 1 1 −1 2 1 1 1 3 1 1 −1 4 −1 1 1 5 1 −1 1 6 1 −1 −1 7 −1 1 −1 8 −1 −1 1 9 −1 −1 −1 10 −1 1 1 11 1 −1 1 12 −1 −1 −1
Estimation Efficiency
Term Fractional Increase in CI Length Relative Std Error of Estimate Intercept 0.061 0.306 X1 0.061 0.306 X2 0.061 0.306 X3 0.061 0.306 X1*X2 0.061 0.306 X1*X3 0.061 0.306 X2*X3 0.061 0.306 X1X2 X3 0.061 0.306