6.2 2^{2} 设计
2 k 2^{k} 2 k 22 因子设计
因子 A 因子 B 处理组合 重复 I 重复 II 重复 III 总计 − − A 低,B 低 28 25 27 80 + − A 高,B 低 36 32 32 100 − + A 低,B 高 18 19 23 60 + + A 高,B 高 31 30 29 90
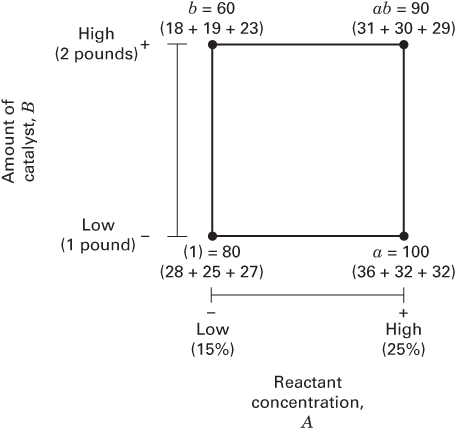
该设计中的四个处理组合如图 6.1 所示。按照约定,我们用大写拉丁字母表示一个因子的效应。因此,"A"指的是因子 A 的效应,"B"指的是
图 6.1 22 设计中的处理组合
因子 B 的效应,而"AB"指的是 A B AB A B 22 设计中,A 轴和 B 轴上的"−"和"+"分别表示 A 与 B 的低水平和高水平。因此,A 轴上的 − 表示浓度的低水平(15%),而 + 表示高水平(25%);B 轴上的 − 表示催化剂的低水平,+ 表示高水平。
设计中的四个处理组合也用相应的小写字母表示,如图 6.1 所示。从图中可以看到,处理组合中某个因子的高水平用对应的小写字母表示,而某个因子的低水平用相应字母的缺失表示。因此,a a a b b b a b ab ab 2 k 2^{k} 2 k
在两水平因子设计中,我们可以把一个因子的平均效应定义为:在其他因子的水平上取平均后,该因子水平改变所引起的响应变化。此外,符号 (1)、a a a b b b a b ab ab n n n [ a − ( 1 ) ] / n [a - (1)]/n [ a − ( 1 )] / n [ a b − b ] / n [ab - b]/n [ ab − b ] / n
A = 1 2 n { [ a b − b ] + [ a − ( 1 ) ] } = 1 2 n [ a b + a − b − ( 1 ) ] (6.1) \begin{array}{r l} A & = \frac{1}{2 n} \{[a b - b] + [a - (1)]\} \\ & = \frac{1}{2 n} [a b + a - b - (1)] \end{array} \tag{6.1} A = 2 n 1 {[ ab − b ] + [ a − ( 1 )]} = 2 n 1 [ ab + a − b − ( 1 )] ( 6.1 ) B 的平均主效应由 A 取低水平时 B 的效应(即 [ b − ( 1 ) ] / n [b-(1)]/n [ b − ( 1 )] / n [ a b − a ] / n [ab-a]/n [ ab − a ] / n
B = 1 2 n { [ a b − a ] + [ b − ( 1 ) ] } = 1 2 n [ a b + b − a − ( 1 ) ] (6.2) \begin{array}{r l} & B = \frac{1}{2 n} \{[a b - a] + [b - (1)]\} \\ & \quad = \frac{1}{2 n} [a b + b - a - (1)] \end{array} \tag{6.2} B = 2 n 1 {[ ab − a ] + [ b − ( 1 )]} = 2 n 1 [ ab + b − a − ( 1 )] ( 6.2 ) 我们把交互效应 A B AB A B
A B = 1 2 n { [ a b − b ] − [ a − ( 1 ) ] } = 1 2 n [ a b + ( 1 ) − a − b ] (6.3) \begin{array}{r} AB = \frac{1}{2 n} \{[a b - b] - [a - (1)]\} \\ = \frac{1}{2 n} [a b + (1) - a - b] \end{array} \tag{6.3} A B = 2 n 1 {[ ab − b ] − [ a − ( 1 )]} = 2 n 1 [ ab + ( 1 ) − a − b ] ( 6.3 ) 另外,我们也可以把 A B AB A B
A、B 和 AB 效应的公式还可以用另一种方法导出。A 的效应可以由图 6.1 中方框右侧两个处理组合的平均响应(记为 y ‾ A + \overline{y}_{A^{+}} y A + y ‾ A − \overline{y}_{A^{-}} y A −
A = y ‾ A + − y ‾ A − = a b + a 2 n − b + ( 1 ) 2 n = 1 2 n [ a b + a − b − ( 1 ) ] \begin{array}{r l} A & = \overline{{y}}_{A^{+}} - \overline{{y}}_{A^{-}} \\ & = \frac{a b + a}{2 n} - \frac{b + (1)}{2 n} \\ & = \frac{1}{2 n} [a b + a - b - (1)] \end{array} A = y A + − y A − = 2 n ab + a − 2 n b + ( 1 ) = 2 n 1 [ ab + a − b − ( 1 )] 这与式 6.1 的结果完全相同。B 的效应即式 6.2,由方框顶部两个处理组合的平均值(y ‾ B + \overline{y}_{B^{+}} y B + y ‾ B − \overline{y}_{B^{-}} y B −
B = y ‾ B + − y ‾ B − = a b + b 2 n − a + ( 1 ) 2 n = 1 2 n [ a b + b − a − ( 1 ) ] \begin{array}{r l} & B = \overline{{y}}_{B^{+}} - \overline{{y}}_{B^{-}} \\ & \quad = \frac{a b + b}{2 n} - \frac{a + (1)}{2 n} \\ & \quad = \frac{1}{2 n} [a b + b - a - (1)] \end{array} B = y B + − y B − = 2 n ab + b − 2 n a + ( 1 ) = 2 n 1 [ ab + b − a − ( 1 )] 最后,交互效应 AB 等于方框中从右到左对角线上两个处理组合 [ a b [ab [ ab ] ] ] a a a b b b
A B = a b + ( 1 ) 2 n − a + b 2 n = 1 2 n [ a b + ( 1 ) − a − b ] \begin{array}{r l} AB & = \frac{a b + (1)}{2 n} - \frac{a + b}{2 n} \\ & = \frac{1}{2 n} [a b + (1) - a - b] \end{array} A B = 2 n ab + ( 1 ) − 2 n a + b = 2 n 1 [ ab + ( 1 ) − a − b ] 这与式 6.3 完全一致。
利用图 6.1 中的试验,我们可以把平均效应估计为
A = 1 2 ( 3 ) ( 90 + 100 − 60 − 80 ) = 8.33 A = \frac{1}{2(3)} (90 + 100 - 60 - 80) = 8.33 A = 2 ( 3 ) 1 ( 90 + 100 − 60 − 80 ) = 8.33 B = 1 2 ( 3 ) ( 90 + 60 − 100 − 80 ) = − 5.00 B = \frac{1}{2(3)} (90 + 60 - 100 - 80) = - 5.00 B = 2 ( 3 ) 1 ( 90 + 60 − 100 − 80 ) = − 5.00 A B = 1 2 ( 3 ) ( 90 + 80 − 100 − 60 ) = 1.67 AB = \frac{1}{2(3)} (90 + 80 - 100 - 60) = 1.67 A B = 2 ( 3 ) 1 ( 90 + 80 − 100 − 60 ) = 1.67 A(反应物浓度)的效应为正,这说明把 A 由低水平(15%)提高到高水平(25%)会提高产率。B(催化剂)的效应为负,这说明增加加入到过程中的催化剂量会降低产率。相对于两个主效应而言,交互效应看起来很小。
在涉及 2 k 2^{k} 2 k t t t 2 k 2^{k} 2 k
下面考虑 A、B 和 AB 的平方和如何确定。注意由式 6.1 可见,估计 A 时用到了一个对照 (contrast),即
Contrast A = a b + a − b − ( 1 ) (6.4) \text{Contrast}_{A} = a b + a - b - (1) \tag{6.4} Contrast A = ab + a − b − ( 1 ) ( 6.4 ) 我们通常把这个对照称为 A 的总效应。由式 6.2 和 6.3 可见,估计 B 和 AB 时也用到了对照。此外,这三个对照是正交的。任何对照的平方和都可以由式 3.29 计算,该式指出:任何对照的平方和等于该对照的平方除以对照中每个总和所含的观测值个数再乘以对照系数的平方和。于是有
S S A = [ a b + a − b − ( 1 ) ] 2 4 n (6.5) SS_{A} = \frac{[a b + a - b - (1)]^{2}}{4 n} \tag{6.5} S S A = 4 n [ ab + a − b − ( 1 ) ] 2 ( 6.5 ) S S B = [ a b + b − a − ( 1 ) ] 2 4 n (6.6) SS_{B} = \frac{[a b + b - a - (1)]^{2}}{4 n} \tag{6.6} S S B = 4 n [ ab + b − a − ( 1 ) ] 2 ( 6.6 ) 以及
S S A B = [ a b + ( 1 ) − a − b ] 2 4 n (6.7) SS_{AB} = \frac{[a b + (1) - a - b]^{2}}{4 n} \tag{6.7} S S A B = 4 n [ ab + ( 1 ) − a − b ] 2 ( 6.7 ) 分别作为 A、B 和 AB 的平方和。注意这些式子是多么简单:只需对一个数取平方就能算出平方和。
利用图 6.1 中的试验,由式 6.5 至 6.7 可得各平方和为
S S A = ( 50 ) 2 4 ( 3 ) = 208.33 SS_{A} = \frac{(50)^{2}}{4(3)} = 208.33 S S A = 4 ( 3 ) ( 50 ) 2 = 208.33 S S B = ( − 30 ) 2 4 ( 3 ) = 75.00 (6.8) SS_{B} = \frac{(- 30)^{2}}{4(3)} = 75.00 \tag{6.8} S S B = 4 ( 3 ) ( − 30 ) 2 = 75.00 ( 6.8 ) 以及
S S A B = ( 10 ) 2 4 ( 3 ) = 8.33 SS_{AB} = \frac{(10)^{2}}{4(3)} = 8.33 S S A B = 4 ( 3 ) ( 10 ) 2 = 8.33 总平方和按通常方式求得,即
S S T = ∑ i = 1 2 ∑ j = 1 2 ∑ k = 1 n y i j k 2 − y ⋯ 2 4 n (6.9) SS_{T} = \sum_{i = 1}^{2} \sum_{j = 1}^{2} \sum_{k = 1}^{n} y_{i j k}^{2} - \frac{y_{\cdots}^{2}}{4 n} \tag{6.9} S S T = i = 1 ∑ 2 j = 1 ∑ 2 k = 1 ∑ n y ijk 2 − 4 n y ⋯ 2 ( 6.9 ) 一般地,S S T SS_{T} S S T 4 n − 1 4n - 1 4 n − 1 4 ( n − 1 ) 4(n - 1) 4 ( n − 1 )
S S E = S S T − S S A − S S B − S S A B (6.10) SS_{E} = SS_{T} - SS_{A} - SS_{B} - SS_{AB} \tag{6.10} S S E = S S T − S S A − S S B − S S A B ( 6.10 ) 对图 6.1 中的试验,我们得到
S S T = ∑ i = 1 2 ∑ j = 1 2 ∑ k = 1 3 y i j k 2 − y … 2 4 ( 3 ) = 9398.00 − 9075.00 = 323.00 \begin{array}{r l} SS_{T} & = \sum_{i = 1}^{2} \sum_{j = 1}^{2} \sum_{k = 1}^{3} y_{i j k}^{2} - \frac{y_{\dots}^{2}}{4(3)} \\ & = 9398.00 - 9075.00 = 323.00 \end{array} S S T = ∑ i = 1 2 ∑ j = 1 2 ∑ k = 1 3 y ijk 2 − 4 ( 3 ) y … 2 = 9398.00 − 9075.00 = 323.00 以及
S S E = S S T − S S A − S S B − S S A B = 323.00 − 208.33 − 75.00 − 8.33 = 31.34 \begin{array}{r l} SS_{E} & = SS_{T} - SS_{A} - SS_{B} - SS_{AB} \\ & = 323.00 - 208.33 - 75.00 - 8.33 \\ & = 31.34 \end{array} S S E = S S T − S S A − S S B − S S A B = 323.00 − 208.33 − 75.00 − 8.33 = 31.34 其中 S S A SS_{A} S S A S S B SS_{B} S S B S S A B SS_{AB} S S A B P P P
把处理组合按 (1)、a a a b b b a b ab ab 标准顺序 (standard order,也叫耶茨顺序,得名于 Frank Yates,他是 Fisher 的同事之一,对试验的设计与分析作出了许多重要贡献)。
表 6.1 图 6.1 中试验的方差分析
变异来源 平方和 自由度 均方 F q F_{q} F q P P P A 208.33 1 208.33 53.15 0.0001 B 75.00 1 75.00 19.13 0.0024 AB 8.33 1 8.33 2.13 0.1826 误差 31.34 8 3.92 总计 323.00 11
使用这一标准顺序可以看到,估计效应时所用的对照系数为
效应 (1) a a a b b b a b ab ab A −1 +1 −1 +1 B −1 −1 +1 +1 AB +1 −1 −1 +1
注意估计交互效应的对照系数恰好是相应两个主效应系数的乘积。对照系数总是 +1 或 −1,因此可以用表 6.2 这样的正负号表来确定每个处理组合的恰当符号。表 6.2 的列标题是主效应(A 和 B)、A B AB A B − ( 1 ) + a − b + a b -(1) + a - b + ab − ( 1 ) + a − b + ab 22 设计(以及所有 2 k 2^{k} 2 k 正交编码 (orthogonal coding)或效应编码 (effects coding)。
表 6.2 22 设计中计算效应的代数符号
处理组合 I A B AB (1) + − − + a a a + + − − b b b + − + − a b ab ab + + + +
**回归模型。**在 2 k 2^{k} 2 k 2 k 2^{k} 2 k
y = β 0 + β 1 x 1 + β 2 x 2 + ϵ y = \beta_{0} + \beta_{1} x_{1} + \beta_{2} x_{2} + \epsilon y = β 0 + β 1 x 1 + β 2 x 2 + ϵ 其中 x 1 x_{1} x 1 x 2 x_{2} x 2 β \beta β
x 1 = Conc − ( Conc low + Conc high ) / 2 ( Conc high − Conc low ) / 2 x_{1} = \frac{\operatorname{Conc} - \left(\operatorname{Conc}_{\text{low}} + \operatorname{Conc}_{\text{high}}\right) / 2}{\left(\operatorname{Conc}_{\text{high}} - \operatorname{Conc}_{\text{low}}\right) / 2} x 1 = ( Conc high − Conc low ) /2 Conc − ( Conc low + Conc high ) /2 以及
x 2 = Catalyst − ( Catalyst low + Catalyst high ) / 2 ( Catalyst high − Catalyst low ) / 2 x_{2} = \frac{\text{Catalyst} - (\text{Catalyst}_{\text{low}} + \text{Catalyst}_{\text{high}}) / 2}{(\text{Catalyst}_{\text{high}} - \text{Catalyst}_{\text{low}}) / 2} x 2 = ( Catalyst high − Catalyst low ) /2 Catalyst − ( Catalyst low + Catalyst high ) /2 当自然变量只有两个水平时,这种编码对编码变量的水平给出我们熟悉的 ± 1 \pm 1 ± 1
x 1 = Conc − ( 15 + 25 ) / 2 ( 25 − 15 ) / 2 = Conc − 20 5 \begin{array}{r l} x_{1} & = \frac{\text{Conc} - (15 + 25) / 2}{(25 - 15) / 2} \\ & = \frac{\text{Conc} - 20}{5} \end{array} x 1 = ( 25 − 15 ) /2 Conc − ( 15 + 25 ) /2 = 5 Conc − 20 因此,如果浓度处于高水平(Conc = 25%),则 x 1 = + 1 x_{1} = +1 x 1 = + 1 x 1 = − 1 x_{1} = -1 x 1 = − 1
x 2 = Catalyst − ( 1 + 2 ) / 2 ( 2 − 1 ) / 2 = Catalyst − 1.5 0.5 \begin{array}{r l} x_{2} & = \frac{\text{Catalyst} - (1 + 2) / 2}{(2 - 1) / 2} \\ & = \frac{\text{Catalyst} - 1.5}{0.5} \end{array} x 2 = ( 2 − 1 ) /2 Catalyst − ( 1 + 2 ) /2 = 0.5 Catalyst − 1.5 因此,如果催化剂处于高水平(Catalyst = 2 磅),则 x 2 = + 1 x_{2} = +1 x 2 = + 1 x 2 = − 1 x_{2} = -1 x 2 = − 1
拟合的回归模型为
y ^ = 27.5 + ( 8.33 2 ) x 1 + ( − 5.00 2 ) x 2 \hat{y} = 27.5 + \left(\frac{8.33}{2}\right) x_{1} + \left(\frac{-5.00}{2}\right) x_{2} y ^ = 27.5 + ( 2 8.33 ) x 1 + ( 2 − 5.00 ) x 2 其中截距是全部 12 个观测值的总平均,回归系数 β ^ 1 \hat{\beta}_{1} β ^ 1 β ^ 2 \hat{\beta}_{2} β ^ 2 x x x y y y
**需要多少次重复?**几乎每个试验都会遇到的一个标准问题是:需要多少次重复?我们在前面几章已讨论过这个问题,但其中有些方面在大量用于因子筛选的 2 k 2^{k} 2 k k k k 2 σ 2\sigma 2 σ
我们将用 22 化学过程试验来说明如何确定样本量的恰当选择。假设我们感兴趣的是检出大小为 2 σ 2\sigma 2 σ 22 设计重复两次,共 8 次试验,则有 4 个自由度可用于估计与模型无关的误差估计(纯误差)。如果试验者使用 α = 0.05 \alpha = 0.05 α = 0.05
假设我们在化学过程试验中使用 α = 0.10 \alpha = 0.10 α = 0.10 α = 0.20 \alpha = 0.20 α = 0.20 α = 0.05 \alpha = 0.05 α = 0.05 2 σ 2\sigma 2 σ 22 设计的三次重复。
可以用软件包作出上述功效计算。下面的方框显示给出 JMP 的功效计算结果。该模型同时含两个主效应和二因子交互作用;大小为 2 σ 2\sigma 2 σ
Evaluate Design
Model
Intercept
X1
X2
X1*X2
Power Analysis
Significance Level 0.05 Anticipated RMSE 1
Term Anticipated Coefficient Power Intercept 1 0.857 X1 1 0.857 X2 1 0.857 X1*X2 1 0.857
**残差与模型适合性。**回归模型可用于得到设计中四个点处 y y y y y y x 1 = − 1 x_{1} = -1 x 1 = − 1 x 2 = − 1 x_{2} = -1 x 2 = − 1
y ^ = 27.5 + ( 8.33 2 ) ( − 1 ) + ( − 5.00 2 ) ( − 1 ) = 25.835 \hat{y} = 27.5 + \left(\frac{8.33}{2}\right) (- 1) + \left(\frac{-5.00}{2}\right) (- 1) = 25.835 y ^ = 27.5 + ( 2 8.33 ) ( − 1 ) + ( 2 − 5.00 ) ( − 1 ) = 25.835 在该处理组合处有三个观测值,其残差为
e 1 = 28 − 25.835 = 2.165 e 2 = 25 − 25.835 = − 0.835 e 3 = 27 − 25.835 = 1.165 \begin{array}{l} e_{1} = 28 - 25.835 = 2.165 \\ e_{2} = 25 - 25.835 = - 0.835 \\ e_{3} = 27 - 25.835 = 1.165 \end{array} e 1 = 28 − 25.835 = 2.165 e 2 = 25 − 25.835 = − 0.835 e 3 = 27 − 25.835 = 1.165 其余预测值和残差用类似方法计算。对反应物浓度取高水平、催化剂取低水平,
y ^ = 27.5 + ( 8.33 2 ) ( + 1 ) + ( − 5.00 2 ) ( − 1 ) = 34.165 \hat{y} = 27.5 + \left(\frac{8.33}{2}\right) (+ 1) + \left(\frac{-5.00}{2}\right) (- 1) = 34.165 y ^ = 27.5 + ( 2 8.33 ) ( + 1 ) + ( 2 − 5.00 ) ( − 1 ) = 34.165 以及
e 4 = 36 − 34.165 = 1.835 e_{4} = 36 - 34.165 = 1.835 e 4 = 36 − 34.165 = 1.835 e 5 = 32 − 34.165 = − 2.165 e_{5} = 32 - 34.165 = - 2.165 e 5 = 32 − 34.165 = − 2.165 e 6 = 32 − 34.165 = − 2.165 e_{6} = 32 - 34.165 = - 2.165 e 6 = 32 − 34.165 = − 2.165 对反应物浓度取低水平、催化剂取高水平,
y ^ = 27.5 + ( 8.33 2 ) ( − 1 ) + ( − 5.00 2 ) ( + 1 ) = 20.835 \hat{y} = 27.5 + \left(\frac{8.33}{2}\right) (- 1) + \left(\frac{-5.00}{2}\right) (+ 1) = 20.835 y ^ = 27.5 + ( 2 8.33 ) ( − 1 ) + ( 2 − 5.00 ) ( + 1 ) = 20.835 以及
e 7 = 18 − 20.835 = − 2.835 e 8 = 19 − 20.835 = − 1.835 e 9 = 23 − 20.835 = 2.165 \begin{array}{l} e_{7} = 18 - 20.835 = - 2.835 \\ e_{8} = 19 - 20.835 = - 1.835 \\ e_{9} = 23 - 20.835 = 2.165 \end{array} e 7 = 18 − 20.835 = − 2.835 e 8 = 19 − 20.835 = − 1.835 e 9 = 23 − 20.835 = 2.165 最后,对两个因子都取高水平,
y ^ = 27.5 + ( 8.33 2 ) ( + 1 ) + ( − 5.00 2 ) ( + 1 ) = 29.165 \hat{y} = 27.5 + \left(\frac{8.33}{2}\right) (+ 1) + \left(\frac{-5.00}{2}\right) (+ 1) = 29.165 y ^ = 27.5 + ( 2 8.33 ) ( + 1 ) + ( 2 − 5.00 ) ( + 1 ) = 29.165 以及
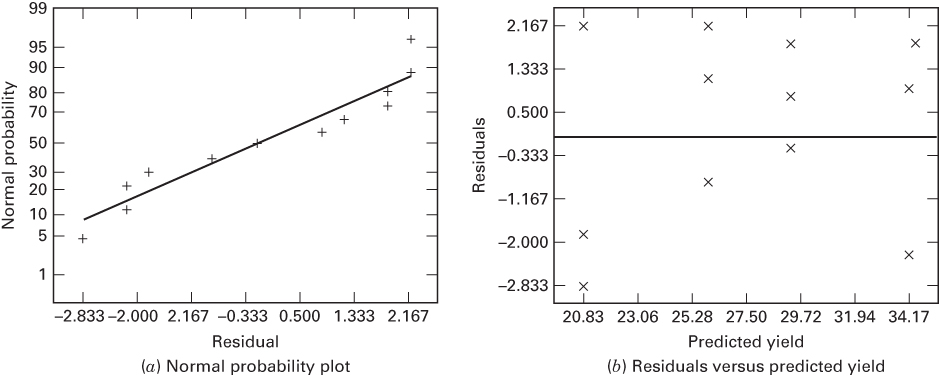
e 10 = 31 − 29.165 = 1.835 e 11 = 30 − 29.165 = 0.835 e 12 = 29 − 29.165 = − 0.165 \begin{array}{l} e_{10} = 31 - 29.165 = 1.835 \\ e_{11} = 30 - 29.165 = 0.835 \\ e_{12} = 29 - 29.165 = - 0.165 \end{array} e 10 = 31 − 29.165 = 1.835 e 11 = 30 − 29.165 = 0.835 e 12 = 29 − 29.165 = − 0.165 图 6.2 给出这些残差的正态概率图以及残差对预测产率的图。这些图形看起来是令人满意的,所以我们没有理由怀疑所得结论的有效性方面存在任何问题。
图 6.2 化学过程试验的残差图
**响应曲面。**回归模型
y ^ = 27.5 + ( 8.33 2 ) x 1 + ( − 5.00 2 ) x 2 \hat{y} = 27.5 + \left(\frac{8.33}{2}\right) x_{1} + \left(\frac{-5.00}{2}\right) x_{2} y ^ = 27.5 + ( 2 8.33 ) x 1 + ( 2 − 5.00 ) x 2 可用于生成响应曲面图。如果希望用自然因子水平来表示这些图,只需把前面给出的自然变量与编码变量之间的关系代入回归模型,得到
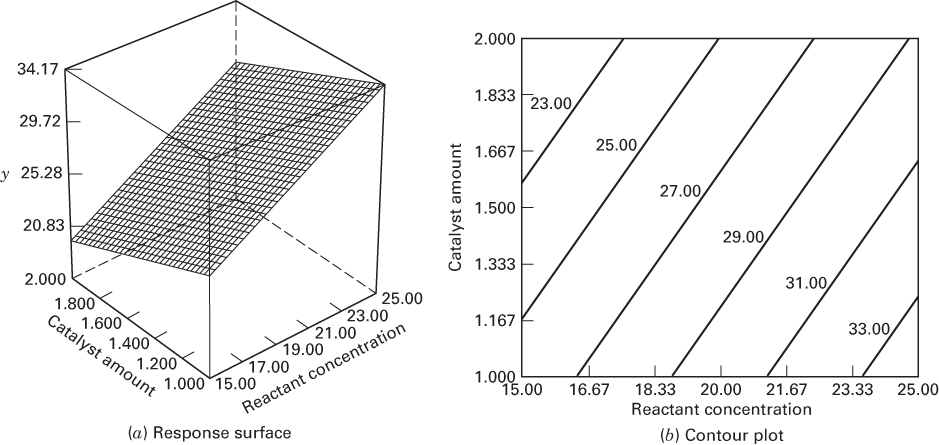
y ^ = 27.5 + ( 8.33 2 ) ( Conc − 20 5 ) + ( − 5.00 2 ) ( Catalyst − 1.5 0.5 ) = 18.33 + 0.8333 Conc − 5.00 Catalyst \begin{array}{l} \hat{y} = 27.5 + \left(\frac{8.33}{2}\right) \left(\frac{\text{Conc} - 20}{5}\right) + \left(\frac{-5.00}{2}\right) \left(\frac{\text{Catalyst} - 1.5}{0.5}\right) \\ = 18.33 + 0.8333 \text{Conc} - 5.00 \text{Catalyst} \end{array} y ^ = 27.5 + ( 2 8.33 ) ( 5 Conc − 20 ) + ( 2 − 5.00 ) ( 0.5 Catalyst − 1.5 ) = 18.33 + 0.8333 Conc − 5.00 Catalyst 图 6.3 化学过程试验产率的响应曲面图与等高线图
图 6.3a 给出该模型产率的三维响应曲面图,图 6.3b 是等高线图。因为模型是一阶的(即只含主效应),拟合的响应曲面是一个平面。考察等高线图可以看到,随着反应物浓度增大、催化剂量减少,产率提高。我们常常用这样的拟合曲面来找出过程潜在改进的方向。一种正规的做法叫最速上升法 (method of steepest ascent),将在第 11 章讨论系统探索响应曲面的方法时介绍。