第 2 章补充材料
S2.1 数据模型与 t 检验 ¶ 教材中给出的模型,即式 (2.23),更恰当的称呼是均值模型 (means model)。由于均值是一个位置参数,这类模型有时也称为位置模型 (location model)。t 检验的模型还有别的写法。一种可能是
y i j = μ + τ i + ε i j { i = 1 , 2 j = 1 , 2 , … , n i y_{ij} = \mu + \tau_{i} + \varepsilon_{ij} \left\{ \begin{array}{c} i = 1, 2 \\ j = 1, 2, \dots, n_{i} \end{array} \right. y ij = μ + τ i + ε ij { i = 1 , 2 j = 1 , 2 , … , n i 其中 μ \mu μ τ i \tau_{i} τ i i i i τ i \tau_{i} τ i i i i 效应模型 (effects model)。
由于均值模型为
y i j = μ i + ε i j { i = 1 , 2 j = 1 , 2 , … , n i y_{ij} = \mu_{i} + \varepsilon_{ij} \left\{ \begin{array}{c} i = 1, 2 \\ j = 1, 2, \dots, n_{i} \end{array} \right. y ij = μ i + ε ij { i = 1 , 2 j = 1 , 2 , … , n i 可以看出,第 i i i μ i = μ + τ i \mu_{i} = \mu + \tau_{i} μ i = μ + τ i i i i i i i
S2.2 模型参数的估计 ¶ 由于在考察设计试验的数据时模型会自然地出现,我们经常需要估计模型参数。我们常用最小二乘 (least squares)法来进行参数估计。这一方法为模型参数选取使误差 ε i j \varepsilon_{ij} ε ij n 1 = n 2 = n n_{1} = n_{2} = n n 1 = n 2 = n
L = ∑ i = 1 2 ∑ j = 1 n ε i j 2 = ∑ i = 1 2 ∑ j = 1 n ( y i j − μ i ) 2 \begin{array}{c} L = \sum_{i=1}^{2} \sum_{j=1}^{n} \varepsilon_{ij}^{2} \\
= \sum_{i=1}^{2} \sum_{j=1}^{n} (y_{ij} - \mu_{i})^{2} \end{array} L = ∑ i = 1 2 ∑ j = 1 n ε ij 2 = ∑ i = 1 2 ∑ j = 1 n ( y ij − μ i ) 2 现在 ∂ L ∂ μ 1 = 2 ∑ j = 1 n ( y 1 j − μ 1 ) \frac{\partial L}{\partial \mu_{1}} = 2 \sum_{j=1}^{n} (y_{1j} - \mu_{1}) ∂ μ 1 ∂ L = 2 ∑ j = 1 n ( y 1 j − μ 1 ) ∂ L ∂ μ 2 = 2 ∑ j = 1 n ( y 2 j − μ 2 ) \frac{\partial L}{\partial \mu_{2}} = 2 \sum_{j=1}^{n} (y_{2j} - \mu_{2}) ∂ μ 2 ∂ L = 2 ∑ j = 1 n ( y 2 j − μ 2 )
n μ ^ 1 = ∑ j = 1 n y 1 j n \hat{\mu}_{1} = \sum_{j=1}^{n} y_{1j} n μ ^ 1 = j = 1 ∑ n y 1 j n μ ^ 2 = ∑ j = 1 n y 2 j n \hat{\mu}_{2} = \sum_{j=1}^{n} y_{2j} n μ ^ 2 = j = 1 ∑ n y 2 j 这些方程的解给出因子水平均值的最小二乘估计量。解为 μ ^ 1 = y ‾ 1 \hat{\mu}_{1} = \overline{y}_{1} μ ^ 1 = y 1 μ ^ 2 = y ‾ 2 \hat{\mu}_{2} = \overline{y}_{2} μ ^ 2 = y 2
这一结果应当是直观的,因为我们在基础统计学课程中很早就知道,样本平均值通常能对总体均值给出合理的估计。然而,正如我们刚刚看到的,这一结果可以很容易地由一个简单的位置模型经最小二乘方法导出。事实证明,如果我们假定模型误差服从正态分布且相互独立,那么样本平均值也是因子水平均值的最大似然估计量 (maximum likelihood estimator)。也就是说,如果观测值服从正态分布,最小二乘与最大似然给出的因子水平均值估计量完全相同。最大似然是一种更一般的参数估计方法,它通常能给出具有优良统计性质的参数估计。
我们也可以把最小二乘法应用于效应模型。假定样本容量相等,最小二乘函数为
L = ∑ i = 1 2 ∑ j = 1 n ε i j 2 = ∑ i = 1 2 ∑ j = 1 n ( y i j − μ − τ i ) 2 \begin{array}{l} L = \sum_{i=1}^{2} \sum_{j=1}^{n} \varepsilon_{ij}^{2} \\
= \sum_{i=1}^{2} \sum_{j=1}^{n} (y_{ij} - \mu - \tau_{i})^{2} \end{array} L = ∑ i = 1 2 ∑ j = 1 n ε ij 2 = ∑ i = 1 2 ∑ j = 1 n ( y ij − μ − τ i ) 2 L L L
∂ L ∂ μ = 2 ∑ i = 1 2 ∑ j = 1 n ( y i j − μ − τ i ) , ∂ L ∂ τ 1 = 2 ∑ j = 1 n ( y 1 j − μ − τ 1 ) , 和 ∂ L ∂ τ 2 = 2 ∑ j = 1 n ( y 2 j − μ − τ 2 ) \frac{\partial L}{\partial \mu} = 2 \sum_{i=1}^{2} \sum_{j=1}^{n} \left(y_{ij} - \mu - \tau_{i}\right), \frac{\partial L}{\partial \tau_{1}} = 2 \sum_{j=1}^{n} \left(y_{1j} - \mu - \tau_{1}\right), \text{和} \frac{\partial L}{\partial \tau_{2}} = 2 \sum_{j=1}^{n} \left(y_{2j} - \mu - \tau_{2}\right) ∂ μ ∂ L = 2 i = 1 ∑ 2 j = 1 ∑ n ( y ij − μ − τ i ) , ∂ τ 1 ∂ L = 2 j = 1 ∑ n ( y 1 j − μ − τ 1 ) , 和 ∂ τ 2 ∂ L = 2 j = 1 ∑ n ( y 2 j − μ − τ 2 ) 令这些偏导数为零,得到如下最小二乘正规方程:
2 n μ ^ + n τ ^ 1 + n τ ^ 2 = ∑ i = 1 2 ∑ j = 1 n y i j 2 n \hat{\mu} + n \hat{\tau}_{1} + n \hat{\tau}_{2} = \sum_{i=1}^{2} \sum_{j=1}^{n} y_{ij} 2 n μ ^ + n τ ^ 1 + n τ ^ 2 = i = 1 ∑ 2 j = 1 ∑ n y ij n μ ^ + n τ ^ 1 = ∑ j = 1 n y 1 j n \hat{\mu} + n \hat{\tau}_{1} = \sum_{j=1}^{n} y_{1j} n μ ^ + n τ ^ 1 = j = 1 ∑ n y 1 j n μ ^ + n τ ^ 2 = ∑ j = 1 n y 2 j n \hat{\mu} + n \hat{\tau}_{2} = \sum_{j=1}^{n} y_{2j} n μ ^ + n τ ^ 2 = j = 1 ∑ n y 2 j 注意,若把上述正规方程中的后两个相加,就得到第一个。也就是说,这些正规方程不是线性独立的,因而没有唯一解。出现这种情况是因为效应模型是过度参数化的 (overparameterized)。这种情形经常发生;也就是说,一个试验的效应模型总是一个过度参数化的模型。
处理这一问题的一种办法是向正规方程中再加入一个线性独立的方程。最常见的做法是使用方程 τ ^ 1 + τ ^ 2 = 0 \hat{\tau}_{1} + \hat{\tau}_{2} = 0 τ ^ 1 + τ ^ 2 = 0 μ \mu μ
μ ^ = y ‾ τ ^ i = y ‾ i − y ‾ , i = 1 , 2 \begin{array}{l} \hat{\mu} = \overline{y} \\
\hat{\tau}_{i} = \overline{y}_{i} - \overline{y}, i = 1, 2 \end{array} μ ^ = y τ ^ i = y i − y , i = 1 , 2 也就是说,总均值由全部 2 n 2n 2 n
这并不是为求解正规方程而选取线性独立“约束”的唯一可能选择。另一种可能是直接把总均值设为一个常数,例如取 μ ^ = 0 \hat{\mu} = 0 μ ^ = 0
μ ^ = 0 τ ^ i = y ‾ i , i = 1 , 2 \begin{array}{l} \hat{\mu} = 0 \\
\hat{\tau}_{i} = \overline{y}_{i}, i = 1, 2 \end{array} μ ^ = 0 τ ^ i = y i , i = 1 , 2 还有一种可能是取 τ ^ 2 = 0 \hat{\tau}_{2} = 0 τ ^ 2 = 0
μ ^ = y ‾ 2 τ ^ 1 = y ‾ 1 − y ‾ 2 τ ^ 2 = 0 \begin{array}{c} \hat{\mu} = \overline{y}_{2} \\
\hat{\tau}_{1} = \overline{y}_{1} - \overline{y}_{2} \\
\hat{\tau}_{2} = 0 \end{array} μ ^ = y 2 τ ^ 1 = y 1 − y 2 τ ^ 2 = 0 可用于求解正规方程的约束有无限多种。一个显而易见的问题是:“我们该用哪个解?”事实证明,这其实无关紧要。对上面三个解中的每一个(实际上对正规方程的任何解都一样),都有
μ ^ i = μ ^ + τ ^ i = y ‾ i , i = 1 , 2 \hat{\mu}_{i} = \hat{\mu} + \hat{\tau}_{i} = \overline{y}_{i}, i = 1, 2 μ ^ i = μ ^ + τ ^ i = y i , i = 1 , 2 也就是说,第 i i i i i i 可估的 (estimable)。模型参数的任何函数,只要无论选取哪个约束来求解正规方程都能被唯一地估计,就称为可估函数 (estimable function)。第 3 章将对这一点作更详细的讨论。
S2.3 用回归模型方法处理 t 检验 ¶ 两样本 t t t t t t
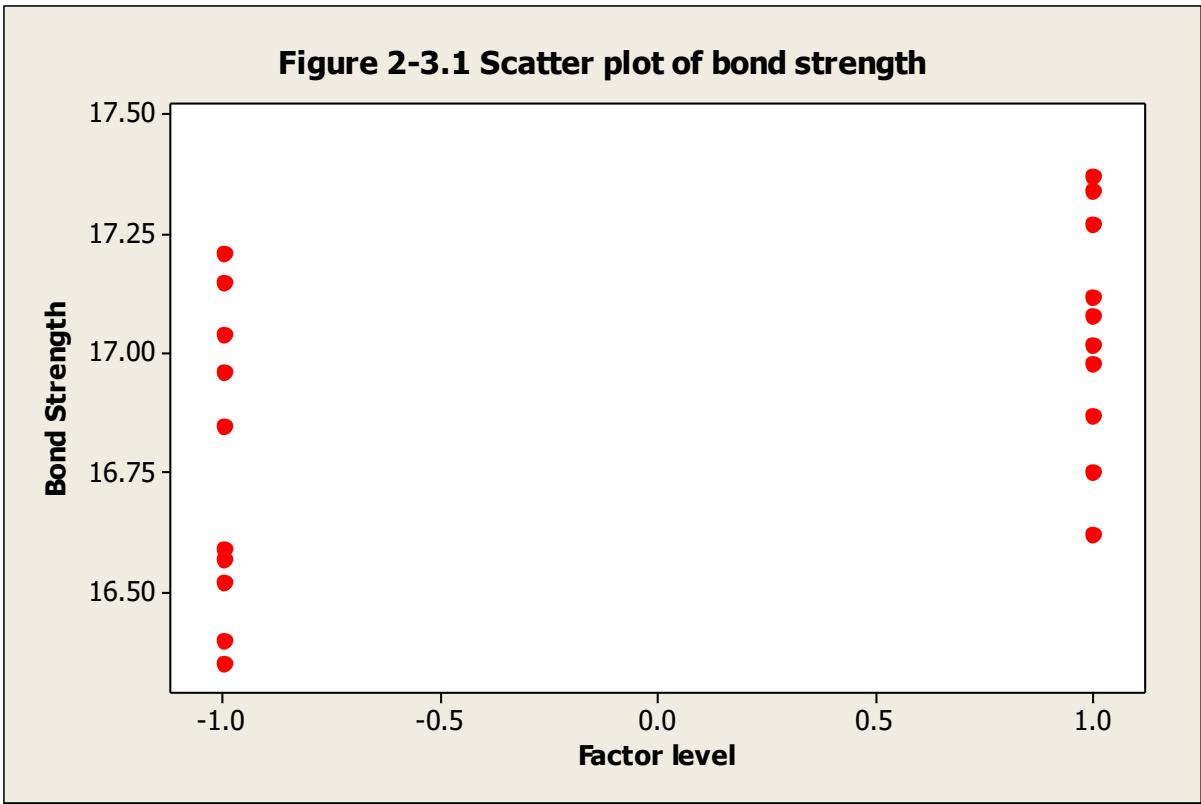
在 t t t x x x x = − 1 x = -1 x = − 1 x = + 1 x = +1 x = + 1
我们对该数据拟合一个简单线性回归模型,例如
y i j = β 0 + β 1 x i j + ε i j y_{ij} = \beta_{0} + \beta_{1} x_{ij} + \varepsilon_{ij} y ij = β 0 + β 1 x ij + ε ij 其中 β 0 \beta_{0} β 0 β 1 \beta_{1} β 1 x 1 j = − 1 x_{1j} = -1 x 1 j = − 1 x 2 j = + 1 x_{2j} = +1 x 2 j = + 1 n n n
2 n β ^ 0 = ∑ i = 1 2 ∑ j = 1 n y i j 2 n \hat{\beta}_{0} = \sum_{i=1}^{2} \sum_{j=1}^{n} y_{ij} 2 n β ^ 0 = i = 1 ∑ 2 j = 1 ∑ n y ij 2 n β ^ 1 = ∑ j = 1 n y 2 j − ∑ j = 1 n y 1 j 2 n \hat{\beta}_{1} = \sum_{j=1}^{n} y_{2j} - \sum_{j=1}^{n} y_{1j} 2 n β ^ 1 = j = 1 ∑ n y 2 j − j = 1 ∑ n y 1 j 这些方程的解为
Regression Analysis: Bond Strength versus Factor level
The regression equation is
Bond Strength = 16.9 + 0.139 Factor level
Predictor Coef SE Coef T P
Constant 16.9030 0.0636 265.93 0.000
Factor level 0.13900 0.06356 2.19 0.042
S = 0.284253 R-Sq = 21.0% R-Sq(adj) = 16.6%
Analysis of Variance
Source DF SS MS F P
Regression 1 0.38642 0.38642 4.78 0.042
Residual Error 18 1.45440 0.08080
Total 19 1.84082
β ^ 0 = y ‾ β ^ 1 = 1 2 ( y ‾ 2 − y ‾ 1 ) \begin{array}{l} \hat{\beta}_{0} = \overline{y} \\
\hat{\beta}_{1} = \frac{1}{2} (\overline{y}_{2} - \overline{y}_{1}) \end{array} β ^ 0 = y β ^ 1 = 2 1 ( y 2 − y 1 ) 注意,截距的最小二乘估计量是两个样本中全部观测值的平均值,而斜率的估计量是因子 x x x
注意,斜率的估计值(位于上文标有“Coef”的列、标有“Factor level”的行)为 0.139 = 1 2 ( y ‾ 2 − y ‾ 1 ) = 1 2 ( 17.0420 − 16.7640 ) 0.139 = \frac{1}{2}(\overline{y}_{2} - \overline{y}_{1}) = \frac{1}{2}(17.0420 - 16.7640) 0.139 = 2 1 ( y 2 − y 1 ) = 2 1 ( 17.0420 − 16.7640 ) t t t t t t t t t
H 0 : β 1 = 0 H 1 : β 1 ≠ 0 \begin{array}{l} H_{0}: \beta_{1} = 0 \\
H_{1}: \beta_{1} \neq 0 \end{array} H 0 : β 1 = 0 H 1 : β 1 = 0 而这等价于检验 H 0 : μ 1 = μ 2 H_{0}: \mu_{1} = \mu_{2} H 0 : μ 1 = μ 2
容易证明,简单线性回归中用于检验斜率等于零的 t t t t t t t t t
t 0 = β ^ 1 σ ^ 2 S x x t_{0} = \frac{\hat{\beta}_{1}}{\sqrt{\frac{\hat{\sigma}^{2}}{S_{xx}}}} t 0 = S xx σ ^ 2 β ^ 1 其中 S x x = ∑ i = 1 2 ∑ j = 1 n ( x i j − x ‾ ) 2 S_{xx} = \sum_{i=1}^{2} \sum_{j=1}^{n} (x_{ij} - \overline{x})^{2} S xx = ∑ i = 1 2 ∑ j = 1 n ( x ij − x ) 2 x x x x ‾ = 0 \overline{x} = 0 x = 0 x 1 j = − 1 x_{1j} = -1 x 1 j = − 1 x 2 j = + 1 x_{2j} = +1 x 2 j = + 1 S x x = 2 n S_{xx} = 2n S xx = 2 n σ \sigma σ S p S_{p} S p
t 0 = β ^ 1 σ ^ 2 S x x = 1 2 ( y ˉ 2 − y ˉ 1 ) S p 1 2 n = y ˉ 2 − y ˉ 1 S p 2 n t_{0} = \frac{\hat{\beta}_{1}}{\sqrt{\frac{\hat{\sigma}^{2}}{S_{xx}}}} = \frac{\frac{1}{2}\left(\bar{y}_{2} - \bar{y}_{1}\right)}{S_{p} \sqrt{\frac{1}{2n}}} = \frac{\bar{y}_{2} - \bar{y}_{1}}{S_{p} \sqrt{\frac{2}{n}}} t 0 = S xx σ ^ 2 β ^ 1 = S p 2 n 1 2 1 ( y ˉ 2 − y ˉ 1 ) = S p n 2 y ˉ 2 − y ˉ 1 这就是样本容量相等情形下通常的两样本 t t t
S2.4 正态概率图的构造 ¶ 虽然我们通常用计算机软件程序来生成正态概率图,但偶尔也需要手工构造它们。幸运的是,这相对容易做到,因为专用的正态概率坐标纸(normal probability plotting paper)很容易获得。它其实就是一种方格纸,其纵向(或概率)坐标的刻度经过安排,使得如果我们把累积正态概率 ( j − 0.5 ) / n (j - 0.5)/n ( j − 0.5 ) / n y ( j ) y_{(j)} y ( j )
j j j y ( j ) y_{(j)} y ( j ) ( j − 0.5 ) / 10 (j-0.5)/10 ( j − 0.5 ) /10 z ( j ) z(j) z ( j ) 1 16.62 0.05 -1.64 2 16.75 0.15 -1.04 3 16.87 0.25 -0.67 4 16.98 0.35 -0.39 5 17.02 0.45 -0.13 6 17.08 0.55 0.13 7 17.12 0.65 0.39 8 17.27 0.75 0.67 9 17.34 0.85 1.04 10 17.37 0.95 1.64
现在,如果我们在正态概率纸上把上表倒数第二列中的累积概率对第二列中排序后的观测值作图,就会得到与教材图 2.11 中未改进砂浆配方结果完全相同的图形。
正态概率图也可以在普通方格纸上构造,做法是把标准正态 z z z z ( j ) z(j) z ( j ) z z z
P ( Z ≤ z j ) = Φ ( z j ) = j − 0.5 n P(Z \leq z_{j}) = \Phi(z_{j}) = \frac{j - 0.5}{n} P ( Z ≤ z j ) = Φ ( z j ) = n j − 0.5 其中 Φ ( ∙ ) \Phi(\bullet) Φ ( ∙ ) ( j − 0.5 ) / n = 0.05 (j - 0.5)/n = 0.05 ( j − 0.5 ) / n = 0.05 Φ ( z j ) = 0.05 \Phi(z_{j}) = 0.05 Φ ( z j ) = 0.05 z j = − 1.64 z_{j} = -1.64 z j = − 1.64 z z z
S2.5 关于检验 t 检验假定的更多内容 ¶ 我们在教材中指出,观测值的正态概率图是检验 t t t
回忆一下,均值模型为
y i j = μ i + ε i j { i = 1 , 2 j = 1 , 2 , … , n i y_{ij} = \mu_{i} + \varepsilon_{ij} \left\{ \begin{array}{c} i = 1, 2 \\ j = 1, 2, \dots, n_{i} \end{array} \right. y ij = μ i + ε ij { i = 1 , 2 j = 1 , 2 , … , n i 而该模型中参数(因子水平均值)的估计量就是样本平均值。因此,我们可以说拟合模型为
y ^ i j = y ‾ i , i = 1 , 2 且 j = 1 , 2 , … , n i \hat{y}_{ij} = \overline{y}_{i}, i = 1, 2 \text{ 且 } j = 1, 2, \dots, n_{i} y ^ ij = y i , i = 1 , 2 且 j = 1 , 2 , … , n i 也就是说,第 i j ij ij i i i 残差 (residual),即
e i j = y i j − y ^ i , i = 1 , 2. e_{ij} = y_{ij} - \hat{y}_{i}, i = 1, 2. e ij = y ij − y ^ i , i = 1 , 2. 下表计算了波特兰水泥砂浆拉伸粘结强度数据的残差值。
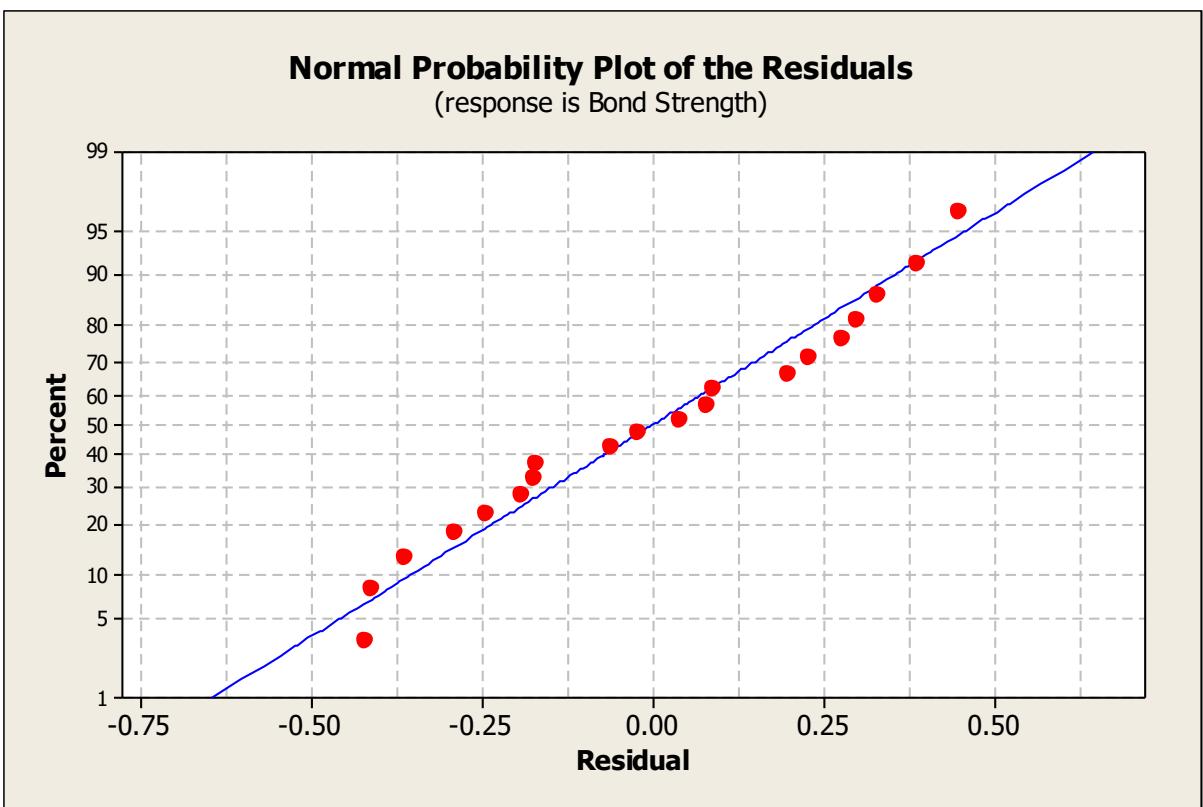
观测值 j j j y 1 j y_{1j} y 1 j e 1 j = y 1 j − y ‾ 1 = y 1 j − 16.76 e_{1j}=y_{1j}-\overline{y}_{1}=y_{1j}-16.76 e 1 j = y 1 j − y 1 = y 1 j − 16.76 y 2 j y_{2j} y 2 j e 2 j = y 2 j − y ‾ 2 = y 2 j − 17.04 e_{2j}=y_{2j}-\overline{y}_{2}=y_{2j}-17.04 e 2 j = y 2 j − y 2 = y 2 j − 17.04 1 16.85 0.09 16.62 -0.42 2 16.40 -0.36 16.75 -0.29 3 17.21 0.45 17.37 0.33 4 16.35 -0.41 17.12 0.08 5 16.52 -0.24 16.98 -0.06 6 17.04 0.28 16.87 -0.17 7 16.96 0.20 17.34 0.30 8 17.15 0.39 17.02 -0.02 9 16.59 -0.17 17.08 0.04 10 16.57 -0.19 17.27 0.23
下图是这些残差由 Minitab 绘制的正态概率图。
正如上文 S2.3 节所述,我们可以用简单线性回归模型的方法来计算 t t t
观测序号 因子水平 粘结强度 拟合值 拟合值标准误 残差 标准化残差 1 -1.00 16.8500 16.7640 0.0899 0.0860 0.32 2 -1.00 16.4000 16.7640 0.0899 -0.3640 -1.35 3 -1.00 17.2100 16.7640 0.0899 0.4460 1.65 4 -1.00 16.3500 16.7640 0.0899 -0.4140 -1.54 5 -1.00 16.5200 16.7640 0.0899 -0.2440 -0.90 6 -1.00 17.0400 16.7640 0.0899 0.2760 1.02 7 -1.00 16.9600 16.7640 0.0899 0.1960 0.73 8 -1.00 17.1500 16.7640 0.0899 0.3860 1.43 9 -1.00 16.5900 16.7640 0.0899 -0.1740 -0.65 10 -1.00 16.5700 16.7640 0.0899 -0.1940 -0.72 11 1.00 16.6200 17.0420 0.0899 -0.4220 -1.56 12 1.00 16.7500 17.0420 0.0899 -0.2920 -1.08 13 1.00 17.3700 17.0420 0.0899 0.3280 1.22 14 1.00 17.1200 17.0420 0.0899 0.0780 0.29 15 1.00 16.9800 17.0420 0.0899 -0.0620 -0.23 16 1.00 16.8700 17.0420 0.0899 -0.1720 -0.64 17 1.00 17.3400 17.0420 0.0899 0.2980 1.11 18 1.00 17.0200 17.0420 0.0899 -0.0220 -0.08 19 1.00 17.0800 17.0420 0.0899 0.0380 0.14 20 1.00 17.2700 17.0420 0.0899 0.2280 0.85
表中标有“拟合值”(Fit)的那一列包含了两个样本的均值,并计算到四位小数。表中第六列的残差与我们手工计算的结果相同(仅因舍入而略有差异)。
S2.6 关于配对 t 检验的更多信息 ¶ 配对 t t t μ d \mu_{d} μ d μ 1 − μ 2 \mu_{1} - \mu_{2} μ 1 − μ 2 d ˉ \bar{d} d ˉ
V ( d ‾ ) = V ( y ‾ 1 − y ‾ 2 ) = V ( y ‾ 1 ) + V ( y ‾ 2 ) − 2 C o v ( y ‾ 1 , y ‾ 2 ) = 2 σ 2 ( 1 − ρ ) n \begin{array}{r l} V(\overline{d}) & = V(\overline{y}_{1} - \overline{y}_{2}) \\ & = V(\overline{y}_{1}) + V(\overline{y}_{2}) - 2 Cov(\overline{y}_{1}, \overline{y}_{2}) \\ & = \frac{2 \sigma^{2} (1 - \rho)}{n} \end{array} V ( d ) = V ( y 1 − y 2 ) = V ( y 1 ) + V ( y 2 ) − 2 C o v ( y 1 , y 2 ) = n 2 σ 2 ( 1 − ρ ) 这里假定两个总体具有相同的方差 σ 2 \sigma^{2} σ 2 ρ \rho ρ y 1 y_{1} y 1 y 2 y_{2} y 2 S d 2 / n S_{d}^{2}/n S d 2 / n d ˉ \bar{d} d ˉ y 1 y_{1} y 1 y 2 y_{2} y 2 t t t t t t
还要注意,虽然为方便起见我们假定了两个总体方差相等,但这一假定实际上并不必要。当两个总体的方差不同时,配对 t t t