2.2 基本统计概念
上面所述波特兰水泥试验中的每一个观测值都称为一次运行 (run)。注意各次运行互不相同,因此所观测到的粘结强度中存在波动或噪声。这种噪声通常称为试验误差 (experimental error)或简称为误差 。它是一种统计误差,意即它来自不受控制且通常无法避免的变异。误差或噪声的存在意味着响应变量——拉伸粘结强度——是一个随机变量 (random variable)。随机变量可以是离散的 或连续的 。如果随机变量所有可能取值的集合是有限集或可数无限集,则该随机变量是离散的;如果其所有可能取值的集合是一个区间,则该随机变量是连续的。
变异的图形描述。 我们常常用简单的图形方法来辅助分析试验数据。图 2.1 所示的点图是展示少量数据(比如最多约 20 个观测值)的非常有用的工具。点图使试验者能够迅速看出观测值的大致位置(集中趋势)及其散布或变异。例如,在波特兰水泥拉伸粘结试验中,点图显示两种配方的平均强度可能不同,但两种配方产生的强度变异大致相同。
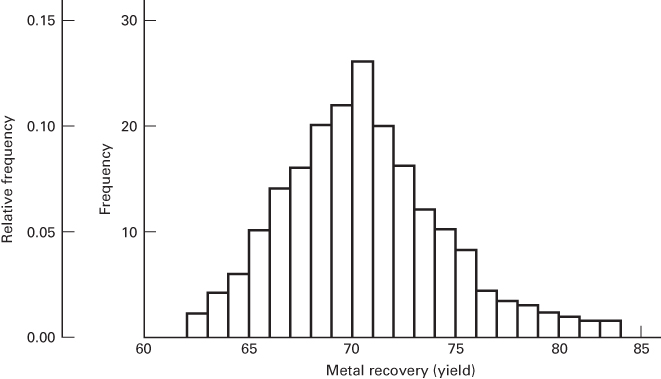
图 2.2 某熔炼过程金属回收率(收率)的 200 个观测值的直方图
如果数据相当多,点图中的点就难以区分,此时直方图 (histogram)可能更好。图 2.2 给出了某熔炼过程金属回收率(收率)的 200 个观测值的直方图。直方图显示了数据中心趋势、散布以及分布的大致形状。回忆一下,直方图是这样构造的:把横轴分成若干组距 (bin,通常等长),在第 j j j n j n_{j} n j
箱线图 (box plot,或称箱须图)是一种非常有用的数据展示方式。箱线图在一个水平或垂直放置的矩形箱上显示最小值、最大值、下四分位数和上四分位数(分别为第 25 百分位数和第 75 百分位数)以及中位数(第 50 百分位数)。箱体从下四分位数延伸到上四分位数,并在中位数处画一条穿过箱体的线。从箱体两端向外延伸的线(即须 ,whisker)通常画到最小值和最大值。[箱线图有若干变体,它们标出极端样本点的规则不同,更多细节见 Montgomery 和 Runger(2018)。]
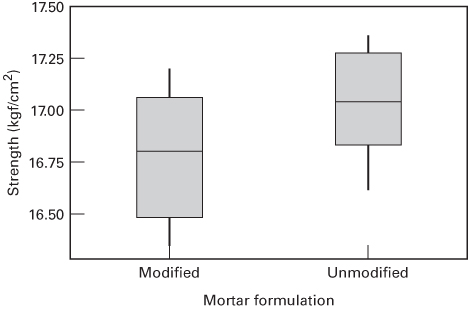
图 2.3 给出了波特兰水泥砂浆试验中两个拉伸粘结强度样本的箱线图。这一图形显示两种配方的平均强度存在某些差异,同时也显示两种配方产生的强度分布都相当对称、变异或散布相近。
图 2.3 波特兰水泥拉伸粘结强度试验的箱线图
点图、直方图和箱线图有助于概括样本数据中的信息。为了更完整地描述样本中可能出现的观测值,我们要使用概率分布 的概念。
概率分布。 随机变量(记为 y y y y y y p ( y ) p(y) p ( y ) y y y 概率质量函数 (probability mass function)。如果 y y y f ( y ) f(y) f ( y ) y y y 概率密度函数 (probability density function)。
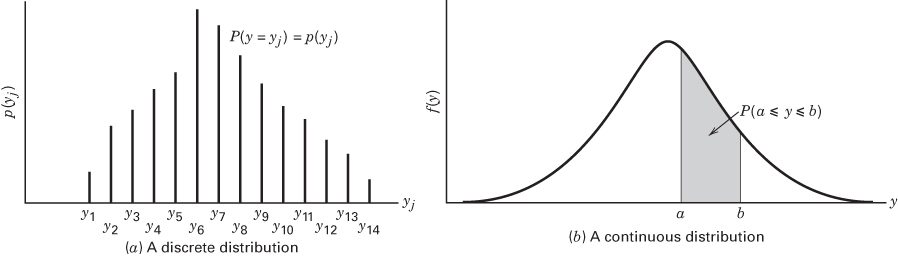
图 2.4 给出了假想的离散和连续概率分布。注意,在离散概率分布图 2.4a 中,代表概率的是函数 p ( y j ) p(y_{j}) p ( y j ) f ( y ) f(y) f ( y )
y 离散: 0 ≤ p ( y j ) ≤ 1 P ( y = y j ) = p ( y j ) ∑ 所有 y j 取值 p ( y j ) = 1 \begin{array}{ll}
y \ \text{离散:} & 0 \leq p(y_{j}) \leq 1 \\
& P(y=y_{j}) = p(y_{j}) \\
& \sum_{\text{所有 } y_{j} \text{ 取值}} p(y_{j}) = 1
\end{array} y 离散: 0 ≤ p ( y j ) ≤ 1 P ( y = y j ) = p ( y j ) ∑ 所有 y j 取值 p ( y j ) = 1 y y y
P ( a ≤ y ≤ b ) = ∫ a b f ( y ) d y ∫ − ∞ ∞ f ( y ) d y = 1 \begin{array}{l}
P(a \leq y \leq b) = \int_{a}^{b} f(y)\,dy \\
\int_{-\infty}^{\infty} f(y)\,dy = 1
\end{array} P ( a ≤ y ≤ b ) = ∫ a b f ( y ) d y ∫ − ∞ ∞ f ( y ) d y = 1 均值、方差与期望值。 概率分布的均值 μ \mu μ
μ = { ∫ − ∞ ∞ y f ( y ) d y y 连续 ∑ 所有 y y p ( y j ) y 离散 (2.1) \mu = \left\{ \begin{array}{ll}
\int_{-\infty}^{\infty} y f(y)\,dy & y \text{ 连续} \\
\sum_{\text{所有 } y} y p(y_{j}) & y \text{ 离散}
\end{array} \right. \tag{2.1} μ = { ∫ − ∞ ∞ y f ( y ) d y ∑ 所有 y y p ( y j ) y 连续 y 离散 ( 2.1 ) 我们也可以用随机变量 y y y 期望值 (expected value),即其长期平均值,来表示均值:
μ = E ( y ) = { ∫ − ∞ ∞ y f ( y ) d y y 连续 ∑ 所有 y y p ( y j ) y 离散 (2.2) \mu = E(y) = \left\{ \begin{array}{ll}
\int_{-\infty}^{\infty} y f(y)\,dy & y \text{ 连续} \\
\sum_{\text{所有 } y} y p(y_{j}) & y \text{ 离散}
\end{array} \right. \tag{2.2} μ = E ( y ) = { ∫ − ∞ ∞ y f ( y ) d y ∑ 所有 y y p ( y j ) y 连续 y 离散 ( 2.2 ) 其中 E E E
图 2.4 离散和连续概率分布
概率分布的变异或离散程度可以用方差 来度量,其定义为
σ 2 = { ∫ − ∞ ∞ ( y − μ ) 2 f ( y ) d y y 连续 ∑ 所有 y ( y − μ ) 2 p ( y j ) y 离散 (2.3) \sigma^{2} = \left\{ \begin{array}{ll}
\int_{-\infty}^{\infty} (y-\mu)^{2} f(y)\,dy & y \text{ 连续} \\
\sum_{\text{所有 } y} (y-\mu)^{2} p(y_{j}) & y \text{ 离散}
\end{array} \right. \tag{2.3} σ 2 = { ∫ − ∞ ∞ ( y − μ ) 2 f ( y ) d y ∑ 所有 y ( y − μ ) 2 p ( y j ) y 连续 y 离散 ( 2.3 ) 注意,方差可以完全用期望来表示,因为
σ 2 = E [ ( y − μ ) 2 ] (2.4) \sigma^{2} = E[(y-\mu)^{2}] \tag{2.4} σ 2 = E [( y − μ ) 2 ] ( 2.4 ) 最后,由于方差被如此广泛地使用,我们不妨定义一个方差算子 V V V
V ( y ) = E [ ( y − μ ) 2 ] = σ 2 (2.5) V(y) = E[(y-\mu)^{2}] = \sigma^{2} \tag{2.5} V ( y ) = E [( y − μ ) 2 ] = σ 2 ( 2.5 ) 期望值和方差这两个概念在本书中通篇使用,回顾若干关于这些算子的初等结果可能是有帮助的。如果 y y y μ \mu μ σ 2 \sigma^{2} σ 2 c c c
1. E ( c ) = c 2. E ( y ) = μ 3. E ( c y ) = c E ( y ) = c μ 4. V ( c ) = 0 5. V ( y ) = σ 2 6. V ( c y ) = c 2 V ( y ) = c 2 σ 2 \begin{array}{l}
\textbf{1.}\ E(c) = c \\
\textbf{2.}\ E(y) = \mu \\
\textbf{3.}\ E(cy) = cE(y) = c\mu \\
\textbf{4.}\ V(c) = 0 \\
\textbf{5.}\ V(y) = \sigma^{2} \\
\textbf{6.}\ V(cy) = c^{2}V(y) = c^{2}\sigma^{2}
\end{array} 1. E ( c ) = c 2. E ( y ) = μ 3. E ( cy ) = c E ( y ) = c μ 4. V ( c ) = 0 5. V ( y ) = σ 2 6. V ( cy ) = c 2 V ( y ) = c 2 σ 2 如果有两个随机变量,比如 y 1 y_{1} y 1 E ( y 1 ) = μ 1 E(y_{1})=\mu_{1} E ( y 1 ) = μ 1 V ( y 1 ) = σ 1 2 V(y_{1})=\sigma_{1}^{2} V ( y 1 ) = σ 1 2 y 2 y_{2} y 2 E ( y 2 ) = μ 2 E(y_{2})=\mu_{2} E ( y 2 ) = μ 2 V ( y 2 ) = σ 2 2 V(y_{2})=\sigma_{2}^{2} V ( y 2 ) = σ 2 2
7. E ( y 1 + y 2 ) = E ( y 1 ) + E ( y 2 ) = μ 1 + μ 2 \textbf{7.}\ E(y_{1}+y_{2}) = E(y_{1})+E(y_{2}) = \mu_{1}+\mu_{2} 7. E ( y 1 + y 2 ) = E ( y 1 ) + E ( y 2 ) = μ 1 + μ 2 可以证明
8. V ( y 1 + y 2 ) = V ( y 1 ) + V ( y 2 ) + 2 Cov ( y 1 , y 2 ) \textbf{8.}\ V(y_{1}+y_{2}) = V(y_{1})+V(y_{2})+2\operatorname{Cov}(y_{1},y_{2}) 8. V ( y 1 + y 2 ) = V ( y 1 ) + V ( y 2 ) + 2 Cov ( y 1 , y 2 ) 其中
Cov ( y 1 , y 2 ) = E [ ( y 1 − μ 1 ) ( y 2 − μ 2 ) ] (2.6) \operatorname{Cov}(y_{1},y_{2}) = E[(y_{1}-\mu_{1})(y_{2}-\mu_{2})] \tag{2.6} Cov ( y 1 , y 2 ) = E [( y 1 − μ 1 ) ( y 2 − μ 2 )] ( 2.6 ) 是随机变量 y 1 y_{1} y 1 y 2 y_{2} y 2 协方差 (covariance)。协方差是 y 1 y_{1} y 1 y 2 y_{2} y 2 y 1 y_{1} y 1 y 2 y_{2} y 2 独立 ,[1] Cov ( y 1 , y 2 ) = 0 \operatorname{Cov}(y_{1},y_{2})=0 Cov ( y 1 , y 2 ) = 0
9. V ( y 1 − y 2 ) = V ( y 1 ) + V ( y 2 ) − 2 Cov ( y 1 , y 2 ) \textbf{9.}\ V(y_{1}-y_{2}) = V(y_{1})+V(y_{2})-2\operatorname{Cov}(y_{1},y_{2}) 9. V ( y 1 − y 2 ) = V ( y 1 ) + V ( y 2 ) − 2 Cov ( y 1 , y 2 ) 若 y 1 y_{1} y 1 y 2 y_{2} y 2
10. V ( y 1 ± y 2 ) = V ( y 1 ) + V ( y 2 ) = σ 1 2 + σ 2 2 \textbf{10.}\ V(y_{1} \pm y_{2}) = V(y_{1})+V(y_{2}) = \sigma_{1}^{2}+\sigma_{2}^{2} 10. V ( y 1 ± y 2 ) = V ( y 1 ) + V ( y 2 ) = σ 1 2 + σ 2 2 并且
11. E ( y 1 ⋅ y 2 ) = E ( y 1 ) ⋅ E ( y 2 ) = μ 1 ⋅ μ 2 \textbf{11.}\ E(y_{1} \cdot y_{2}) = E(y_{1}) \cdot E(y_{2}) = \mu_{1} \cdot \mu_{2} 11. E ( y 1 ⋅ y 2 ) = E ( y 1 ) ⋅ E ( y 2 ) = μ 1 ⋅ μ 2 然而要注意,一般而言
12. E ( y 1 y 2 ) ≠ E ( y 1 ) E ( y 2 ) \textbf{12.}\ E\left(\frac{y_{1}}{y_{2}}\right) \neq \frac{E(y_{1})}{E(y_{2})} 12. E ( y 2 y 1 ) = E ( y 2 ) E ( y 1 ) 无论 y 1 y_{1} y 1 y 2 y_{2} y 2