2.4 关于均值差的推断:随机化设计
现在我们回到 2.1 节提出的波特兰水泥砂浆问题。回忆一下,我们在研究两种不同的砂浆配方,以判断它们在拉伸粘结强度上是否有差异。本节讨论如何用假设检验和置信区间方法来分析这一简单比较试验的数据,以比较两个处理的均值。
在本节中,我们始终假定使用的是完全随机化试验设计 。在这种设计中,数据被看作来自正态分布的随机样本。随机样本这一假定非常重要。
2.4.1 假设检验 ¶ 现在我们重新考虑 2.1 节引入的波特兰水泥试验。回忆一下,我们感兴趣的是比较两种不同配方的强度:未改进砂浆和改进砂浆。一般地,我们可以把这两种配方看作“配方”因子的两个水平。令 y 11 , y 12 , … , y 1 n 1 y_{11}, y_{12}, \ldots, y_{1n_{1}} y 11 , y 12 , … , y 1 n 1 n 1 n_{1} n 1 y 21 , y 22 , … , y 2 n 2 y_{21}, y_{22}, \ldots, y_{2n_{2}} y 21 , y 22 , … , y 2 n 2 n 2 n_{2} n 2
数据的模型。 我们常用模型来描述试验的结果。描述上述这类试验数据的一个简单统计模型是
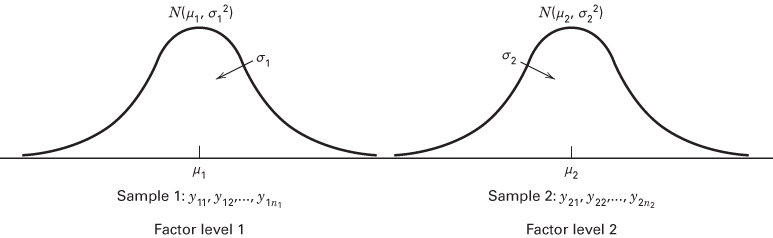
y i j = μ i + ε i j { i = 1 , 2 j = 1 , 2 , … , n i (2.23) y_{ij} = \mu_{i} + \varepsilon_{ij} \quad \left\{ \begin{array}{ll} i = 1, 2 \\ j = 1, 2, \ldots, n_{i} \end{array} \right. \tag{2.23} y ij = μ i + ε ij { i = 1 , 2 j = 1 , 2 , … , n i ( 2.23 ) 图 2.9 两样本 t t t
其中 y i j y_{ij} y ij i i i j j j μ i \mu_{i} μ i i i i ε i j \varepsilon_{ij} ε ij i j ij ij ε i j \varepsilon_{ij} ε ij N I D ( 0 , σ i 2 ) \mathrm{NID}(0,\sigma_{i}^{2}) NID ( 0 , σ i 2 ) i = 1 , 2 i=1,2 i = 1 , 2 ε i j \varepsilon_{ij} ε ij 随机误差分量 。由于均值 μ 1 \mu_{1} μ 1 μ 2 \mu_{2} μ 2 y i j y_{ij} y ij N I D ( μ i , σ i 2 ) \mathrm{NID}(\mu_{i},\sigma_{i}^{2}) NID ( μ i , σ i 2 ) i = 1 , 2 i=1,2 i = 1 , 2
统计假设。 统计假设 (statistical hypothesis)是关于概率分布的参数或模型的参数的陈述。假设反映了对问题情境的某种猜想。例如,在波特兰水泥试验中,我们可能认为两种砂浆配方的平均拉伸粘结强度相等。这可以正式表述为
H 0 : μ 1 = μ 2 H 1 : μ 1 ≠ μ 2 \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} \\
H_{1}: \mu_{1} \neq \mu_{2}
\end{array} H 0 : μ 1 = μ 2 H 1 : μ 1 = μ 2 其中 μ 1 \mu_{1} μ 1 μ 2 \mu_{2} μ 2 H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 原假设 (null hypothesis),H 1 : μ 1 ≠ μ 2 H_{1}:\mu_{1}\neq\mu_{2} H 1 : μ 1 = μ 2 备择假设 (alternative hypothesis)。这里给出的备择假设称为双侧备择假设 ,因为无论 μ 1 < μ 2 \mu_{1}<\mu_{2} μ 1 < μ 2 μ 1 > μ 2 \mu_{1}>\mu_{2} μ 1 > μ 2
为了检验假设,我们要设计一个程序:抽取随机样本,计算适当的检验统计量 ,然后根据检验统计量的计算值拒绝或不拒绝原假设 H 0 H_{0} H 0 H 0 H_{0} H 0 临界域 或拒绝域 (critical region 或 rejection region)。
检验假设时可能犯两类错误。若原假设为真却被拒绝,就犯了第 I 类错误 (type I error)。若原假设为假却未被拒绝,就犯了第 II 类错误 (type II error)。这两类错误的概率用专门的符号表示:
α = P ( 第 I 类错误 ) = P ( 拒绝 H 0 ∣ H 0 为真 ) β = P ( 第 II 类错误 ) = P ( 不拒绝 H 0 ∣ H 0 为假 ) \begin{array}{l}
\alpha = P(\text{第 I 类错误}) = P(\text{拒绝 } H_{0} \mid H_{0} \text{ 为真}) \\
\beta = P(\text{第 II 类错误}) = P(\text{不拒绝 } H_{0} \mid H_{0} \text{ 为假})
\end{array} α = P ( 第 I 类错误 ) = P ( 拒绝 H 0 ∣ H 0 为真 ) β = P ( 第 II 类错误 ) = P ( 不拒绝 H 0 ∣ H 0 为假 ) 有时更方便的做法是使用检验的功效 (power),即
功效 = 1 − β = P ( 拒绝 H 0 ∣ H 0 为假 ) \text{功效} = 1-\beta = P(\text{拒绝 } H_{0} \mid H_{0} \text{ 为假}) 功效 = 1 − β = P ( 拒绝 H 0 ∣ H 0 为假 ) 假设检验的一般程序是:先指定第 I 类错误概率 α \alpha α 显著性水平 ),然后设计检验程序使第 II 类错误概率 β \beta β
两样本 t t t 假设我们可以假定两种砂浆配方的拉伸粘结强度方差相同,那么完全随机化设计中用来比较两个处理均值的适当检验统计量是
t 0 = y ‾ 1 − y ‾ 2 S p 1 n 1 + 1 n 2 (2.24) t_{0} = \frac{\overline{y}_{1}-\overline{y}_{2}}{S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}}} \tag{2.24} t 0 = S p n 1 1 + n 2 1 y 1 − y 2 ( 2.24 ) 其中 y ‾ 1 \overline{y}_{1} y 1 y ‾ 2 \overline{y}_{2} y 2 n 1 n_{1} n 1 n 2 n_{2} n 2 S p 2 S_{p}^{2} S p 2 σ 1 2 = σ 2 2 = σ 2 \sigma_{1}^{2}=\sigma_{2}^{2}=\sigma^{2} σ 1 2 = σ 2 2 = σ 2
S p 2 = ( n 1 − 1 ) S 1 2 + ( n 2 − 1 ) S 2 2 n 1 + n 2 − 2 (2.25) S_{p}^{2} = \frac{(n_{1}-1)S_{1}^{2}+(n_{2}-1)S_{2}^{2}}{n_{1}+n_{2}-2} \tag{2.25} S p 2 = n 1 + n 2 − 2 ( n 1 − 1 ) S 1 2 + ( n 2 − 1 ) S 2 2 ( 2.25 ) S 1 2 S_{1}^{2} S 1 2 S 2 2 S_{2}^{2} S 2 2 S p 1 n 1 + 1 n 2 S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}} S p n 1 1 + n 2 1 标准误 ,简记为 s e ( y ‾ 1 − y ‾ 2 ) se(\overline{y}_{1}-\overline{y}_{2}) se ( y 1 − y 2 ) H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 t 0 t_{0} t 0 n 1 + n 2 − 2 n_{1}+n_{2}-2 n 1 + n 2 − 2 t t t ∣ t 0 ∣ > t α / 2 , n 1 + n 2 − 2 |t_{0}|>t_{\alpha/2,n_{1}+n_{2}-2} ∣ t 0 ∣ > t α /2 , n 1 + n 2 − 2 t α / 2 , n 1 + n 2 − 2 t_{\alpha/2,n_{1}+n_{2}-2} t α /2 , n 1 + n 2 − 2 n 1 + n 2 − 2 n_{1}+n_{2}-2 n 1 + n 2 − 2 t t t α / 2 \alpha/2 α /2 H 0 H_{0} H 0 两样本 t t t 。
这一程序可以这样说明其合理性。如果样本来自独立正态分布,那么 y ‾ 1 − y ‾ 2 \overline{y}_{1}-\overline{y}_{2} y 1 − y 2 N [ μ 1 − μ 2 , σ 2 ( 1 / n 1 + 1 / n 2 ) ] N[\mu_{1}-\mu_{2},\sigma^{2}(1/n_{1}+1/n_{2})] N [ μ 1 − μ 2 , σ 2 ( 1/ n 1 + 1/ n 2 )] σ 2 \sigma^{2} σ 2 H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2
Z 0 = y ‾ 1 − y ‾ 2 σ 1 n 1 + 1 n 2 (2.26) Z_{0} = \frac{\overline{y}_{1}-\overline{y}_{2}}{\sigma\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}}} \tag{2.26} Z 0 = σ n 1 1 + n 2 1 y 1 − y 2 ( 2.26 ) 的分布为 N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) σ \sigma σ S p S_{p} S p Z 0 Z_{0} Z 0 n 1 + n 2 − 2 n_{1}+n_{2}-2 n 1 + n 2 − 2 t t t H 0 H_{0} H 0 t 0 t_{0} t 0 t n 1 + n 2 − 2 t_{n_{1}+n_{2}-2} t n 1 + n 2 − 2 t 0 t_{0} t 0 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) − t α / 2 , n 1 + n 2 − 2 -t_{\alpha/2,n_{1}+n_{2}-2} − t α /2 , n 1 + n 2 − 2 t α / 2 , n 1 + n 2 − 2 t_{\alpha/2,n_{1}+n_{2}-2} t α /2 , n 1 + n 2 − 2 t 0 t_{0} t 0 H 0 H_{0} H 0 n 1 + n 2 − 2 n_{1}+n_{2}-2 n 1 + n 2 − 2 t t t t 0 t_{0} t 0 参考分布 (reference distribution),也就是说,它描述了原假设为真时 t 0 t_{0} t 0 α \alpha α 显著性水平 。
在某些问题中,人们可能只想在某个均值大于另一个均值时才拒绝 H 0 H_{0} H 0 H 1 : μ 1 > μ 2 H_{1}: \mu_{1} > \mu_{2} H 1 : μ 1 > μ 2 t 0 > t α , n 1 + n 2 − 2 t_{0} > t_{\alpha,n_{1}+n_{2}-2} t 0 > t α , n 1 + n 2 − 2 H 0 H_{0} H 0 μ 1 \mu_{1} μ 1 μ 2 \mu_{2} μ 2 H 0 H_{0} H 0 H 1 : μ 1 < μ 2 H_{1}: \mu_{1} < \mu_{2} H 1 : μ 1 < μ 2 t 0 < − t α , n 1 + n 2 − 2 t_{0} < -t_{\alpha,n_{1}+n_{2}-2} t 0 < − t α , n 1 + n 2 − 2 H 0 H_{0} H 0
为说明这一程序,考虑表 2.1 中的波特兰水泥数据。对这些数据,我们得到
改进砂浆 未改进砂浆 y ‾ 1 = 16.76 kgf/cm 2 \overline{y}_{1} = 16.76\ \text{kgf/cm}^{2} y 1 = 16.76 kgf/cm 2 y ‾ 2 = 17.04 kgf/cm 2 \overline{y}_{2} = 17.04\ \text{kgf/cm}^{2} y 2 = 17.04 kgf/cm 2 S 1 2 = 0.100 S_{1}^{2} = 0.100 S 1 2 = 0.100 S 2 2 = 0.061 S_{2}^{2} = 0.061 S 2 2 = 0.061 S 1 = 0.316 S_{1} = 0.316 S 1 = 0.316 S 2 = 0.248 S_{2} = 0.248 S 2 = 0.248 n 1 = 10 n_{1} = 10 n 1 = 10 n 2 = 10 n_{2} = 10 n 2 = 10
由于两个样本标准差相当接近,认为总体标准差(或方差)相等的结论并不算勉强。因此我们可用式 2.24 检验假设
H 0 : μ 1 = μ 2 H 1 : μ 1 ≠ μ 2 \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} \\
H_{1}: \mu_{1} \neq \mu_{2}
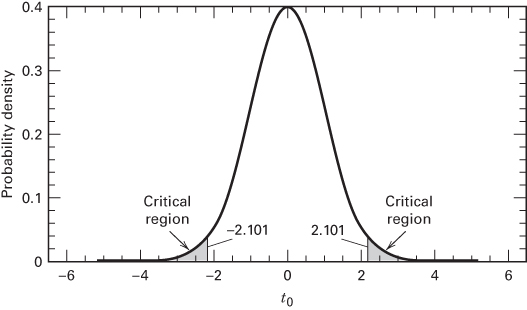
\end{array} H 0 : μ 1 = μ 2 H 1 : μ 1 = μ 2 此外,n 1 + n 2 − 2 = 10 + 10 − 2 = 18 n_{1}+n_{2}-2=10+10-2=18 n 1 + n 2 − 2 = 10 + 10 − 2 = 18 α = 0.05 \alpha=0.05 α = 0.05 t 0 > t 0.025 , 18 = 2.101 t_{0}>t_{0.025,18}=2.101 t 0 > t 0.025 , 18 = 2.101 t 0 < − t 0.025 , 18 = − 2.101 t_{0}<-t_{0.025,18}=-2.101 t 0 < − t 0.025 , 18 = − 2.101 H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 t t t
利用式 2.25,我们得到
S p 2 = ( n 1 − 1 ) S 1 2 + ( n 2 − 1 ) S 2 2 n 1 + n 2 − 2 = 9 ( 0.100 ) + 9 ( 0.061 ) 10 + 10 − 2 = 0.081 S p = 0.284 \begin{aligned}
S_{p}^{2} &= \frac{(n_{1}-1)S_{1}^{2}+(n_{2}-1)S_{2}^{2}}{n_{1}+n_{2}-2} \\
&= \frac{9(0.100)+9(0.061)}{10+10-2} = 0.081 \\
S_{p} &= 0.284
\end{aligned} S p 2 S p = n 1 + n 2 − 2 ( n 1 − 1 ) S 1 2 + ( n 2 − 1 ) S 2 2 = 10 + 10 − 2 9 ( 0.100 ) + 9 ( 0.061 ) = 0.081 = 0.284 图 2.10 自由度为 18 的 t t t ± t 0.025 , 18 = ± 2.101 \pm t_{0.025,18}=\pm 2.101 ± t 0.025 , 18 = ± 2.101
检验统计量为
t 0 = y ‾ 1 − y ‾ 2 S p 1 n 1 + 1 n 2 = 16.76 − 17.04 0.284 1 10 + 1 10 = − 0.28 0.127 = − 2.20 \begin{aligned}
t_{0} &= \frac{\overline{y}_{1}-\overline{y}_{2}}{S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}}} = \frac{16.76-17.04}{0.284\sqrt{\frac{1}{10}+\frac{1}{10}}} \\
&= \frac{-0.28}{0.127} = -2.20
\end{aligned} t 0 = S p n 1 1 + n 2 1 y 1 − y 2 = 0.284 10 1 + 10 1 16.76 − 17.04 = 0.127 − 0.28 = − 2.20 因为 t 0 = − 2.20 < − t 0.025 , 18 = − 2.101 t_{0}=-2.20 < -t_{0.025,18}=-2.101 t 0 = − 2.20 < − t 0.025 , 18 = − 2.101 H 0 H_{0} H 0
P P P α \alpha α 固定显著性水平检验 (fixed significance level testing)。例如,在上面的波特兰水泥砂浆配方中,我们可以说 H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 α = 0.05 \alpha=0.05 α = 0.05
为避免这些困难,P P P P P P H 0 H_{0} H 0 P P P H 0 H_{0} H 0 P P P H 0 H_{0} H 0
当原假设 H 0 H_{0} H 0 显著的 ;因此,我们可以把 P P P α \alpha α P P P
计算检验的精确 P P P P P P P P P P P P ∣ t 0 ∣ = 2.20 > t 0.025 , 18 = 2.101 |t_{0}|=2.20 > t_{0.025,18}=2.101 ∣ t 0 ∣ = 2.20 > t 0.025 , 18 = 2.101 P P P t t t t 0.01 , 18 = 2.552 t_{0.01,18}=2.552 t 0.01 , 18 = 2.552 ∣ t 0 ∣ = 2.20 < 2.552 |t_{0}|=2.20 < 2.552 ∣ t 0 ∣ = 2.20 < 2.552 P P P 2 ( 0.01 ) = 0.02 2(0.01)=0.02 2 ( 0.01 ) = 0.02 P P P t 0 = − 2.20 t_{0}=-2.20 t 0 = − 2.20 P P P P = 0.0411 P=0.0411 P = 0.0411 H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 α > 0.0411 \alpha>0.0411 α > 0.0411
计算机解答。 许多统计软件包都有进行统计假设检验的功能。表 2.2 给出了把 Minitab 和 JMP 的两样本 t t t s / n s/\sqrt{n} s / n H 1 : μ 1 ≠ μ 2 H_{1}:\mu_{1}\neq\mu_{2} H 1 : μ 1 = μ 2
输出中包括 t 0 t_{0} t 0 t 0 t_{0} t 0 t 0 t_{0} t 0 P P P t t t P P P P = 0.042 P=0.042 P = 0.042 P P P P P P
表 2.2 两样本 t t t
Minitab
Two-sample T for Modified vs Unmodified
N Mean Std. Dev. SE Mean
Modified 10 16.764 0.316 0.10
Unmodified 10 17.042 0.248 0.078
Difference = mu (Modified) - mu (Unmodified)
Estimate for difference: -0.278000
95% CI for difference: (-0.545073, -0.010927)
T-Test of difference = 0 (vs not =): T-Value = -2.19
P-Value = 0.042 DF = 18
Both use Pooled Std. Dev. = 0.2843
JMP t-test
Unmodified-Modified
Assuming equal variances
Difference 0.278000 t Ratio 2.186876
Std Err Dif 0.127122 DF 18
Upper CL Dif 0.545073 Prob>|t| 0.0422
Lower CL Dif 0.010927 Prob>t 0.0211
Confidence 0.95 Prob<t 0.9789
t t t t t t 独立性 假定是关键的;如果运行顺序是随机化的(并且在适当情况下其他试验单元和材料也是随机选取的),这一假定通常能够满足。等方差和正态性假定则很容易用正态概率图 (normal probability plot)来检验。
一般来说,概率图 是一种图形技术,它通过对数据的主观目视检查来判断样本数据是否与某个假设的分布相符。其一般程序非常简单,用大多数统计软件包都能迅速完成。补充材料讨论了正态概率图的手工构造方法。
要构造概率图,首先把样本中的观测值从小到大排序。也就是说,把样本 y 1 , y 2 , … , y n y_{1}, y_{2}, \ldots, y_{n} y 1 , y 2 , … , y n y ( 1 ) , y ( 2 ) , … , y ( n ) y_{(1)}, y_{(2)}, \ldots, y_{(n)} y ( 1 ) , y ( 2 ) , … , y ( n ) y ( 1 ) y_{(1)} y ( 1 ) y ( 2 ) y_{(2)} y ( 2 ) y ( n ) y_{(n)} y ( n ) y ( j ) y_{(j)} y ( j ) ( j − 0.5 ) / n (j-0.5)/n ( j − 0.5 ) / n
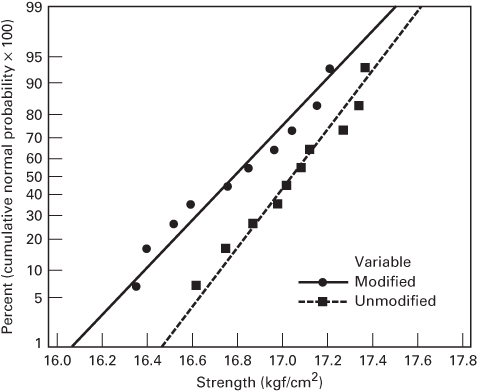
为说明这一程序,假设我们想检验波特兰水泥砂浆配方试验中拉伸粘结强度服从正态分布这一假定。我们首先只考虑未改进砂浆配方的观测值。图 2.11 给出了计算机生成的正态概率图。大多数正态概率图在左侧纵轴上标出 100 ( j − 0.5 ) / n 100(j-0.5)/n 100 ( j − 0.5 ) / n 100 [ 1 − ( j − 0.5 ) / n ] 100[1-(j-0.5)/n] 100 [ 1 − ( j − 0.5 ) / n ] z z z
我们可以直接从正态概率图得到均值和标准差的估计。均值估计为概率图上的第 50 百分位数,标准差估计为第 84 百分位数与第 50 百分位数之差。这意味着,只要比较图 2.11 中两条直线的斜率,就可以验证波特兰水泥试验中总体方差相等这一假定。两条直线的斜率非常接近,因此等方差假定是合理的。若这一假定不成立,就应当使用 2.4.4 节中所述的 t t t t t t
图 2.11 波特兰水泥试验中拉伸粘结强度的正态概率图
当假定被严重违背时,t t t 变换 (transformation)是处理这一问题的一种途径,我们将在第 3 章更详细地讨论。如果观测值来自非正态总体,也可以使用非参数 假设检验方法。更多细节参见 Montgomery 和 Runger(2018)。
t t t t t t [ 20 ! / ( 10 ! 10 ! ) ] = 184 , 756 [20!/(10!10!)]=184{,}756 [ 20 ! / ( 10 ! 10 !)] = 184 , 756 t 0 t_{0} t 0 t 0 t_{0} t 0 μ 1 ≠ μ 2 \mu_{1}\neq\mu_{2} μ 1 = μ 2
这类程序称为随机化检验 (randomization test)。可以证明,t t t t t t
2.4.2 置信区间 ¶ 尽管假设检验是一种有用的程序,但有时它并不能说明全部情况。通常更好的做法是给出一个区间,使人预期所关注的参数值落在其中。这类区间陈述称为置信区间 (confidence interval)。在许多工程和工业试验中,试验者已经知道均值 μ 1 \mu_{1} μ 1 μ 2 \mu_{2} μ 2 μ 1 = μ 2 \mu_{1}=\mu_{2} μ 1 = μ 2 μ 1 − μ 2 \mu_{1}-\mu_{2} μ 1 − μ 2
为定义置信区间,假设 θ \theta θ θ \theta θ L L L U U U
P ( L ⩽ θ ⩽ U ) = 1 − α (2.27) P(L \leqslant \theta \leqslant U) = 1-\alpha \tag{2.27} P ( L ⩽ θ ⩽ U ) = 1 − α ( 2.27 ) 成立。区间
L ⩽ θ ⩽ U (2.28) L \leqslant \theta \leqslant U \tag{2.28} L ⩽ θ ⩽ U ( 2.28 ) 称为参数 θ \theta θ 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) 置信区间 。该区间的解释是:若在重复随机抽样中构造大量这样的区间,其中 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α ) θ \theta θ L L L U U U 置信下限 和置信上限 ,1 − α 1-\alpha 1 − α 置信系数 。若 α = 0.05 \alpha=0.05 α = 0.05 θ \theta θ 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
假设我们希望求出波特兰水泥问题中均值真差 μ 1 − μ 2 \mu_{1}-\mu_{2} μ 1 − μ 2 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
y ‾ 1 − y ‾ 2 − ( μ 1 − μ 2 ) S p 1 n 1 + 1 n 2 \frac{\overline{y}_{1}-\overline{y}_{2}-(\mu_{1}-\mu_{2})}{S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}}} S p n 1 1 + n 2 1 y 1 − y 2 − ( μ 1 − μ 2 ) 服从 t n 1 + n 2 − 2 t_{n_{1}+n_{2}-2} t n 1 + n 2 − 2
P ( − t α / 2 , n 1 + n 2 − 2 ≤ y ‾ 1 − y ‾ 2 − ( μ 1 − μ 2 ) S p 1 n 1 + 1 n 2 ≤ t α / 2 , n 1 + n 2 − 2 ) = 1 − α P \left(- t_{\alpha/2,n_{1}+n_{2}-2} \leq \frac{\overline{y}_{1}-\overline{y}_{2}-(\mu_{1}-\mu_{2})}{S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}}} \leq t_{\alpha/2,n_{1}+n_{2}-2}\right) = 1-\alpha P ⎝ ⎛ − t α /2 , n 1 + n 2 − 2 ≤ S p n 1 1 + n 2 1 y 1 − y 2 − ( μ 1 − μ 2 ) ≤ t α /2 , n 1 + n 2 − 2 ⎠ ⎞ = 1 − α 或
P ( y ‾ 1 − y ‾ 2 − t α / 2 , n 1 + n 2 − 2 S p 1 n 1 + 1 n 2 ≤ μ 1 − μ 2 ≤ y ‾ 1 − y ‾ 2 + t α / 2 , n 1 + n 2 − 2 S p 1 n 1 + 1 n 2 ) = 1 − α (2.29) \begin{aligned}
P \Bigg(\overline{y}_{1}-\overline{y}_{2} &- t_{\alpha/2,n_{1}+n_{2}-2} S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}} \leq \mu_{1}-\mu_{2} \\
&\leq \overline{y}_{1}-\overline{y}_{2}+t_{\alpha/2,n_{1}+n_{2}-2} S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}}\Bigg) = 1-\alpha
\end{aligned} \tag{2.29} P ( y 1 − y 2 − t α /2 , n 1 + n 2 − 2 S p n 1 1 + n 2 1 ≤ μ 1 − μ 2 ≤ y 1 − y 2 + t α /2 , n 1 + n 2 − 2 S p n 1 1 + n 2 1 ) = 1 − α ( 2.29 ) 比较式 2.29 与式 2.27,我们看到
y ‾ 1 − y ‾ 2 − t α / 2 , n 1 + n 2 − 2 S p 1 n 1 + 1 n 2 ≤ μ 1 − μ 2 ≤ y ‾ 1 − y ‾ 2 + t α / 2 , n 1 + n 2 − 2 S p 1 n 1 + 1 n 2 (2.30) \overline{y}_{1}-\overline{y}_{2}-t_{\alpha/2,n_{1}+n_{2}-2} S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}} \leq \mu_{1}-\mu_{2} \leq \overline{y}_{1}-\overline{y}_{2}+t_{\alpha/2,n_{1}+n_{2}-2} S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}} \tag{2.30} y 1 − y 2 − t α /2 , n 1 + n 2 − 2 S p n 1 1 + n 2 1 ≤ μ 1 − μ 2 ≤ y 1 − y 2 + t α /2 , n 1 + n 2 − 2 S p n 1 1 + n 2 1 ( 2.30 ) 是 μ 1 − μ 2 \mu_{1}-\mu_{2} μ 1 − μ 2 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
把数值代入式 2.30,即得波特兰水泥砂浆两种配方平均拉伸粘结强度之差的实际 95% 置信区间估计:
16.76 − 17.04 − ( 2.101 ) ( 0.284 ) 1 10 + 1 10 ≤ μ 1 − μ 2 ≤ 16.76 − 17.04 + ( 2.101 ) ( 0.284 ) 1 10 + 1 10 − 0.28 − 0.27 ≤ μ 1 − μ 2 ≤ − 0.28 + 0.27 − 0.55 ≤ μ 1 − μ 2 ≤ − 0.01 \begin{aligned}
16.76 - 17.04 &- (2.101)(0.284)\sqrt{\frac{1}{10}+\frac{1}{10}} \leq \mu_{1}-\mu_{2} \\
&\leq 16.76 - 17.04 + (2.101)(0.284)\sqrt{\frac{1}{10}+\frac{1}{10}} \\
-0.28 &- 0.27 \leq \mu_{1}-\mu_{2} \leq -0.28 + 0.27 \\
-0.55 &\leq \mu_{1}-\mu_{2} \leq -0.01
\end{aligned} 16.76 − 17.04 − 0.28 − 0.55 − ( 2.101 ) ( 0.284 ) 10 1 + 10 1 ≤ μ 1 − μ 2 ≤ 16.76 − 17.04 + ( 2.101 ) ( 0.284 ) 10 1 + 10 1 − 0.27 ≤ μ 1 − μ 2 ≤ − 0.28 + 0.27 ≤ μ 1 − μ 2 ≤ − 0.01 因此,均值之差的 95% 置信区间估计从 -0.55 延伸到 -0.01 kgf/cm2 ^{2} 2 μ 1 − μ 2 = − 0.28 ± 0.27 \mu_{1}-\mu_{2}=-0.28 \pm 0.27 μ 1 − μ 2 = − 0.28 ± 0.27 2 ^{2} 2 2 ^{2} 2 ± 0.27 \pm 0.27 ± 0.27 2 ^{2} 2 μ 1 − μ 2 = 0 \mu_{1}-\mu_{2}=0 μ 1 − μ 2 = 0 μ 1 = μ 2 \mu_{1}=\mu_{2} μ 1 = μ 2 t t t P P P
2.4.3 样本量的选择 ¶ 选择合适的样本量是任何试验设计问题中最重要的部分之一。做到这一点的一种方式是考虑样本量对两个均值之差估计的影响。由式 2.30 我们知道,两个均值之差的 100 ( 1 − α ) % 100(1-\alpha)\% 100 ( 1 − α ) %
t α / 2 , n 1 + n 2 − 2 S p 1 n 1 + 1 n 2 t_{\alpha/2,n_{1}+n_{2}-2} S_{p}\sqrt{\frac{1}{n_{1}}+\frac{1}{n_{2}}} t α /2 , n 1 + n 2 − 2 S p n 1 1 + n 2 1 我们考虑两个总体的样本量相等的情形,即 n 1 = n 2 = n n_{1}=n_{2}=n n 1 = n 2 = n
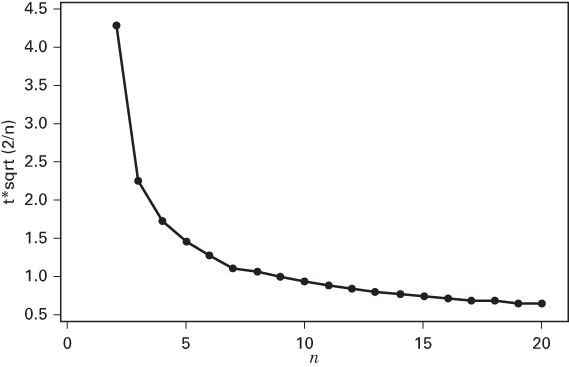
t α / 2 , 2 n − 2 S p 2 n t_{\alpha/2,2n-2} S_{p}\sqrt{\frac{2}{n}} t α /2 , 2 n − 2 S p n 2 决定。因此,两个均值之差的估计精度取决于两个量:S p S_{p} S p t α / 2 , 2 n − 2 2 / n t_{\alpha/2,2n-2}\sqrt{2/n} t α /2 , 2 n − 2 2/ n n n n α = 0.05 \alpha=0.05 α = 0.05 t α / 2 , 2 n − 2 2 / n t_{\alpha/2,2n-2}\sqrt{2/n} t α /2 , 2 n − 2 2/ n n n n n n n n = 10 n=10 n = 10 S p S_{p} S p t α / 2 , 2 n − 2 2 / n t_{\alpha/2,2n-2}\sqrt{2/n} t α /2 , 2 n − 2 2/ n n = 10 n=10 n = 10 n = 10 n=10 n = 10
我们也可以用假设检验框架来确定样本量。样本量的选择与第 II 类错误概率 β \beta β
H 0 : μ 1 = μ 2 H 1 : μ 1 ≠ μ 2 \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} \\
H_{1}: \mu_{1} \neq \mu_{2}
\end{array} H 0 : μ 1 = μ 2 H 1 : μ 1 = μ 2 并且均值不相等,即 δ = μ 1 − μ 2 \delta=\mu_{1}-\mu_{2} δ = μ 1 − μ 2 H 0 : μ 1 = μ 2 H_{0}:\mu_{1}=\mu_{2} H 0 : μ 1 = μ 2 H 0 H_{0} H 0 δ \delta δ β \beta β δ \delta δ 操作特性曲线 或 OC 曲线 (operating characteristic curve)。β \beta β δ \delta δ β \beta β
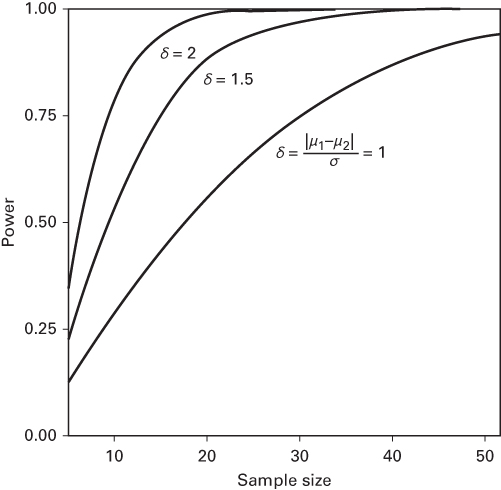
OC 曲线的一种替代是功效曲线 (power curve),它通常对指定的均值差画出功效或 1 − β 1-\beta 1 − β
H 0 : μ 1 = μ 2 H 1 : μ 1 ≠ μ 2 \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} \\
H_{1}: \mu_{1} \neq \mu_{2}
\end{array} H 0 : μ 1 = μ 2 H 1 : μ 1 = μ 2 构造的功效曲线,情形是两个总体方差 σ 1 2 \sigma_{1}^{2} σ 1 2 σ 2 2 \sigma_{2}^{2} σ 2 2 σ 1 2 = σ 2 2 = σ 2 \sigma_{1}^{2}=\sigma_{2}^{2}=\sigma^{2} σ 1 2 = σ 2 2 = σ 2 α = 0.05 \alpha=0.05 α = 0.05 n n n n / 2 n/2 n /2
δ = ∣ μ 1 − μ 2 ∣ σ \delta = \frac{|\mu_{1}-\mu_{2}|}{\sigma} δ = σ ∣ μ 1 − μ 2 ∣ 考察这些曲线,我们可以观察到以下几点:
均值差 μ 1 − μ 2 \mu_{1}-\mu_{2} μ 1 − μ 2 α \alpha α
对给定的均值差和显著性水平 α \alpha α
操作特性曲线和功效曲线在试验中选择样本量时常常很有帮助。例如,考虑前面讨论过的波特兰水泥砂浆问题。假设平均强度相差 0.5 k g f / c m 2 0.5\ kgf/cm^{2} 0.5 k g f / c m 2 μ 1 − μ 2 = 0.5 k g f / c m 2 \mu_{1}-\mu_{2}=0.5\ kgf/cm^{2} μ 1 − μ 2 = 0.5 k g f / c m 2 δ = 0.5 / σ \delta=0.5/\sigma δ = 0.5/ σ δ \delta δ σ \sigma σ 0.25 k g f / c m 2 0.25\ kgf/cm^{2} 0.25 k g f / c m 2 σ = 0.25 k g f / c m 2 \sigma=0.25\ kgf/cm^{2} σ = 0.25 k g f / c m 2 δ \delta δ δ = 2 \delta=2 δ = 2 α = 0.05 \alpha=0.05 α = 0.05 μ 1 − μ 2 = 0.5 \mu_{1}-\mu_{2}=0.5 μ 1 − μ 2 = 0.5
n = 16 / 2 = 8. n = 16/2 = 8. n = 16/2 = 8. 在我们的例子中,试验者实际使用了 10 的样本量。试验者本可以选择略微增大样本量,以防对公共标准差 σ \sigma σ
图 2.12 对 α = 0.05 \alpha=0.05 α = 0.05 t α / 2 , 2 n − 2 2 / n t_{\alpha/2,2n-2}\sqrt{2/n} t α /2 , 2 n − 2 2/ n n n n
图 2.13 假定方差相等且 α = 0.05 \alpha=0.05 α = 0.05 t t t n = n= n = / 2 /2 /2
在试验设计问题中,操作特性曲线常常在样本量选择上扮演重要角色,其在这方面的用途将在后续章节讨论。关于操作特性曲线在类似两样本 t t t
许多统计软件包也能帮助试验者进行功效和样本量计算。下面的方框显示了用 Minitab 中两样本 t t t 0.25 k g f / c m 2 0.25\ kgf/cm^{2} 0.25 k g f / c m 2 0.5 k g f / c m 2 0.5\ kgf/cm^{2} 0.5 k g f / c m 2 n 1 = n 2 = 8 n_{1}=n_{2}=8 n 1 = n 2 = 8 0.25 k g f / c m 2 0.25\ kgf/cm^{2} 0.25 k g f / c m 2 0.25 k g f / c m 2 0.25\ kgf/cm^{2} 0.25 k g f / c m 2 n 1 = n 2 = 23 n_{1}=n_{2}=23 n 1 = n 2 = 23
Power and Sample Size
2-Sample t-Test
Testing mean 1 = mean 2 (versus not =)
Calculating power for mean 1 = mean 2 + difference
Alpha = 0.05 Sigma = 0.25
Sample Target Actual
Difference Size Power Power
0.5 8 0.9500 0.9602
Power and Sample Size
2-Sample t-Test
Testing mean 1 = mean 2 (versus not =)
Calculating power for mean 1 = mean 2 + difference
Alpha = 0.05 Sigma = 0.25
Sample
Difference Size Power
0.25 10 0.5620
Power and Sample Size
2-Sample t-Test
Testing mean 1 = mean 2 (versus not =)
Calculating power for mean 1 = mean 2 + difference
Alpha = 0.05 Sigma = 0.25
Sample Target Actual
Difference Size Power Power
0.25 23 0.9000 0.9125
2.4.4 σ 1 2 ≠ σ 2 2 \sigma_1^2\neq \sigma_2^2 σ 1 2 = σ 2 2 ¶ 如果我们检验
H 0 : μ 1 = μ 2 H 1 : μ 1 ≠ μ 2 \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} \\
H_{1}: \mu_{1} \neq \mu_{2}
\end{array} H 0 : μ 1 = μ 2 H 1 : μ 1 = μ 2 而不能合理地假定方差 σ 1 2 \sigma_{1}^{2} σ 1 2 σ 2 2 \sigma_{2}^{2} σ 2 2 t t t
t 0 = y ‾ 1 − y ‾ 2 S 1 2 n 1 + S 2 2 n 2 (2.31) t_{0} = \frac{\overline{y}_{1}-\overline{y}_{2}}{\sqrt{\frac{S_{1}^{2}}{n_{1}}+\frac{S_{2}^{2}}{n_{2}}}} \tag{2.31} t 0 = n 1 S 1 2 + n 2 S 2 2 y 1 − y 2 ( 2.31 ) 这一统计量并不严格服从 t t t
v = ( S 1 2 n 1 + S 2 2 n 2 ) 2 ( S 1 2 / n 1 ) 2 n 1 − 1 + ( S 2 2 / n 2 ) 2 n 2 − 1 (2.32) v = \frac{\left(\frac{S_{1}^{2}}{n_{1}}+\frac{S_{2}^{2}}{n_{2}}\right)^{2}}{\frac{(S_{1}^{2}/n_{1})^{2}}{n_{1}-1}+\frac{(S_{2}^{2}/n_{2})^{2}}{n_{2}-1}} \tag{2.32} v = n 1 − 1 ( S 1 2 / n 1 ) 2 + n 2 − 1 ( S 2 2 / n 2 ) 2 ( n 1 S 1 2 + n 2 S 2 2 ) 2 ( 2.32 ) 作为自由度个数,则 t 0 t_{0} t 0 t t t t t t
例 2.1 ¶ 保留神经在外科手术中很重要,因为意外损伤神经会导致术后问题,例如麻木、疼痛或瘫痪。神经通常通过其外观以及与周围结构的关系来识别,或者通过局部电刺激(肌电图)来检测,但它相对容易被忽略。《Nature Biotechnology》上的一篇文章(“Fluorescent Peptides Highlight Peripheral Nerves During Surgery in Mice”,第 29 卷,2011 年)描述了使用一种与神经结合的荧光标记肽来辅助识别神经。表 2.3 给出了 12 只小鼠在两个小时后的神经组织和肌肉组织的归一化荧光值(数据是从论文中的一幅图上读取的)。
我们想检验的假设是:两小时后神经组织的平均归一化荧光值大于肌肉组织。也就是说,若 μ 1 \mu_{1} μ 1 μ 2 \mu_{2} μ 2
H 0 : μ 1 = μ 2 H 1 : μ 1 > μ 2 \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} \\
H_{1}: \mu_{1} > \mu_{2}
\end{array} H 0 : μ 1 = μ 2 H 1 : μ 1 > μ 2 Minitab 输出的描述性统计量如下:
Variable N Mean StDev Minimum Median Maximum Nerve 12 4228 1918 450 4825 6625 Non-nerve 12 2534 961 1130 2650 3900
表 2.3 两小时后的归一化荧光值
观测 神经 肌肉 1 6625 3900 2 6000 3500 3 5450 3450 4 5200 3200 5 5175 2980 6 4900 2800 7 4750 2500 8 4500 2400 9 3985 2200 10 900 1200 11 450 1150 12 2800 1130
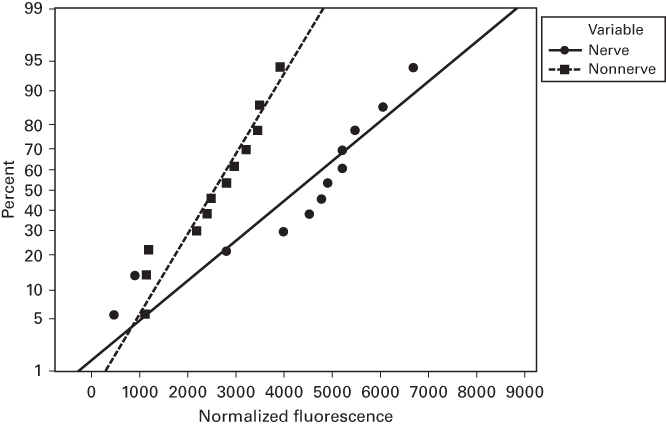
图 2.14 表 2.3 的归一化荧光数据
注意两个样本标准差相差很大,因此合并 t t t
由于等方差假定在这里不合适,我们将使用本节所述的两样本 t t t
t 0 = y ‾ 1 − y ‾ 2 S 1 2 n 1 + S 2 2 n 2 = 4228 − 2534 ( 1918 ) 2 12 + ( 961 ) 2 12 = 2.7354 t_{0} = \frac{\overline{y}_{1}-\overline{y}_{2}}{\sqrt{\frac{S_{1}^{2}}{n_{1}}+\frac{S_{2}^{2}}{n_{2}}}} = \frac{4228-2534}{\sqrt{\frac{(1918)^{2}}{12}+\frac{(961)^{2}}{12}}} = 2.7354 t 0 = n 1 S 1 2 + n 2 S 2 2 y 1 − y 2 = 12 ( 1918 ) 2 + 12 ( 961 ) 2 4228 − 2534 = 2.7354 自由度个数由式 2.32 计算:
v = ( S 1 2 n 1 + S 2 2 n 2 ) 2 ( S 1 2 / n 1 ) 2 n 1 − 1 + ( S 2 2 / n 2 ) 2 n 2 − 1 = ( ( 1918 ) 2 12 + ( 961 ) 2 12 ) 2 [ ( 1918 ) 2 / 12 ] 2 11 + [ ( 961 ) 2 / 12 ] 2 11 = 16.1955 v = \frac{\left(\frac{S_{1}^{2}}{n_{1}}+\frac{S_{2}^{2}}{n_{2}}\right)^{2}}{\frac{(S_{1}^{2}/n_{1})^{2}}{n_{1}-1}+\frac{(S_{2}^{2}/n_{2})^{2}}{n_{2}-1}} = \frac{\left(\frac{(1918)^{2}}{12}+\frac{(961)^{2}}{12}\right)^{2}}{\frac{[(1918)^{2}/12]^{2}}{11}+\frac{[(961)^{2}/12]^{2}}{11}} = 16.1955 v = n 1 − 1 ( S 1 2 / n 1 ) 2 + n 2 − 1 ( S 2 2 / n 2 ) 2 ( n 1 S 1 2 + n 2 S 2 2 ) 2 = 11 [( 1918 ) 2 /12 ] 2 + 11 [( 961 ) 2 /12 ] 2 ( 12 ( 1918 ) 2 + 12 ( 961 ) 2 ) 2 = 16.1955 如果我们要从 t t t P P P P P P t t t P P P
Difference = mu (Nerve) - mu (Non-nerve)
Estimate for difference: 1694
95% lower bound for difference: 613
T-Test of difference = 0 (vs >): T-Value = 2.74 P-Value = 0.007 DF = 16
2.4.5 σ 1 2 \sigma_1^2 σ 1 2 σ 2 2 \sigma_2^2 σ 2 2 ¶ 如果两个总体的方差都已知,那么假设
H 0 : μ 1 = μ 2 H 1 : μ 1 ≠ μ 2 \begin{array}{l}
H_{0}: \mu_{1} = \mu_{2} \\
H_{1}: \mu_{1} \neq \mu_{2}
\end{array} H 0 : μ 1 = μ 2 H 1 : μ 1 = μ 2 可以用统计量
Z 0 = y ‾ 1 − y ‾ 2 σ 1 2 n 1 + σ 2 2 n 2 (2.33) Z_{0} = \frac{\overline{y}_{1}-\overline{y}_{2}}{\sqrt{\frac{\sigma_{1}^{2}}{n_{1}}+\frac{\sigma_{2}^{2}}{n_{2}}}} \tag{2.33} Z 0 = n 1 σ 1 2 + n 2 σ 2 2 y 1 − y 2 ( 2.33 ) 来检验。如果两个总体都服从正态分布,或者样本量足够大以致中心极限定理适用,那么当原假设为真时 Z 0 Z_{0} Z 0 N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) t t t ∣ Z 0 ∣ > Z α / 2 |Z_{0}|>Z_{\alpha/2} ∣ Z 0 ∣ > Z α /2 H 0 H_{0} H 0 Z α / 2 Z_{\alpha/2} Z α /2 α / 2 \alpha/2 α /2 两样本 Z Z Z 。该检验也可以使用 P P P P P P P = 2 [ 1 − Φ ( ∣ Z 0 ∣ ) ] P=2[1-\Phi(|Z_{0}|)] P = 2 [ 1 − Φ ( ∣ Z 0 ∣ )] Φ ( x ) \Phi(x) Φ ( x ) x x x
与前几节的 t t t y ‾ 1 − y ‾ 2 \overline{y}_{1}-\overline{y}_{2} y 1 − y 2
方差已知时 μ 1 − μ 2 \mu_{1}-\mu_{2} μ 1 − μ 2 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
y ‾ 1 − y ‾ 2 − Z α / 2 σ 1 2 n 1 + σ 2 2 n 2 ≤ μ 1 − μ 2 ≤ y ‾ 1 − y ‾ 2 + Z α / 2 σ 1 2 n 1 + σ 2 2 n 2 (2.34) \overline{y}_{1}-\overline{y}_{2}-Z_{\alpha/2}\sqrt{\frac{\sigma_{1}^{2}}{n_{1}}+\frac{\sigma_{2}^{2}}{n_{2}}} \leq \mu_{1}-\mu_{2} \leq \overline{y}_{1}-\overline{y}_{2}+Z_{\alpha/2}\sqrt{\frac{\sigma_{1}^{2}}{n_{1}}+\frac{\sigma_{2}^{2}}{n_{2}}} \tag{2.34} y 1 − y 2 − Z α /2 n 1 σ 1 2 + n 2 σ 2 2 ≤ μ 1 − μ 2 ≤ y 1 − y 2 + Z α /2 n 1 σ 1 2 + n 2 σ 2 2 ( 2.34 ) 如前所述,置信区间常常是假设检验程序的有用补充。
2.4.6 单个均值与指定值的比较 ¶ 有些试验只涉及把单个总体均值 μ \mu μ μ 0 \mu_{0} μ 0
H 0 : μ = μ 0 H 1 : μ ≠ μ 0 \begin{array}{l}
H_{0}: \mu = \mu_{0} \\
H_{1}: \mu \neq \mu_{0}
\end{array} H 0 : μ = μ 0 H 1 : μ = μ 0 如果总体服从方差已知的正态分布,或者总体非正态但样本量足够大以致中心极限定理适用,那么可以直接应用正态分布来检验该假设。单样本 Z Z Z
Z 0 = y ‾ − μ 0 σ / n (2.35) Z_{0} = \frac{\overline{y}-\mu_{0}}{\sigma/\sqrt{n}} \tag{2.35} Z 0 = σ / n y − μ 0 ( 2.35 ) 若 H 0 : μ = μ 0 H_{0}: \mu=\mu_{0} H 0 : μ = μ 0 Z 0 Z_{0} Z 0 N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) H 0 : μ = μ 0 H_{0}: \mu=\mu_{0} H 0 : μ = μ 0 ∣ Z 0 ∣ > Z α / 2 |Z_{0}|>Z_{\alpha/2} ∣ Z 0 ∣ > Z α /2 P P P
原假设中指定的均值 μ 0 \mu_{0} μ 0
总体真实均值的 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
y ‾ − Z α / 2 σ / n ≤ μ ≤ y ‾ + Z α / 2 σ / n (2.36) \overline{y}-Z_{\alpha/2}\sigma/\sqrt{n} \leq \mu \leq \overline{y}+Z_{\alpha/2}\sigma/\sqrt{n} \tag{2.36} y − Z α /2 σ / n ≤ μ ≤ y + Z α /2 σ / n ( 2.36 ) 例 2.2 ¶ 一位供应商向纺织厂提交若干批织物。客户想知道这批织物的平均断裂强度是否超过 200 psi;若是,她就愿意接受这批货。以往经验表明,断裂强度方差的一个合理取值为 100 ( psi ) 2 100(\text{psi})^{2} 100 ( psi ) 2
H 0 : μ = 200 H 1 : μ > 200 \begin{array}{l}
H_{0}: \mu = 200 \\
H_{1}: \mu > 200
\end{array} H 0 : μ = 200 H 1 : μ > 200 注意这是单侧备择假设。因此,只有在原假设 H 0 : μ = 200 H_{0}:\mu=200 H 0 : μ = 200 Z 0 > Z α Z_{0}>Z_{\alpha} Z 0 > Z α
随机选取 4 个试样,观测到的平均断裂强度为 y ˉ = 214 \bar{y}=214 y ˉ = 214
Z 0 = y ‾ − μ 0 σ / n = 214 − 200 10 / 4 = 2.80 Z_{0} = \frac{\overline{y}-\mu_{0}}{\sigma/\sqrt{n}} = \frac{214-200}{10/\sqrt{4}} = 2.80 Z 0 = σ / n y − μ 0 = 10/ 4 214 − 200 = 2.80 若指定第 I 类错误 α = 0.05 \alpha=0.05 α = 0.05 Z α = Z 0.05 = 1.645 Z_{\alpha}=Z_{0.05}=1.645 Z α = Z 0.05 = 1.645 P P P P = 1 − Φ ( 2.80 ) = 1 − 0.99744 = 0.00256 P=1-\Phi(2.80)=1-0.99744=0.00256 P = 1 − Φ ( 2.80 ) = 1 − 0.99744 = 0.00256 H 0 H_{0} H 0
如果总体的方差未知,我们必须补充假定总体服从正态分布,尽管中度偏离正态性不会严重影响结果。在方差未知的情形下检验 H 0 : μ = μ 0 H_{0}:\mu=\mu_{0} H 0 : μ = μ 0 S 2 S^{2} S 2 σ 2 \sigma^{2} σ 2 σ \sigma σ S S S t t t
t 0 = y ‾ − μ 0 S / n (2.37) t_{0} = \frac{\overline{y}-\mu_{0}}{S/\sqrt{n}} \tag{2.37} t 0 = S / n y − μ 0 ( 2.37 ) 表 2.4 方差已知时对均值的检验
假设 检验统计量 固定显著性水平的拒绝准则 P P P H 0 : μ = μ 0 H_{0}: \mu = \mu_{0} H 0 : μ = μ 0 H 1 : μ ≠ μ 0 H_{1}: \mu \neq \mu_{0} H 1 : μ = μ 0 ∣ Z 0 ∣ > Z α / 2 \vert Z_{0}\vert > Z_{\alpha/2} ∣ Z 0 ∣ > Z α /2 P = 2 [ 1 − Φ ( ∣ Z 0 ∣ ) ] P = 2[1-\Phi(\vert Z_{0}\vert)] P = 2 [ 1 − Φ ( ∣ Z 0 ∣ )] H 0 : μ = μ 0 H_{0}: \mu = \mu_{0} H 0 : μ = μ 0 H 1 : μ < μ 0 H_{1}: \mu < \mu_{0} H 1 : μ < μ 0 Z 0 = y ‾ − μ 0 σ / n Z_{0} = \dfrac{\overline{y}-\mu_{0}}{\sigma/\sqrt{n}} Z 0 = σ / n y − μ 0 Z 0 < − Z α Z_{0} < -Z_{\alpha} Z 0 < − Z α P = Φ ( Z 0 ) P = \Phi(Z_{0}) P = Φ ( Z 0 ) H 0 : μ = μ 0 H_{0}: \mu = \mu_{0} H 0 : μ = μ 0 H 1 : μ > μ 0 H_{1}: \mu > \mu_{0} H 1 : μ > μ 0 Z 0 > Z α Z_{0} > Z_{\alpha} Z 0 > Z α P = 1 − Φ ( Z 0 ) P = 1-\Phi(Z_{0}) P = 1 − Φ ( Z 0 ) H 0 : μ 1 = μ 2 H_{0}: \mu_{1} = \mu_{2} H 0 : μ 1 = μ 2 H 1 : μ 1 ≠ μ 2 H_{1}: \mu_{1} \neq \mu_{2} H 1 : μ 1 = μ 2 ∣ Z 0 ∣ > Z α / 2 \vert Z_{0}\vert > Z_{\alpha/2} ∣ Z 0 ∣ > Z α /2 P = 2 [ 1 − Φ ( ∣ Z 0 ∣ ) ] P = 2[1-\Phi(\vert Z_{0}\vert)] P = 2 [ 1 − Φ ( ∣ Z 0 ∣ )] H 0 : μ 1 = μ 2 H_{0}: \mu_{1} = \mu_{2} H 0 : μ 1 = μ 2 H 1 : μ 1 < μ 2 H_{1}: \mu_{1} < \mu_{2} H 1 : μ 1 < μ 2 Z 0 = y ‾ 1 − y ‾ 2 σ 1 2 n 1 + σ 2 2 n 2 Z_{0} = \dfrac{\overline{y}_{1}-\overline{y}_{2}}{\sqrt{\frac{\sigma_{1}^{2}}{n_{1}}+\frac{\sigma_{2}^{2}}{n_{2}}}} Z 0 = n 1 σ 1 2 + n 2 σ 2 2 y 1 − y 2 Z 0 < − Z α Z_{0} < -Z_{\alpha} Z 0 < − Z α P = Φ ( Z 0 ) P = \Phi(Z_{0}) P = Φ ( Z 0 ) H 0 : μ 1 = μ 2 H_{0}: \mu_{1} = \mu_{2} H 0 : μ 1 = μ 2 H 1 : μ 1 > μ 2 H_{1}: \mu_{1} > \mu_{2} H 1 : μ 1 > μ 2 Z 0 > Z α Z_{0} > Z_{\alpha} Z 0 > Z α P = 1 − Φ ( Z 0 ) P = 1-\Phi(Z_{0}) P = 1 − Φ ( Z 0 )
若 ∣ t 0 ∣ > t α / 2 , n − 1 |t_{0}|>t_{\alpha/2,n-1} ∣ t 0 ∣ > t α /2 , n − 1 H 0 : μ = μ 0 H_{0}: \mu=\mu_{0} H 0 : μ = μ 0 t α / 2 , n − 1 t_{\alpha/2,n-1} t α /2 , n − 1 n − 1 n-1 n − 1 t t t α / 2 \alpha/2 α /2 P P P 100 ( 1 − α ) 100(1-\alpha) 100 ( 1 − α )
y ‾ − t α / 2 , n − 1 S / n ≤ μ ≤ y ‾ + t α / 2 , n − 1 S / n (2.38) \overline{y}-t_{\alpha/2,n-1} S/\sqrt{n} \leq \mu \leq \overline{y}+t_{\alpha/2,n-1} S/\sqrt{n} \tag{2.38} y − t α /2 , n − 1 S / n ≤ μ ≤ y + t α /2 , n − 1 S / n ( 2.38 ) 2.4.7 小结 ¶ 表 2.4 和表 2.5 总结了上面讨论的关于样本均值的 t t t z z z