2.5 关于均值差的推断:配对比较设计
2.5.1 配对比较问题
在一些简单比较试验中,通过在被配成对的试验材料内部进行比较,可以极大地提高精度。例如,考虑一台硬度试验机:它用一个尖头以已知的力压入金属试样,通过测量尖头造成的压痕深度来确定试样的硬度。这台机器有两种可用的尖头,虽然两种尖头所做测量的精度(变异)似乎相同,但有人怀疑其中一种尖头给出的平均硬度读数与另一种不同。
试验可以这样进行:随机选取若干金属试样(例如 20 个),其中一半用尖头 1 测试,另一半用尖头 2 测试,试样分配给尖头的具体方案随机确定。由于这是一个完全随机化设计,可以用 2.4 节所述的 t 检验来比较两个样本的平均硬度。
表 2.5 正态分布均值的检验,方差未知
| 假设 | 检验统计量 | 固定显著性水平的拒绝准则 | P 值 |
|---|
| H0:μ=μ0 | | | |
| H1:μ=μ0 | | ∣t0∣>tα/2,n−1 | t0 以上与 −t0 以下的概率之和 |
| H0:μ=μ0 | | | |
| H1:μ<μ0 | t0=S/nyˉ−μ0 | t0<−tα,n−1 | t0 以下的概率 |
| H0:μ=μ0 | | | |
| H1:μ>μ0 | | t0>tα,n−1 | t0 以上的概率 |
| 若 σ12=σ22 | | |
| H0:μ1=μ2 | | | |
| H1:μ1=μ2 | t0=Spn11+n21yˉ1−yˉ2 | ∣t0∣>tα/2,v | t0 以上与 −t0 以下的概率之和 |
| v=n1+n2−2 | | |
| 若 σ12=σ22 | | |
| H0:μ1=μ2 | | | |
| H1:μ1<μ2 | t0=n1S12+n2S22yˉ1−yˉ2 | t0<−tα,v | t0 以下的概率 |
| H0:μ1=μ2 | | | |
| H1:μ1>μ2 | v=n1−1(S12/n1)2+n2−1(S22/n2)2(n1S12+n2S22)2 | t0>tα,v | t0 以上的概率 |
稍加思考就会发现,对于这个问题,完全随机化设计有一个严重的缺点。假设这些金属试样是从不同炉次生产的、或者在其他方面并不完全均匀(而这一点可能影响硬度)的不同棒材上切下来的。试样之间的这种非齐同性会增加硬度测量的变异,并倾向于抬高试验误差,从而使两种尖头之间的真实差异更难检出。
为了防止这种可能,考虑另一种试验设计。假设每个试样都足够大,可以在其上做两次硬度测定。这一替代设计就是把每个试样分成两部分,然后随机地把一种尖头分配给每个试样的一半,把另一种尖头分配给剩下的一半;对某个特定试样,两种尖头测试的先后顺序也随机确定。按这一设计用 10 个试样做试验,得到的数据(已编码)见表 2.6。
表 2.6 硬度试验的数据
| 试样 | 尖头 1 | 尖头 2 |
|---|
| 1 | 7 | 6 |
| 2 | 3 | 3 |
| 3 | 3 | 5 |
| 4 | 4 | 3 |
| 5 | 8 | 8 |
| 6 | 3 | 2 |
| 7 | 2 | 4 |
| 8 | 9 | 9 |
| 9 | 5 | 4 |
| 10 | 4 | 5 |
我们可以写出描述这一试验数据的统计模型:
yij=μi+βj+εij{i=1,2j=1,2,…,10(2.39) 其中 yij 是尖头 i 在第 j 个试样上的硬度观测值,μi 是第 i 种尖头的真实平均硬度,βj 是第 j 个试样对硬度的影响,εij 是均值为零、方差为 σi2 的随机试验误差。也就是说,σ12 是尖头 1 硬度测量的方差,σ22 是尖头 2 硬度测量的方差。
注意,如果我们计算第 j 个配对差(paired difference)
dj=y1j−y2jj=1,2,…,10(2.40) 则该差的期望值为
μd=E(dj)=E(y1j−y2j)=E(y1j)−E(y2j)=μ1+βj−(μ2+βj)=μ1−μ2 也就是说,我们可以通过对差值均值 μd 作推断,来对两种尖头的平均硬度读数之差 μ1−μ2 作推断。注意当观测值以这种方式配对后,试样的可加效应 βj 就消掉了。
检验 H0:μ1=μ2 等价于检验
H0:μd=0H1:μd=0 这是一个单样本 t 检验。该假设的检验统计量为
t0=Sd/nd(2.41) 其中
d=n1j=1∑ndj(2.42) 是差值的样本均值,而
Sd=[n−1∑j=1n(dj−d)2]1/2=⎣⎡n−1∑j=1ndj2−n1(∑j=1ndj)2⎦⎤1/2(2.43) 是差值的样本标准差。若 ∣t0∣>tα/2,n−1 则拒绝 H0:μd=0。也可以使用 P 值方法。由于来自两个因子水平的观测值是在每个试验单元上“配对”的,这一程序通常称为配对 t 检验(paired t-test)。
对表 2.6 中的数据,我们得到
d1=7−6=1d2=3−3=0d3=3−5=−2d4=4−3=1d5=8−8=0d6=3−2=1d7=2−4=−2d8=9−9=0d9=5−4=1d10=4−5=−1 因此
d=n1j=1∑ndj=101(−1)=−0.10 Sd=⎣⎡n−1∑j=1ndj2−n1(∑j=1ndj)2⎦⎤1/2=[10−113−101(−1)2]1/2=1.20 假设我们取 α=0.05。为作出决策,我们计算 t0,若 ∣t0∣>t0.025,9=2.262 则拒绝 H0。配对 t 检验统计量的计算值为
t0=Sd/nd=1.20/10−0.10=−0.26 由于 ∣t0∣=0.26≥t0.025,9=2.262,我们不能拒绝假设 H0:μd=0。也就是说,没有证据表明两种尖头给出不同的硬度读数。图 2.15 给出了自由度为 9 的 t0 分布(本检验的参考分布),并标出了 t0 的值相对于临界域的位置。
表 2.7 给出了用 Minitab 配对 t 检验程序解决该问题时的计算机输出。注意该检验的 P 值为 P≃0.80,这意味着我们在任何合理的显著性水平下都不能拒绝原假设。
2.5.2 配对比较设计的优点
这一试验实际采用的设计称为配对比较设计(paired comparison design),它体现了 1.3 节讨论的区组化原则。实际上,它是一种更一般设计类型的特例,即随机区组设计(randomized block design)。术语区组(block)指的是一个相对齐同的试验单元(在我们的情形中,金属试样就是区组),区组代表对完全随机化的一种限制,因为处理组合只在区组内部随机化。我们将在第 4 章讨论这类设计。在第 4 章中,该设计的数学模型(式 2.39)会写成略有不同的形式。
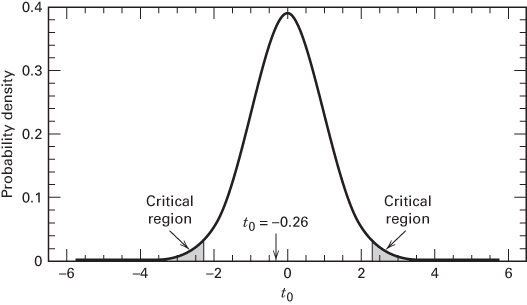
图 2.15 硬度试验问题的参考分布(自由度为 9 的 t 分布)
表 2.7 硬度试验例子的 Minitab 配对 t 检验结果
| Paired T for Tip 1-Tip 2 | | | | |
|---|
| N | Mean | Std. Dev. | SE Mean |
| Tip 1 | 10 | 4.800 | 2.394 | 0.757 |
| Tip 2 | 10 | 4.900 | 2.234 | 0.706 |
| Difference | 10 | -0.100 | 1.197 | 0.379 |
| 95% CI for mean difference: (-0.956, 0.756) t-Test of mean difference = 0 (vs not = 0): T-Value = -0.26 P-Value = 0.798 | | | | |
在结束这个试验的讨论之前,有几点需要说明。注意,虽然取了 2n=2(10)=20 个观测值,但 t 统计量只有 n−1=9 个自由度可用。(我们知道 t 的自由度越大,检验就越灵敏。)通过区组化或配对,我们实际上“损失”了 n−1 个自由度,但我们希望通过消除一个额外的变异来源(试样之间的差异)而更好地了解情况。
我们可以通过比较差值的标准差 Sd 与合并标准差 Sp 来了解配对设计所产生信息的质量,其中 Sp 是试验以完全随机化方式实施、并得到表 2.6 数据时所会得到的值。[1] 把表 2.6 中的数据当作两个独立样本,由式 2.25 算得合并标准差 Sp=2.32。把这一值与 Sd=1.20 相比较,可见区组化或配对把变异的估计降低了将近 50%。
一般来说,当我们本该区组化(或配对)却没有这样做时,Sp 总会大于 Sd。这很容易形式化地证明。如果我们把观测值配对,就容易证明在式 2.39 的模型下 Sd2 是差值 dj 方差的无偏估计量,因为计算差值时区组效应(βj)被消掉了。然而,如果我们不做区组化(或配对),而把观测值当作两个独立样本处理,那么在式 2.39 的模型下 Sp2 就不是 σ2 的无偏估计量。事实上,假定两个总体方差相等,有
E(Sp2)=σ2+j=1∑nβj2 也就是说,区组效应 βj 抬高了方差估计。这就是区组化可以作为一种降噪设计技术的原因。
我们也可以用 μ1−μ2 的置信区间来表达这一试验的结果。使用配对数据,μ1−μ2 的 95% 置信区间为
d±t0.025,9Sd/n−0.10±(2.262)(1.20)/10−0.10±0.86 反之,使用合并的(即独立的)分析,μ1−μ2 的 95% 置信区间为
y1−y2±t0.025,18Spn11+n214.80−4.90±(2.101)(2.32)101+101−0.10±2.18 基于配对分析的置信区间比基于独立分析的置信区间窄得多。这再次说明了区组化的降噪特性。
区组化并不总是最好的设计策略。如果区组内变异与区组间变异相同,那么无论采用哪种设计,y1−y2 的方差都一样。实际上在这种情况下区组化是一个糟糕的设计选择,因为区组化会导致损失 n−1 个自由度,从而实际上使 μ1−μ2 的置信区间更宽。关于区组化的进一步讨论见第 4 章。