11.6 混料试验
前面介绍的响应面设计适用于各因子水平可以独立变化的情形。在混料试验中,因子是混合物的组分,因此各水平并不独立。例如,若 表示混合物中 个组分的比例,则
且
图 11.39 分别展示了两组分和三组分时的约束。两组分设计的因子空间是线段 ,各组分均在 0~1 之间。三组分的混料空间是三角形,其顶点对应纯组分配方,即某一组分占 100%。
三组分混合物的受约束试验区域可方便地用三线坐标图表示,如图 11.40。三条边各表示缺少一个组分的混合物,该组分标在对面的顶点上。每个方向的九条网格线将相应组分按 10% 的增量划分。
单纯形设计用于研究混合物组分对响应变量的影响。 个组分的 单纯形格点设计按下述坐标设置布点:各组分比例取 0~1 之间 个等间距值,
并采用式(11.24)中比例的所有满足总和为 1 的组合。例如,令 、,则
单纯形格点包含以下六次试验:
该设计见图 11.41。三个顶点 、 和 为纯组分,三条边中点 、 和 为二元混合物。图 11.41 还给出了 、 和 单纯形格点设计。一般而言, 单纯形格点设计的点数为
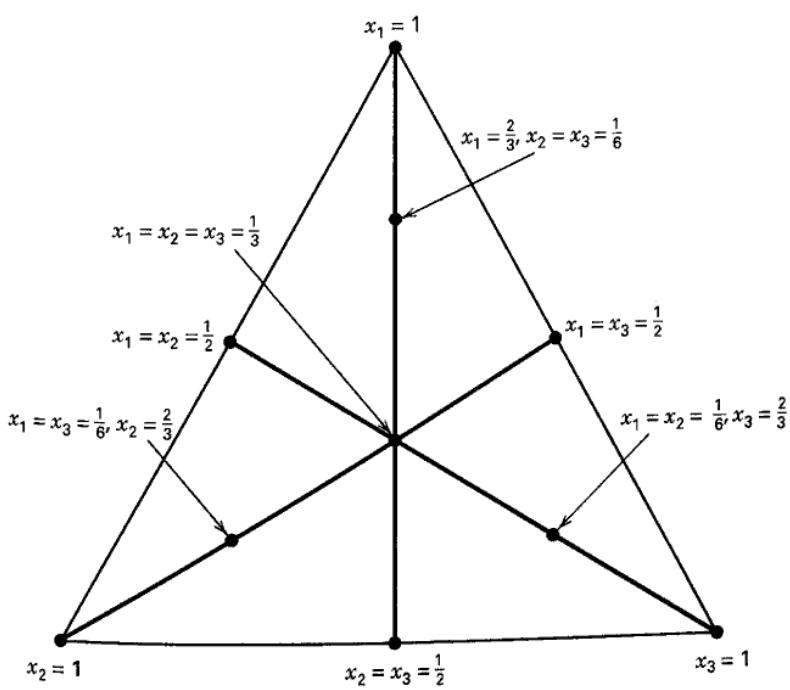
另一种选择是单纯形重心设计。 组分设计有 个点,包括 的 种排列、 的 种排列、 的 种排列,依此类推,以及总体重心 。若干单纯形重心设计见图 11.42。
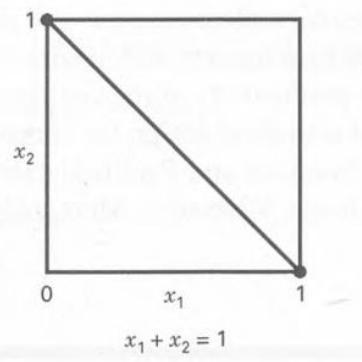
(a)
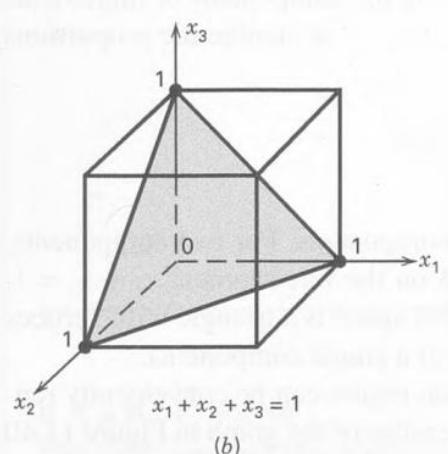
图 11.39
混料的受约束因子空间:(a)两组分;(b)三组分
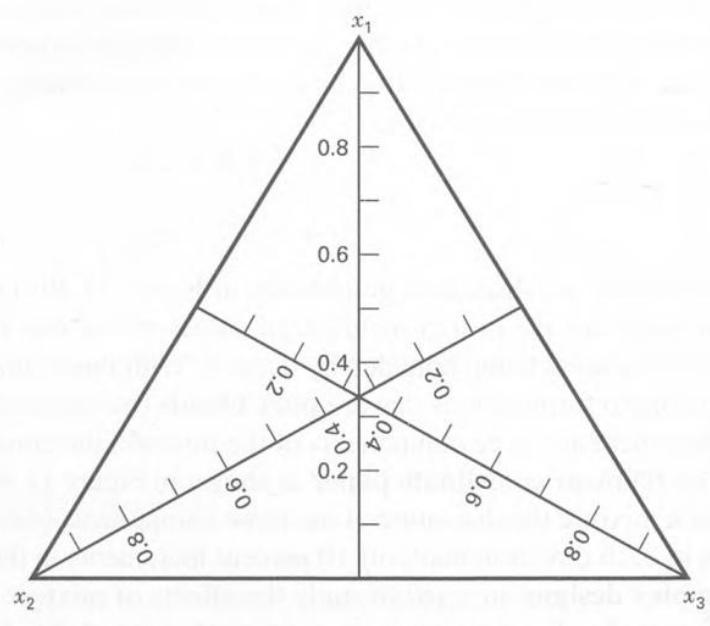
图 11.40 三线坐标系
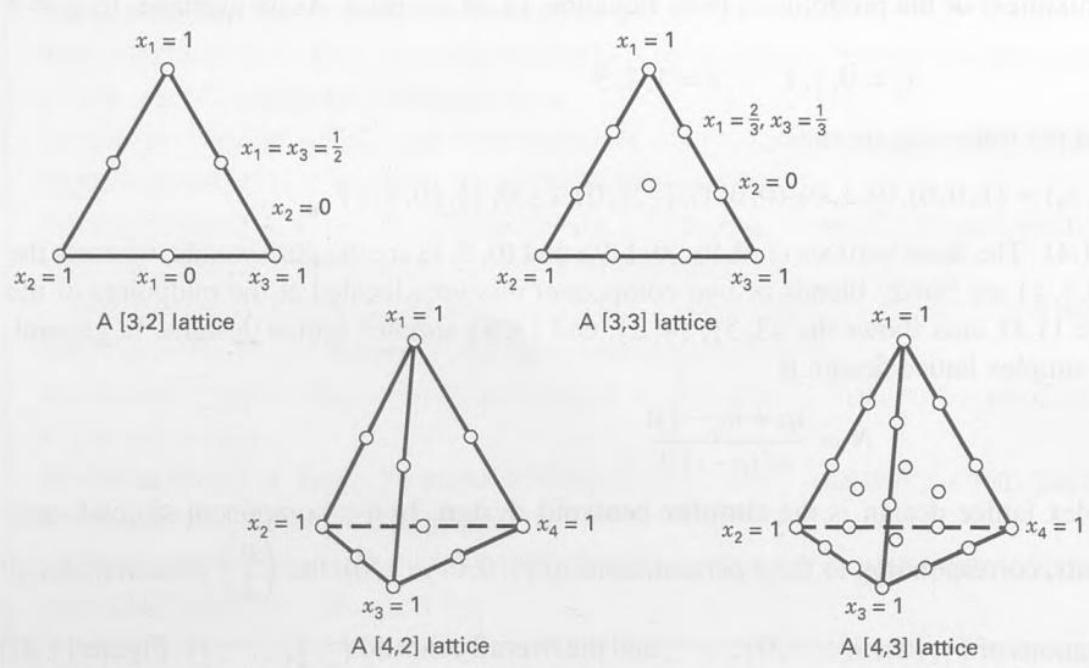
图 11.41 若干三组分与四组分单纯形格点设计
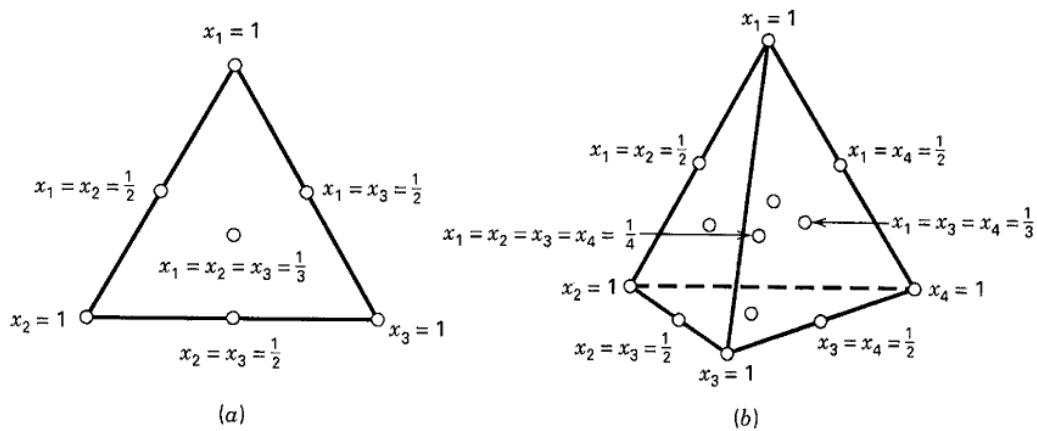
图 11.42 单纯形重心设计:(a)三组分;(b)四组分
上述单纯形设计的一个不足是,大多数试验位于区域边界,因此每次至多包含 个组分中的 个。通常应在区域内部增加试验点,使配方包含全部 个组分。进一步讨论见 Cornell(2002)和 Myers、Montgomery、Anderson-Cook(2009)。
由于约束 ,混料模型不同于通常的响应面多项式。广泛使用的标准混料模型形式如下。
线性模型
二次模型
完整三次模型
特殊三次模型
这些模型的各项有比较直观的解释。在式(11.25)~(11.28)中, 表示纯组分 、其余 时的期望响应。 称为线性混合部分。若组分对之间的非线性混合引起曲率,则 表示协同或拮抗混合效应。混料模型经常需要高阶项,原因有二:研究现象可能复杂;试验区域往往涵盖整个可操作区域,范围较大,需要更精细的模型。
例 11.5 三组分混合物
Cornell(2002)介绍了一项混料试验:将聚乙烯 、聚苯乙烯 和聚丙烯 混合制成纤维,再纺成窗帘用纱。关注的响应是以所施加的千克力表示的纱线伸长性能。采用 单纯形格点设计研究产品,设计与响应见表 11.19。所有设计点都涉及
表 11.19
纱线伸长问题的 单纯形格点设计
| 设计点 | 组分比例 | 伸长性能观测值 | 平均伸长性能(y) | ||
| $x_1$ | $x_2$ | $x_3$ | |||
| 1 | 1 | 0 | 0 | 11.0, 12.4 | 11.7 |
| 2 | $\frac{1}{2}$ | $\frac{1}{2}$ | 0 | 15.0, 14.8, 16.1 | 15.3 |
| 3 | 0 | 1 | 0 | 8.8, 10.0 | 9.4 |
| 4 | 0 | $\frac{1}{2}$ | $\frac{1}{2}$ | 10.0, 9.7, 11.8 | 10.5 |
| 5 | 0 | 0 | 1 | 16.8, 16.0 | 16.4 |
| 6 | $\frac{1}{2}$ | 0 | $\frac{1}{2}$ | 17.7, 16.4, 16.6 | 16.9 |
纯组分或二元混合物,即每种配方至多使用三组分中的两个。在各纯组分处安排两次重复,各二元混合物处安排三次重复。由这些重复观测估计误差标准差,得 。Cornell 拟合二阶混料多项式,得到
可以证明,该模型充分描述了响应。由于 ,可断定组分 3(聚丙烯)制得的纱线伸长性能最高。此外, 和 为正,说明组分 1 与 2 或组分 1 与 3 混合后,响应高于仅按纯组分响应加权平均所预测的值,属于协同混合效应。由于 为负,组分 2 与 3 存在拮抗混合效应。
图 11.43 给出了伸长性能等高线,有助于解释结果。如果希望响应最大,应选择约含 80% 组分 3、20% 组分 1 的混合物。
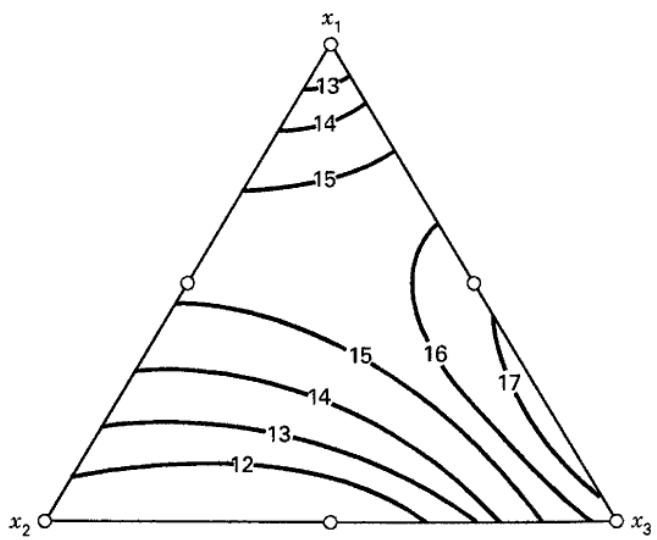
图 11.43 例 11.5 二阶混料模型预测的纱线伸长性能等高线
单纯形格点设计和重心设计主要采用边界点。如果希望预测完整混合物的性质,最好增加单纯形内部的试验。建议在通常的单纯形设计中增加轴点,并在尚未包含总体重心时加入重心。
第 个组分的轴线从基点 、其余 延伸到对面顶点 、其余 。基点总是位于该顶点对面的 维边界的重心上,该边界有时称为 维平坦面。按组分比例坐标,轴线长为一个单位。轴点布置在组分轴线上距总体重心 的位置, 最大为 。建议将轴点取在重心与各顶点的中点,即 。这些点有时称为轴向检验配方,因为常见做法是在初步拟合时不使用它们,再用轴点响应检查初步模型的充分性。
图 11.44 是增加轴点后的 单纯形格点设计,共 10 个点,其中四个在内部。 格点设计能够拟合完整三次模型,而增广设计不能;但增广设计可以拟合特殊三次模型,或在二次模型中加入 等特殊四次项。在研究完整混合物响应方面,增广格点设计能够检测并描述三角形内部那些完整三次模型项无法解释的曲率,因而具有优势。它检测失拟的能力也强于 格点设计。当试验者不确定适当模型,并打算从简单多项式(可能为一阶)开始,先检验失拟,再逐步加入高阶项并重新检验时,这一点特别有用。
某些混料问题对各组分还有额外约束。以下形式的下限约束
十分常见。只有下限约束时,可行设计区域仍为单纯形,但内接于原单纯形。引入伪组分可简化问题,其定义为
图 11.44 增广单纯形格点设计
其中 。此时
因而有下限约束时,利用伪组分仍可采用单纯形设计。通过式(11.29)的逆变换,将伪组分配方转回原组分配方。若某次试验中第 个伪组分取值为 ,则原组分为
若组分同时有上限和下限,可行区域不再是单纯形,而是不规则多面体。由于区域形状不标准,计算机生成的最优设计对这类混料问题非常有用。
例 11.6 涂料配方
试验者希望优化汽车透明面漆配方。这类产品复杂,性能要求明确:客户要求努氏硬度超过 25,固体含量低于 30%。透明面漆由单体 、交联剂 和树脂 三个组分组成,比例受到以下约束:
由此形成图 11.45 的受约束试验区域。由于关注区域不是单纯形,采用 D 最优设计。假定两个响应均可用二次混料模型描述,可通过 Design-Expert 生成图 11.45 所示区域内的设计。除拟合二次混料模型所需的六次试验外,再增加四个不同的试验点检查失拟,并重复其中四次试验以估计纯误差。候选点包括顶点、边中点、总体重心,以及位于重心与顶点中间的检验点。
表 11.20 给出了 14 次试验的设计及硬度、固体含量响应。两个响应的二次模型拟合结果分别见表 11.21 和表 11.22,均拟合良好。表中列出了以伪组分表示的拟合方程,响应等高线图见图 11.46 和图 11.47。
图 11.48 叠加了两个响应面,显示努氏硬度为 25 和固体含量为 30% 的等高线。产品的可行区域是图中央附近的未加阴影区域。显然,单体、交联剂和树脂存在多种比例组合,均可使透明面漆满足性能要求。
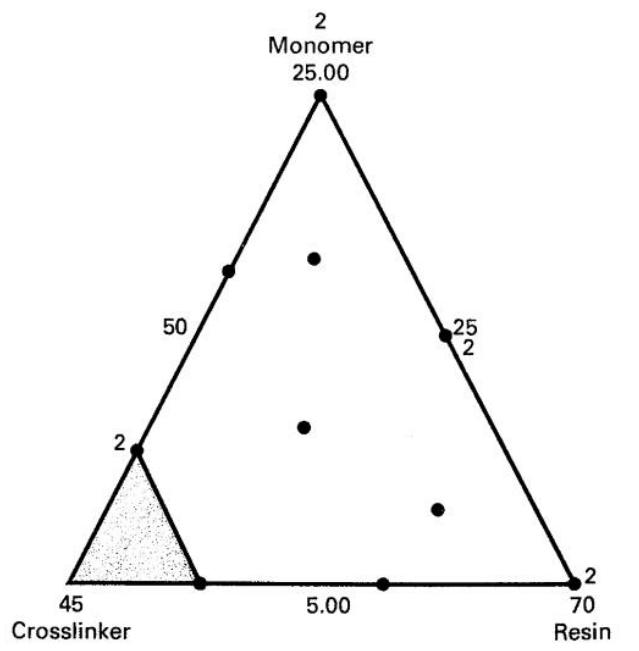
图 11.45 例 11.6 涂料配方的受约束试验区域(采用实际组分比例)
表 11.20 例 11.6 涂料配方问题的 D 最优设计
| 标准顺序 | 试验 | 单体 $x_1$ | 交联剂 $x_2$ | 树脂 $x_3$ | Hardness $y_1$ | Solids $y_2$ |
| 1 | 2 | 17.50 | 32.50 | 50.00 | 29 | 9.539 |
| 2 | 1 | 10.00 | 40.00 | 50.00 | 26 | 27.33 |
| 3 | 4 | 15.00 | 25.00 | 60.00 | 17 | 29.21 |
| 4 | 13 | 25.00 | 25.00 | 50.00 | 28 | 30.46 |
| 5 | 7 | 5.00 | 25.00 | 70.00 | 35 | 74.98 |
| 6 | 3 | 5.00 | 32.50 | 62.50 | 31 | 31.5 |
| 7 | 6 | 11.25 | 32.50 | 56.25 | 21 | 15.59 |
| 8 | 11 | 5.00 | 40.00 | 55.00 | 20 | 19.2 |
| 9 | 10 | 18.13 | 28.75 | 53.13 | 29 | 23.44 |
| 10 | 14 | 8.13 | 28.75 | 63.13 | 25 | 32.49 |
| 11 | 12 | 25.00 | 25.00 | 50.00 | 19 | 23.01 |
| 12 | 9 | 15.00 | 25.00 | 60.00 | 14 | 41.46 |
| 13 | 5 | 10.00 | 40.00 | 50.00 | 30 | 32.98 |
| 14 | 8 | 5.00 | 25.00 | 70.00 | 23 | 70.95 |
表 11.21 硬度响应的模型拟合
| 响应:硬度 | |||||
| 二次混料模型的方差分析 | |||||
| 方差分析表〔偏平方和〕 | |||||
| 来源 | 平方和 | DF | 均方 | F 值 | P 值 |
| 模型 | 279.73 | 5 | 55.95 | 2.37 | 0.1329 |
| 线性混料模型 | 29.13 | 2 | 14.56 | 0.62 | 0.5630 |
| AB | 72.61 | 1 | 72.61 | 3.08 | 0.1174 |
| AC | 179.67 | 1 | 179.67 | 7.62 | 0.0247 |
| BC | 8.26 | 1 | 8.26 | 0.35 | 0.5703 |
| 残差 | 188.63 | 8 | 23.58 | ||
| 失拟 | 63.63 | 4 | 15.91 | 0.51 | 0.7354 |
| 纯误差 | 125.00 | 4 | 31.25 | ||
| 校正总计 | 468.36 | 13 | |||
| 标准差 | 4.86 | R² | 0.5973 | ||
| 均值 | 24.79 | 调整 R² | 0.3455 | ||
| C.V. | 19.59 | 预测 R² | -0.3635 | ||
| PRESS | 638.60 | 充分精度 | 4.975 | ||
| 表 11.21(续) | |||||
| 组分 | 系数估计 | DF | 标准误 | 95% 置信下限 | 95% 置信上限 |
| A—单体 | 23.81 | 1 | 3.36 | 16.07 | 31.55 |
| B—交联剂 | 16.40 | 1 | 7.68 | -1.32 | 34.12 |
| C—树脂 | 29.45 | 1 | 3.36 | 21.71 | 37.19 |
| AB | 44.42 | 1 | 25.31 | -13.95 | 102.80 |
| AC | -44.01 | 1 | 15.94 | -80.78 | -7.25 |
| BC | 13.80 | 1 | 23.32 | -39.97 | 67.57 |
| 以伪组分表示的最终方程: | |||||
| 硬度 =+23.81 * A+16.40 * B+29.45 * C+44.42 * A * B-44.01 * A * C+13.80 * B * C | |||||
表 11.22 固体含量响应的模型拟合
| 响应:固体含量 | |||||
| 二次混料模型的方差分析 | |||||
| 方差分析表〔偏平方和〕 | |||||
| 来源 | 平方和 | DF | 均方 | F 值 | P 值 |
| 模型 | 4297.94 | 5 | 859.59 | 25.78 | <0.0001 |
| 线性混料模型 | 2931.09 | 2 | 1465.66 | 43.95 | <0.0001 |
| AB | 211.20 | 1 | 211.20 | 6.33 | 0.0360 |
| AC | 285.67 | 1 | 285.67 | 8.57 | 0.0191 |
| BC | 1036.72 | 1 | 1036.72 | 31.09 | 0.0005 |
| 残差 | 266.79 | 8 | 33.35 | ||
| 失拟 | 139.92 | 4 | 34.98 | 1.10 | 0.4633 |
| 纯误差 | 126.86 | 4 | 31.72 | ||
| 校正总计 | 4564.73 | 13 | |||
| 标准差 | 5.77 | R² | 0.9416 | ||
| 均值 | 33.01 | 调整 R² | 0.9050 | ||
| C.V. | 17.49 | 预测 R² | 0.7827 | ||
| PRESS | 991.86 | 充分精度 | 15.075 | ||
| 组分 | 系数估计 | DF | 标准误 | 95% 置信下限 | 95% 置信上限 |
| A—单体 | 26.53 | 1 | 3.99 | 17.32 | 35.74 |
| B—交联剂 | 46.60 | 1 | 9.14 | 25.53 | 67.68 |
| C—树脂 | 73.23 | 1 | 3.99 | 64.02 | 82.43 |
| AB | -75.76 | 1 | 30.11 | -145.19 | -6.34 |
| AC | -55.50 | 1 | 18.96 | -99.22 | -11.77 |
| BC | -154.61 | 1 | 27.73 | -218.56 | -90.67 |
| 以伪组分表示的最终方程: | |||||
| 固体含量 = | |||||
| +26.53 * A | |||||
| +46.60 * B | |||||
| +73.23 * C | |||||
| -75.76 * A * B | |||||
| -55.50 * A * C | |||||
| -154.61 * B * C | |||||
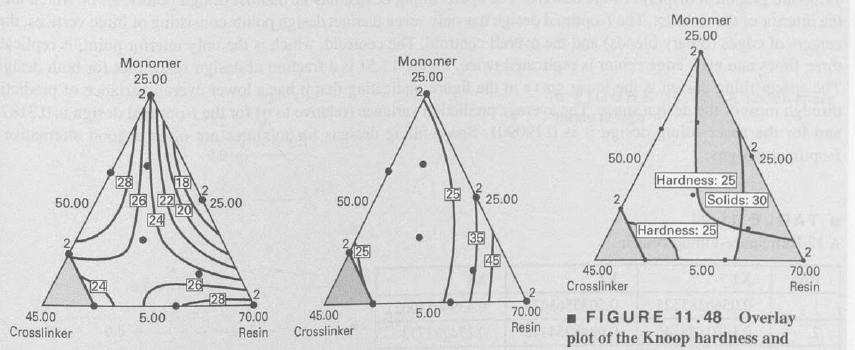
图 11.46~11.48 从左至右分别为努氏硬度等高线、固体含量等高线、二者叠加得到的可行区域。
除 D 和 I 准则之外,还有其他准则可用于混料设计。基于距离的设计使设计点尽量分散、点间距离尽量大,通常比 D 或 I 准则形成更多内部点。极端顶点法先取顶点,再加入边中点及各子空间重心,直至达到所需点数。也可使用空间填充策略;JMP 的空间填充算法本质上使候选设计点之间距离的乘积最大。
表 11.23
12 次试验的 I 最优设计
| 试验 | X1 | X2 | X3 |
| 1 | 0.5 | 0 | 0.5 |
| 2 | 1 | 0 | 0 |
| 3 | 0.33333333 | 0.33333333 | 0.33333333 |
| 4 | 0 | 0.5 | 0.5 |
| 5 | 0.5 | 0.5 | 0 |
| 6 | 0 | 0 | 1 |
| 7 | 0.5 | 0 | 0.5 |
| 8 | 0.5 | 0.5 | 0 |
| 9 | 0.33333333 | 0.333333333 | 0.333333333 |
| 10 | 0.33333333 | 0.333333333 | 0.333333333 |
| 11 | 0 | 1 | 0 |
| 12 | 0 | 0.5 | 0.5 |
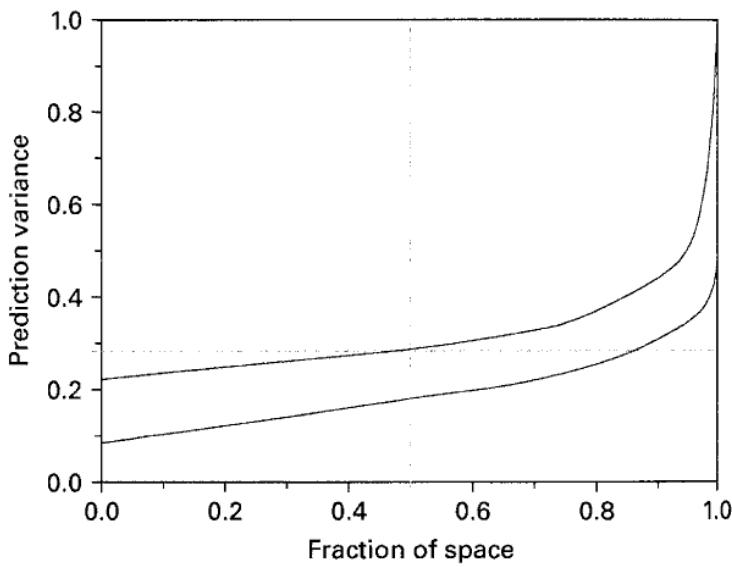
为说明空间填充准则,考虑三组分混料设计。表 11.23 给出 12 次试验的 I 最优设计,表 11.24 给出 12 次试验的空间填充设计,图形分别见图 11.49 和图 11.50。空间填充设计有 12 个不同的点,均位于单纯形内部。I 最优设计仅有七个不同点,包括三个顶点、三个边中点(二元混合物)和总体重心;唯一的内部点重心安排三次试验,各边中点安排两次试验。图 11.51 是两个设计的 FDS 图,下方曲线对应空间填充设计,表明其在大部分设计空间内的预测方差较低。相对于误差方差 ,I 最优设计的平均预测方差为 0.318271,空间填充设计为 0.190901。因此,混料空间填充设计常是 I 最优设计的良好替代选择。
表 11.24
12 次试验的空间填充设计
| 试验 | X1 | X2 | X3 |
| 1 | 0.0566385525 | 0.5035563474 | 0.4398051002 |
| 2 | 0.1403888146 | 0.6848254125 | 0.174785773 |
| 3 | 0.5979278886 | 0.1685717851 | 0.2335003264 |
| 4 | 0.0021204609 | 0.277430271 | 0.7204492681 |
| 5 | 0.3064350687 | 0.1050457166 | 0.5885192147 |
| 6 | 0.6951342573 | 0.3036842719 | 0.0011814709 |
| 7 | 0.2684127928 | 0.3996327787 | 0.3319544285 |
| 8 | 0.0164724047 | 0.9652091258 | 0.0183184695 |
| 9 | 0.5236343265 | 0.002453615 | 0.4739120585 |
| 10 | 0.3942469565 | 0.5494100414 | 0.0563430022 |
| 11 | 0.8560801746 | 0.0425991599 | 0.1013206655 |
| 12 | 0.0976192298 | 0.0288613381 | 0.8735194321 |
图 11.49 12 次试验的 I 最优设计
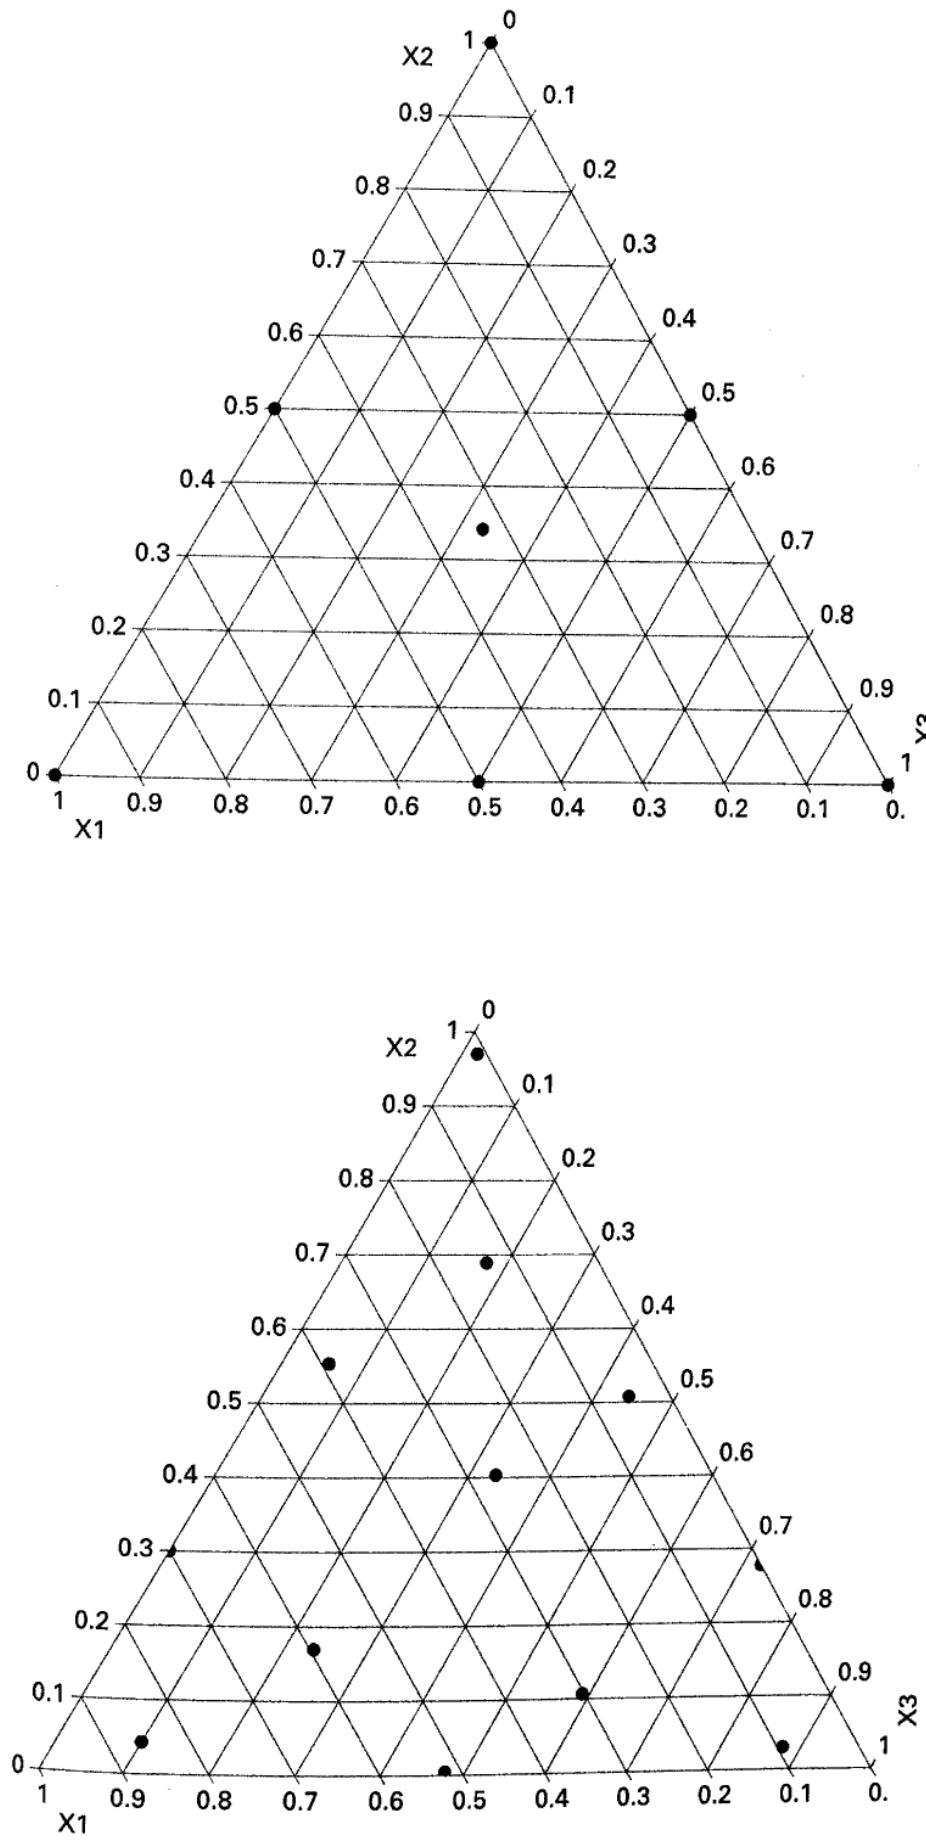
图 11.50 12 次试验的空间填充设计
图 11.51 图 11.49 的 I 最优设计与图 11.50 的空间填充设计的 FDS 图;下方曲线为空间填充设计