4.2 拉丁方设计
在 4.1 节中,我们把随机完全区组设计作为一种通过消除已知且可控干扰变量所引起的变异来减小试验残差误差的设计引入了进来。还有其他几类利用区组化原理的设计。例如,假设一位试验者正在研究用于空勤人员逃生系统的火箭推进剂的五种不同配方对观测到的燃烧速率的影响。每种配方由一批原材料混合而成,而每批原材料只够测试五种配方。此外,这些配方由几位操作人员配制,而操作人员的技能与经验可能存在很大差异。因此,设计中似乎需要"平均掉"两个干扰因子:原材料批次和操作人员。这一问题合适的设计要求每种配方在每批原材料中恰好测试一次,并且每种配方恰好由五位操作人员各配制一次。所得设计(见表 4.9)称为拉丁方设计 (Latin square design)。注意该设计呈方形排列,五种配方(处理)用拉丁字母 A、B、C、D、E 表示,拉丁方因此得名。我们看到原材料批次(行)和操作人员(列)都与处理正交。[1]
表 4.9 火箭推进剂问题的拉丁方设计
原材料批次 操作人员 1 操作人员 2 操作人员 3 操作人员 4 操作人员 5 1 A = 24 B = 20 C = 19 D = 24 E = 24 2 B = 17 C = 24 D = 30 E = 27 A = 36 3 C = 18 D = 38 E = 26 A = 27 B = 21 4 D = 26 E = 31 A = 26 B = 23 C = 22 5 E = 22 A = 30 B = 20 C = 29 D = 31
拉丁方设计用于消除两个干扰变异源;也就是说,它系统地允许在两个方向上区组化。因此,行与列实际上代表对随机化的两种限制。一般地,p p p p × p p \times p p × p p p p p p p p 2 p^{2} p 2 p p p
4 × 4 4 \times 4 4 × 4 5 × 5 5 \times 5 5 × 5 6 × 6 6 \times 6 6 × 6 ABDC ADBEC ADCEBF BCAD DACBE BAECFD CDBA CBEDA CEDFAB DACB BEACD DCFBEA ECDAB FBADCE EFBADC
拉丁方与一种起源于日本、称为数独(sudoku,日语意为"单独的数字")的流行智力游戏密切相关。这种游戏通常由一个 9 × 9 9 \times 9 9 × 9 3 × 3 3 \times 3 3 × 3 3 × 3 3 \times 3 3 × 3 9 × 9 9 \times 9 9 × 9 3 × 3 3 \times 3 3 × 3 9 × 9 9 \times 9 9 × 9 6 × 1 0 21 6 \times 10^{21} 6 × 1 0 21
视线索数目与方格大小不同,数独可能极难求解。求解 n × n n \times n n × n n n n
求解数独还等价于对一幅图进行"着色"——即按特定方式给点(顶点)和线(边)组成的阵列着色。此时图有 81 个顶点,方格的每个单元对应一个顶点。视题目而定,只有某些顶点对之间有线相连。在有些顶点已经被指定"颜色"(从九种数字可能中选取)的前提下,问题是要为其余顶点"着色",使得由边相连的任意两个顶点颜色不同。
拉丁方的统计模型为
y i j k = μ + α i + τ j + β k + ε i j k { i = 1 , 2 , … , p j = 1 , 2 , … , p k = 1 , 2 , … , p (4.26) y_{ijk} = \mu + \alpha_{i} + \tau_{j} + \beta_{k} + \varepsilon_{ijk} \quad \left\{ \begin{array}{l} i = 1, 2, \ldots, p \\ j = 1, 2, \ldots, p \\ k = 1, 2, \ldots, p \end{array} \right. \tag{4.26} y ijk = μ + α i + τ j + β k + ε ijk ⎩ ⎨ ⎧ i = 1 , 2 , … , p j = 1 , 2 , … , p k = 1 , 2 , … , p ( 4.26 ) 其中 y i j k y_{ijk} y ijk i i i k k k j j j μ \mu μ α i \alpha_{i} α i i i i τ j \tau_{j} τ j j j j β k \beta_{k} β k k k k ε i j k \varepsilon_{ijk} ε ijk i , j , k i,j,k i , j , k i = 2 i=2 i = 2 k = 3 k=3 k = 3 j = 4 j=4 j = 4 i = 1 i=1 i = 1 j = 3 j=3 j = 3 k = 3 k=3 k = 3 [2]
方差分析就是把 N = p 2 N = p^{2} N = p 2
S S T = S S 行 + S S 列 + S S 处理 + S S E (4.27) SS_{T} = SS_{\text{行}} + SS_{\text{列}} + SS_{\text{处理}} + SS_{E} \tag{4.27} S S T = S S 行 + S S 列 + S S 处理 + S S E ( 4.27 ) 相应的自由度为
p 2 − 1 = p − 1 + p − 1 + p − 1 + ( p − 2 ) ( p − 1 ) p^{2} - 1 = p - 1 + p - 1 + p - 1 + (p-2)(p-1) p 2 − 1 = p − 1 + p − 1 + p − 1 + ( p − 2 ) ( p − 1 ) 在 ε i j k \varepsilon_{ijk} ε ijk N I D ( 0 , σ 2 ) \mathrm{NID}(0,\sigma^{2}) NID ( 0 , σ 2 ) σ 2 \sigma^{2} σ 2
F 0 = M S 处理 M S E F_{0} = \frac{MS_{\text{处理}}}{MS_{E}} F 0 = M S E M S 处理 在原假设下它服从 F p − 1 , ( p − 2 ) ( p − 1 ) F_{p-1,(p-2)(p-1)} F p − 1 , ( p − 2 ) ( p − 1 ) M S 行 MS_{\text{行}} M S 行 M S 列 MS_{\text{列}} M S 列 M S E MS_{E} M S E
用处理总和、行总和与列总和表示的方差分析计算过程见表 4.10。由各平方和的计算公式可以看出,这一分析是 RCBD 的简单推广,其中行所对应的平方和由行总和得到。
表 4.10 拉丁方设计的方差分析
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 处理 S S 处理 = 1 p ∑ j = 1 p y . j . 2 − y . . . 2 N SS_{\text{处理}} = \frac{1}{p} \sum_{j=1}^{p} y_{.j.}^{2} - \frac{y_{...}^{2}}{N} S S 处理 = p 1 ∑ j = 1 p y . j . 2 − N y ... 2 p − 1 p-1 p − 1 S S 处理 p − 1 \frac{SS_{\text{处理}}}{p-1} p − 1 S S 处理 F 0 = M S 处理 M S E F_{0} = \frac{MS_{\text{处理}}}{MS_{E}} F 0 = M S E M S 处理 行 S S 行 = 1 p ∑ i = 1 p y i . . 2 − y . . . 2 N SS_{\text{行}} = \frac{1}{p} \sum_{i=1}^{p} y_{i..}^{2} - \frac{y_{...}^{2}}{N} S S 行 = p 1 ∑ i = 1 p y i .. 2 − N y ... 2 p − 1 p-1 p − 1 S S 行 p − 1 \frac{SS_{\text{行}}}{p-1} p − 1 S S 行 列 S S 列 = 1 p ∑ k = 1 p y . . k 2 − y . . . 2 N SS_{\text{列}} = \frac{1}{p} \sum_{k=1}^{p} y_{..k}^{2} - \frac{y_{...}^{2}}{N} S S 列 = p 1 ∑ k = 1 p y .. k 2 − N y ... 2 p − 1 p-1 p − 1 S S 列 p − 1 \frac{SS_{\text{列}}}{p-1} p − 1 S S 列 误差 S S E SS_{E} S S E ( p − 2 ) ( p − 1 ) (p-2)(p-1) ( p − 2 ) ( p − 1 ) S S E ( p − 2 ) ( p − 1 ) \frac{SS_{E}}{(p-2)(p-1)} ( p − 2 ) ( p − 1 ) S S E 总计 S S T = ∑ i ∑ j ∑ k y i j k 2 − y . . . 2 N SS_{T} = \sum_{i} \sum_{j} \sum_{k} y_{ijk}^{2} - \frac{y_{...}^{2}}{N} S S T = ∑ i ∑ j ∑ k y ijk 2 − N y ... 2 p 2 − 1 p^{2}-1 p 2 − 1
例 4.2 ¶ 考虑前面描述的火箭推进剂问题,其中原材料批次和操作人员都代表对随机化的限制。该试验的设计(见表 4.9)是一个 5 × 5 5 \times 5 5 × 5
S S T = ∑ i ∑ j ∑ k y i j k 2 − y . . . 2 N = 680 − ( 10 ) 2 25 = 676.00 \begin{array}{r l} SS_{T} & = \sum_{i} \sum_{j} \sum_{k} y_{ijk}^{2} - \frac{y_{...}^{2}}{N} \\ & = 680 - \frac{(10)^{2}}{25} = 676.00 \end{array} S S T = ∑ i ∑ j ∑ k y ijk 2 − N y ... 2 = 680 − 25 ( 10 ) 2 = 676.00 S S 批次 = 1 p ∑ i = 1 p y i . . 2 − y . . . 2 N = 1 5 [ ( − 14 ) 2 + 9 2 + 5 2 + 3 2 + 7 2 ] − ( 10 ) 2 25 = 68.00 \begin{array}{r l} SS_{\text{批次}} & = \frac{1}{p} \sum_{i=1}^{p} y_{i..}^{2} - \frac{y_{...}^{2}}{N} \\ & = \frac{1}{5} \left[ (-14)^{2} + 9^{2} + 5^{2} + 3^{2} + 7^{2} \right] - \frac{(10)^{2}}{25} = 68.00 \end{array} S S 批次 = p 1 ∑ i = 1 p y i .. 2 − N y ... 2 = 5 1 [ ( − 14 ) 2 + 9 2 + 5 2 + 3 2 + 7 2 ] − 25 ( 10 ) 2 = 68.00 S S 操作人员 = 1 p ∑ k = 1 p y . . k 2 − y . . . 2 N = 1 5 [ ( − 18 ) 2 + 1 8 2 + ( − 4 ) 2 + 5 2 + 9 2 ] − ( 10 ) 2 25 = 150.00 \begin{array}{r l} SS_{\text{操作人员}} & = \frac{1}{p} \sum_{k=1}^{p} y_{..k}^{2} - \frac{y_{...}^{2}}{N} \\ & = \frac{1}{5} \left[ (-18)^{2} + 18^{2} + (-4)^{2} + 5^{2} + 9^{2} \right] - \frac{(10)^{2}}{25} = 150.00 \end{array} S S 操作人员 = p 1 ∑ k = 1 p y .. k 2 − N y ... 2 = 5 1 [ ( − 18 ) 2 + 1 8 2 + ( − 4 ) 2 + 5 2 + 9 2 ] − 25 ( 10 ) 2 = 150.00 各处理(拉丁字母)的总和为
拉丁字母 处理总和 A y . 1. = 18 y_{.1.} = 18 y .1. = 18 B y . 2. = − 24 y_{.2.} = -24 y .2. = − 24 C y . 3. = − 13 y_{.3.} = -13 y .3. = − 13 D y . 4. = 24 y_{.4.} = 24 y .4. = 24 E y . 5. = 5 y_{.5.} = 5 y .5. = 5
由这些总和算出各配方对应的平方和:
S S 配方 = 1 p ∑ j = 1 p y . j . 2 − y . . . 2 N = 1 8 2 + ( − 24 ) 2 + ( − 13 ) 2 + 2 4 2 + 5 2 5 − ( 10 ) 2 25 = 330.00 \begin{array}{r l} SS_{\text{配方}} & = \frac{1}{p} \sum_{j=1}^{p} y_{.j.}^{2} - \frac{y_{...}^{2}}{N} \\ & = \frac{18^{2} + (-24)^{2} + (-13)^{2} + 24^{2} + 5^{2}}{5} - \frac{(10)^{2}}{25} = 330.00 \end{array} S S 配方 = p 1 ∑ j = 1 p y . j . 2 − N y ... 2 = 5 1 8 2 + ( − 24 ) 2 + ( − 13 ) 2 + 2 4 2 + 5 2 − 25 ( 10 ) 2 = 330.00 误差平方和由相减得到
S S E = S S T − S S 批次 − S S 操作人员 − S S 配方 = 676.00 − 68.00 − 150.00 − 330.00 = 128.00 \begin{array}{r l} SS_{E} & = SS_{T} - SS_{\text{批次}} - SS_{\text{操作人员}} - SS_{\text{配方}} \\ & = 676.00 - 68.00 - 150.00 - 330.00 = 128.00 \end{array} S S E = S S T − S S 批次 − S S 操作人员 − S S 配方 = 676.00 − 68.00 − 150.00 − 330.00 = 128.00 方差分析汇总于表 4.12。我们得出结论:不同火箭推进剂配方产生的平均燃烧速率存在显著差异。此外有迹象表明操作人员之间存在差异,因此以该因子作区组是一个好的预防措施。原材料批次之间没有强有力的差异证据,所以在这个特定试验中,我们对该变异源的担心似乎是多余的。不过,以原材料批次作区组通常仍是好做法。
表 4.11 火箭推进剂问题的编码数据
原材料批次 操作人员 1 操作人员 2 操作人员 3 操作人员 4 操作人员 5 y i . . y_{i..} y i .. 1 A=-1 B=-5 C=-6 D=-1 E=-1 -14 2 B=-8 C=-1 D=5 E=2 A=11 9 3 C=-7 D=13 E=1 A=2 B=-4 5 4 D=1 E=6 A=1 B=-2 C=-3 3 5 E=-3 A=5 B=-5 C=4 D=6 7 y . . k y_{..k} y .. k -18 18 -4 5 9 10 = y . . . 10 = y_{...} 10 = y ...
表 4.12 火箭推进剂试验的方差分析
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 P P P 配方 330.00 4 82.50 7.73 0.0025 原材料批次 68.00 4 17.00 操作人员 150.00 4 37.50 误差 128.00 12 10.67 总计 676.00 24
与任何设计问题一样,试验者应当通过检查并绘制残差图来考察模型的适合性。对拉丁方而言,残差由下式给出:
e i j k = y i j k − y ^ i j k = y i j k − y ‾ i . . − y ‾ . j . − y ‾ . . k + 2 y ‾ . . . \begin{array}{r l} e_{ijk} & = y_{ijk} - \hat{y}_{ijk} \\ & = y_{ijk} - \overline{y}_{i..} - \overline{y}_{.j.} - \overline{y}_{..k} + 2\overline{y}_{...} \end{array} e ijk = y ijk − y ^ ijk = y ijk − y i .. − y . j . − y .. k + 2 y ... 读者应当求出例 4.2 的残差,并绘制适当的图形。
标准拉丁方 (standard Latin square)是指第一行与第一列都由按字母顺序排列的字母构成的拉丁方,即例 4.3 所示的设计。标准拉丁方总可以这样得到:把第一行按字母顺序写出,然后每一后继行都取它正上方那一行向左移一位。表 4.13 汇总了关于拉丁方与标准拉丁方的重要事实。
表 4.13 各种大小的标准拉丁方以及拉丁方的个数 a ^{a} a
标准方示例
3 × 3 3 \times 3 3 × 3
4 × 4 4 \times 4 4 × 4
5 × 5 5 \times 5 5 × 5
A B C D E B A E C D C D A E B D E B A C E C D B A
6 × 6 6 \times 6 6 × 6
A B C D E F B C F A D E C F B E A D D E A B F C E A D F C B F D E C B A
7 × 7 7 \times 7 7 × 7
A B C D E F G B C D E F G A C D E F G A B D E F G A B C E F G A B C D F G A B C D E G A B C D E F
p × p p \times p p × p
ABC⋯ \cdots ⋯ BCD⋯ \cdots ⋯ CDE⋯ \cdots ⋯ ⋮ \vdots ⋮ PAB⋯ \cdots ⋯
3 × 3 3 \times 3 3 × 3 4 × 4 4 \times 4 4 × 4 5 × 5 5 \times 5 5 × 5 6 × 6 6 \times 6 6 × 6 7 × 7 7 \times 7 7 × 7 p × p p \times p p × p 标准方个数 1 4 56 9408 16,942,080 — 拉丁方总数 12 576 161,280 818,851,200 61,479,419,904,000 p ! ( p − 1 ) ! × p!(p-1)! \times p ! ( p − 1 )! ×
a ^{a} a 7 × 7 7 \times 7 7 × 7
与任何试验设计一样,拉丁方中的观测值应当按随机顺序获取。恰当的随机化做法是随机选取所用的那个特定的方。由表 4.13 可见,某一特定大小的拉丁方数量极大,因此不可能把所有方都列举出来再随机选一个。通常的做法是从这类设计表(如 Fisher and Yates (1953))中任选一个拉丁方,或者从一个标准方出发,然后把各行、各列以及各字母的顺序随机排列。Fisher and Yates (1953) 对此有更完整的讨论。
拉丁方中偶尔有一个观测值缺失。对 p × p p \times p p × p
y i j k = p ( y i . . ′ + y . j . ′ + y . . k ′ ) − 2 y . . . ′ ( p − 2 ) ( p − 1 ) (4.28) y_{ijk} = \frac{p(y_{i..}^{\prime} + y_{.j.}^{\prime} + y_{..k}^{\prime}) - 2y_{...}^{\prime}}{(p-2)(p-1)} \tag{4.28} y ijk = ( p − 2 ) ( p − 1 ) p ( y i .. ′ + y . j . ′ + y .. k ′ ) − 2 y ... ′ ( 4.28 ) 其中带撇号的量表示含该缺失值的行、列与处理总和,y . . . ′ y_{...}^{\prime} y ... ′
拉丁方在行与列代表试验者实际希望研究的因子、且不存在随机化限制的场合也可能有用。这样,三个因子(行、列和字母)各取 p p p p 2 p^{2} p 2
**拉丁方的重复。**小拉丁方的一个缺点是它们提供的误差自由度相对较少。例如,3 × 3 3 \times 3 3 × 3 4 × 4 4 \times 4 4 × 4
拉丁方可以用几种方式重复。为说明起见,假设例 4.3 中用到的 5 × 5 5 \times 5 5 × 5 n n n [3]
在每次重复中使用相同的批次和操作人员。
在每次重复中使用相同的批次但不同的操作人员(或者等价地,使用相同的操作人员但不同的批次)。
在每次重复中使用不同的批次和不同的操作人员。
方差分析取决于重复方式。
考虑情形 1,即每次重复中使用相同的行、列区组因子水平。设 y i j k l y_{ijkl} y ijk l i i i j j j k k k l l l N = n p 2 N = np^{2} N = n p 2
现在考虑情形 2,并假定每次重复中使用新的原材料批次但相同的操作人员。于是每次重复中有 5 个新行(一般地,p p p n n n
表 4.14 重复拉丁方的方差分析:情形 1
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 处理 1 n p ∑ j = 1 p y j . . 2 − y . . . 2 N \frac{1}{np}\sum_{j=1}^{p} y_{j..}^{2} - \frac{y_{...}^{2}}{N} n p 1 ∑ j = 1 p y j .. 2 − N y ... 2 p − 1 p-1 p − 1 S S 处理 p − 1 \frac{SS_{\text{处理}}}{p-1} p − 1 S S 处理 M S 处理 M S E \frac{MS_{\text{处理}}}{MS_{E}} M S E M S 处理 行 1 n p ∑ i = 1 p y i . . 2 − y . . . 2 N \frac{1}{np}\sum_{i=1}^{p} y_{i..}^{2} - \frac{y_{...}^{2}}{N} n p 1 ∑ i = 1 p y i .. 2 − N y ... 2 p − 1 p-1 p − 1 S S 行 p − 1 \frac{SS_{\text{行}}}{p-1} p − 1 S S 行 列 1 n p ∑ k = 1 p y . . k . 2 − y . . . 2 N \frac{1}{np}\sum_{k=1}^{p} y_{..k.}^{2} - \frac{y_{...}^{2}}{N} n p 1 ∑ k = 1 p y .. k . 2 − N y ... 2 p − 1 p-1 p − 1 S S 列 p − 1 \frac{SS_{\text{列}}}{p-1} p − 1 S S 列 重复 1 p 2 ∑ l = 1 n y . . . l 2 − y . . . 2 N \frac{1}{p^{2}}\sum_{l=1}^{n} y_{...l}^{2} - \frac{y_{...}^{2}}{N} p 2 1 ∑ l = 1 n y ... l 2 − N y ... 2 n − 1 n-1 n − 1 S S 重复 n − 1 \frac{SS_{\text{重复}}}{n-1} n − 1 S S 重复 误差 相减 ( p − 1 ) [ n ( p + 1 ) − 3 ] (p-1)[n(p+1)-3] ( p − 1 ) [ n ( p + 1 ) − 3 ] S S E ( p − 1 ) [ n ( p + 1 ) − 3 ] \frac{SS_{E}}{(p-1)[n(p+1)-3]} ( p − 1 ) [ n ( p + 1 ) − 3 ] S S E 总计 ∑ ∑ ∑ ∑ y i j k l 2 − y . . . 2 N \sum \sum \sum \sum y_{ijkl}^{2} - \frac{y_{...}^{2}}{N} ∑∑∑∑ y ijk l 2 − N y ... 2 n p 2 − 1 np^{2}-1 n p 2 − 1
表 4.15 重复拉丁方的方差分析:情形 2
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 处理 1 n p ∑ j = 1 p y j . . 2 − y . . . 2 N \frac{1}{np}\sum_{j=1}^{p} y_{j..}^{2} - \frac{y_{...}^{2}}{N} n p 1 ∑ j = 1 p y j .. 2 − N y ... 2 p − 1 p-1 p − 1 S S 处理 p − 1 \frac{SS_{\text{处理}}}{p-1} p − 1 S S 处理 M S 处理 M S E \frac{MS_{\text{处理}}}{MS_{E}} M S E M S 处理 行 1 p ∑ l = 1 n ∑ i = 1 p y i . . l 2 − ∑ l = 1 n y . . . l 2 p 2 \frac{1}{p}\sum_{l=1}^{n}\sum_{i=1}^{p} y_{i..l}^{2} - \sum_{l=1}^{n}\frac{y_{...l}^{2}}{p^{2}} p 1 ∑ l = 1 n ∑ i = 1 p y i .. l 2 − ∑ l = 1 n p 2 y ... l 2 n ( p − 1 ) n(p-1) n ( p − 1 ) S S 行 n ( p − 1 ) \frac{SS_{\text{行}}}{n(p-1)} n ( p − 1 ) S S 行 列 1 n p ∑ k = 1 p y . . k 2 − y . . . 2 N \frac{1}{np}\sum_{k=1}^{p} y_{..k}^{2} - \frac{y_{...}^{2}}{N} n p 1 ∑ k = 1 p y .. k 2 − N y ... 2 p − 1 p-1 p − 1 S S 列 p − 1 \frac{SS_{\text{列}}}{p-1} p − 1 S S 列 重复 1 p 2 ∑ l = 1 n y . . . l 2 − y . . . 2 N \frac{1}{p^{2}}\sum_{l=1}^{n} y_{...l}^{2} - \frac{y_{...}^{2}}{N} p 2 1 ∑ l = 1 n y ... l 2 − N y ... 2 n − 1 n-1 n − 1 S S 重复 n − 1 \frac{SS_{\text{重复}}}{n-1} n − 1 S S 重复 误差 相减 ( p − 1 ) ( n p − 1 ) (p-1)(np-1) ( p − 1 ) ( n p − 1 ) S S E ( p − 1 ) ( n p − 1 ) \frac{SS_{E}}{(p-1)(np-1)} ( p − 1 ) ( n p − 1 ) S S E 总计 ∑ i ∑ j ∑ k ∑ l y i j k l 2 − y . . . 2 N \sum_{i}\sum_{j}\sum_{k}\sum_{l} y_{ijkl}^{2} - \frac{y_{...}^{2}}{N} ∑ i ∑ j ∑ k ∑ l y ijk l 2 − N y ... 2 n p 2 − 1 np^{2}-1 n p 2 − 1
表 4.16 重复拉丁方的方差分析:情形 3
变异来源 平方和 自由度 均方 F 0 F_{0} F 0 处理 1 n p ∑ j = 1 p y j . . 2 − y . . . 2 N \frac{1}{np}\sum_{j=1}^{p} y_{j..}^{2} - \frac{y_{...}^{2}}{N} n p 1 ∑ j = 1 p y j .. 2 − N y ... 2 p − 1 p-1 p − 1 S S 处理 p − 1 \frac{SS_{\text{处理}}}{p-1} p − 1 S S 处理 M S 处理 M S E \frac{MS_{\text{处理}}}{MS_{E}} M S E M S 处理 行 1 p ∑ l = 1 n ∑ i = 1 p y i . . l 2 − ∑ l = 1 n y . . . l 2 p 2 \frac{1}{p}\sum_{l=1}^{n}\sum_{i=1}^{p} y_{i..l}^{2} - \sum_{l=1}^{n}\frac{y_{...l}^{2}}{p^{2}} p 1 ∑ l = 1 n ∑ i = 1 p y i .. l 2 − ∑ l = 1 n p 2 y ... l 2 n ( p − 1 ) n(p-1) n ( p − 1 ) S S 行 n ( p − 1 ) \frac{SS_{\text{行}}}{n(p-1)} n ( p − 1 ) S S 行 列 1 p ∑ l = 1 n ∑ k = 1 p y . . k l 2 − ∑ l = 1 n y . . . l 2 p 2 \frac{1}{p}\sum_{l=1}^{n}\sum_{k=1}^{p} y_{..kl}^{2} - \sum_{l=1}^{n}\frac{y_{...l}^{2}}{p^{2}} p 1 ∑ l = 1 n ∑ k = 1 p y .. k l 2 − ∑ l = 1 n p 2 y ... l 2 n ( p − 1 ) n(p-1) n ( p − 1 ) S S 列 n ( p − 1 ) \frac{SS_{\text{列}}}{n(p-1)} n ( p − 1 ) S S 列 重复 1 p 2 ∑ l = 1 n y . . . l 2 − y . . . 2 N \frac{1}{p^{2}}\sum_{l=1}^{n} y_{...l}^{2} - \frac{y_{...}^{2}}{N} p 2 1 ∑ l = 1 n y ... l 2 − N y ... 2 n − 1 n-1 n − 1 S S 重复 n − 1 \frac{SS_{\text{重复}}}{n-1} n − 1 S S 重复 误差 相减 ( p − 1 ) [ n ( p − 1 ) − 1 ] (p-1)[n(p-1)-1] ( p − 1 ) [ n ( p − 1 ) − 1 ] S S E ( p − 1 ) [ n ( p − 1 ) − 1 ] \frac{SS_{E}}{(p-1)[n(p-1)-1]} ( p − 1 ) [ n ( p − 1 ) − 1 ] S S E 总计 ∑ i ∑ j ∑ k ∑ l y i j k l 2 − y . . . 2 N \sum_{i}\sum_{j}\sum_{k}\sum_{l} y_{ijkl}^{2} - \frac{y_{...}^{2}}{N} ∑ i ∑ j ∑ k ∑ l y ijk l 2 − N y ... 2 n p 2 − 1 np^{2}-1 n p 2 − 1
最后考虑情形 3,即每次重复中使用新的原材料批次和新的操作人员。此时行与列产生的变异都度量这些因子在重复之内引起的变异。方差分析汇总于表 4.16。
分析重复拉丁方还有其他一些方法,它们允许处理与方之间存在某些交互作用(参见习题 4.35)。
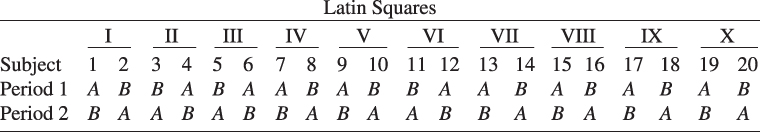
交叉设计与平衡残差效应的设计。有时会遇到把时间段作为试验因子的一个问题。一般地,有 p p p p p p n p np n p 交叉设计 (crossover design)。它可以作为 10 个含两行(时间段)和两个处理(液体类型)的拉丁方来分析,这 10 个方中的两列对应受试者。
该设计的布局见图 4.7。注意拉丁方中的行代表时间段,列代表受试者。先接受液体 A 的 10 名受试者(1、4、6、7、9、12、13、15、17 和 19)是随机确定的。
简化的方差分析汇总于表 4.17。受试者平方和按 20 个受试者总和的校正平方和计算,时间段平方和按各行的校正平方和计算,液体平方和按各字母总和的校正平方和计算。关于这类设计统计分析的更多细节,参见 Cochran and Cox (1957)、John (1971) 以及 Anderson and McLean (1974)。
拉丁方
受试者 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 时期 1 A B B A B A A B A B B A A B A B A B A B 时期 2 B A A B A B B A B A A B B A B A B A B A
图 4.7 一个交叉设计 (原图上方还标出十个拉丁方的编号 I~X,分别对应受试者 1–2、3–4、⋯ \cdots ⋯
表 4.17 图 4.7 中交叉设计的方差分析
变异来源 自由度 受试者(列) 19 时间段(行) 1 液体(字母) 1 误差 18 总计 39