习题 3.34:原料批次中的钙含量
习题与答案 / 第 3 章 单因子试验与方差分析
第 9 版 · 第 3 章 · 原书章末习题见印刷页 125~134。
一家制造商怀疑,供应商提供的不同原料批次在钙含量上有显著差异。仓库中现有大量批次,从中随机抽取 5 批。化学分析员对每批测定 5 次,得到以下数据。
组别/处理条件 观测值(同一行属于同一组) 1 23.46,23.48,23.56,23.39,23.4 2 23.59,23.46,23.42,23.49,23.5 3 23.51,23.64,23.46,23.52,23.49 4 23.28,23.4,23.37,23.46,23.39 5 23.29,23.46,23.37,23.32,23.38
(a) 批次间钙含量是否存在显著变异?取 α = 0.05 \alpha=0.05 α = 0.05
(b) 估计方差分量。
(c) 求 σ τ 2 / ( σ τ 2 + σ 2 ) \sigma_\tau^2/(\sigma_\tau^2+\sigma^2) σ τ 2 / ( σ τ 2 + σ 2 )
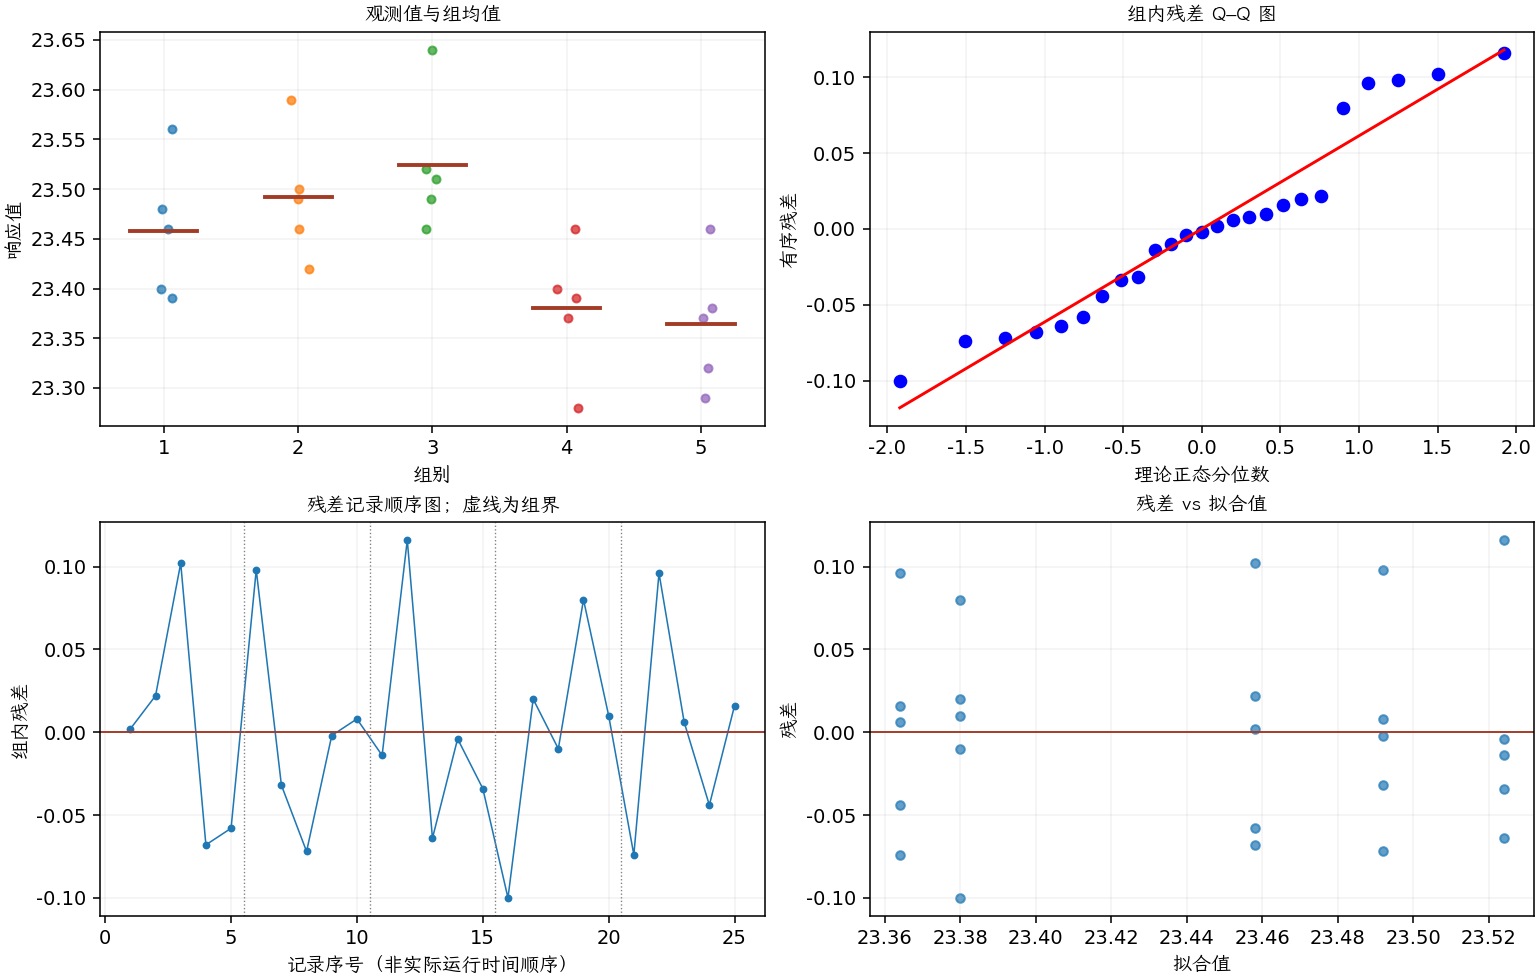
(d) 分析残差。方差分析的各项假定是否满足?
(e) 使用 REML 方法分析这些数据,并将 REML 的误差方差 95% 置信区间与精确卡方区间比较。
答案与解析 ¶ (a)批间方差的检验 ¶ 模型与模型假设(随机效应) :y i j = μ + u i + ϵ i j y_{ij}=\mu+u_i+\epsilon_{ij} y ij = μ + u i + ϵ ij u i ∼ i i d N ( 0 , σ τ 2 ) u_i\overset{\mathrm{iid}}\sim N(0,\sigma_\tau^2) u i ∼ iid N ( 0 , σ τ 2 ) ϵ i j ∼ i i d N ( 0 , σ 2 ) \epsilon_{ij}\overset{\mathrm{iid}}\sim N(0,\sigma^2) ϵ ij ∼ iid N ( 0 , σ 2 ) σ τ 2 \sigma_\tau^2 σ τ 2
原假设和备择假设 :H 0 : σ τ 2 = 0 H_0:\sigma_\tau^2=0 H 0 : σ τ 2 = 0 H 1 : σ τ 2 > 0 H_1:\sigma_\tau^2>0 H 1 : σ τ 2 > 0
平方和公式与检验统计量 :令 N = ∑ i n i N=\sum_i n_i N = ∑ i n i y ˉ i = ∑ j y i j / n i \bar y_i=\sum_jy_{ij}/n_i y ˉ i = ∑ j y ij / n i y ˉ ⋅ ⋅ = ∑ i ∑ j y i j / N \bar y_{\cdot\cdot}=\sum_i\sum_jy_{ij}/N y ˉ ⋅⋅ = ∑ i ∑ j y ij / N
S S A = ∑ i n i ( y ˉ i − y ˉ ⋅ ⋅ ) 2 , S S E = ∑ i ∑ j ( y i j − y ˉ i ) 2 , SS_A=\sum_i n_i(\bar y_i-\bar y_{\cdot\cdot})^2,\qquad SS_E=\sum_i\sum_j(y_{ij}-\bar y_i)^2, S S A = i ∑ n i ( y ˉ i − y ˉ ⋅⋅ ) 2 , S S E = i ∑ j ∑ ( y ij − y ˉ i ) 2 , S S T = ∑ i ∑ j ( y i j − y ˉ ⋅ ⋅ ) 2 = S S A + S S E , SS_T=\sum_i\sum_j(y_{ij}-\bar y_{\cdot\cdot})^2=SS_A+SS_E, S S T = i ∑ j ∑ ( y ij − y ˉ ⋅⋅ ) 2 = S S A + S S E , M S A = S S A a − 1 , M S E = S S E N − a , F 0 = M S A M S E ∼ H 0 F a − 1 , N − a . MS_A=\frac{SS_A}{a-1},\quad MS_E=\frac{SS_E}{N-a},\quad F_0=\frac{MS_A}{MS_E}\overset{H_0}{\sim}F_{a-1,N-a}. M S A = a − 1 S S A , M S E = N − a S S E , F 0 = M S E M S A ∼ H 0 F a − 1 , N − a . 当 F 0 > F 1 − α , a − 1 , N − a F_0>F_{1-\alpha,a-1,N-a} F 0 > F 1 − α , a − 1 , N − a H 0 H_0 H 0 P = P ( F a − 1 , N − a ≥ F 0 ) P=P(F_{a-1,N-a}\ge F_0) P = P ( F a − 1 , N − a ≥ F 0 ) 下侧累积概率分位数 。
方差分量估计量 :σ ^ 2 = M S E \hat\sigma^2=MS_E σ ^ 2 = M S E σ ^ τ 2 = ( M S A − M S E ) / n 0 \hat\sigma_\tau^2=(MS_A-MS_E)/n_0 σ ^ τ 2 = ( M S A − M S E ) / n 0 n 0 = [ N − ∑ i n i 2 / N ] / ( a − 1 ) n_0=[N-\sum_i n_i^2/N]/(a-1) n 0 = [ N − ∑ i n i 2 / N ] / ( a − 1 ) n 0 = n n_0=n n 0 = n s i 2 = ∑ j ( y i j − y ˉ i ) 2 / ( n i − 1 ) s_i^2=\sum_j(y_{ij}-\bar y_i)^2/(n_i-1) s i 2 = ∑ j ( y ij − y ˉ i ) 2 / ( n i − 1 )
来源 自由度 平方和 均方 F F F P P P 处理 4 0.096976 0.024244 5.53516 0.00362615 误差 20 0.0876 0.00438 — — 总计 24 0.184576 — — —
组别 样本量 均值 样本标准差 1 5 23.458 0.0687023 2 5 23.492 0.0630079 3 5 23.524 0.068775 4 5 23.38 0.065192 5 5 23.364 0.0650385
批次是随机抽取的水平;在 0.05 水平拒绝 σ τ 2 = 0 \sigma_\tau^2=0 σ τ 2 = 0
(b)方差分量点估计 ¶ σ ^ τ 2 = ( M S A − M S E ) / n 0 \hat\sigma_\tau^2=(MS_A-MS_E)/n_0 σ ^ τ 2 = ( M S A − M S E ) / n 0 n 0 = [ N − ∑ i n i 2 / N ] / ( a − 1 ) n_0=[N-\sum_i n_i^2/N]/(a-1) n 0 = [ N − ∑ i n i 2 / N ] / ( a − 1 ) n 0 = 5 n_0=5 n 0 = 5 σ ^ τ 2 = 0.0039728 \hat\sigma_\tau^2=0.0039728 σ ^ τ 2 = 0.0039728
σ ^ 2 = M S E = S S E / ( N − a ) \hat\sigma^2=MS_E=SS_E/(N-a) σ ^ 2 = M S E = S S E / ( N − a ) σ ^ 2 = 0.00438 \hat\sigma^2=0.00438 σ ^ 2 = 0.00438
(c)组内相关系数的区间 ¶ 令 r = M S A / M S E r=MS_A/MS_E r = M S A / M S E θ = σ τ 2 / σ 2 \theta=\sigma_\tau^2/\sigma^2 θ = σ τ 2 / σ 2 r / ( 1 + n θ ) ∼ F a − 1 , N − a r/(1+n\theta)\sim F_{a-1,N-a} r / ( 1 + n θ ) ∼ F a − 1 , N − a L = ( r / F 0.975 , a − 1 , N − a − 1 ) / n L=(r/F_{0.975,a-1,N-a}-1)/n L = ( r / F 0.975 , a − 1 , N − a − 1 ) / n U = ( r / F 0.025 , a − 1 , N − a − 1 ) / n U=(r/F_{0.025,a-1,N-a}-1)/n U = ( r / F 0.025 , a − 1 , N − a − 1 ) / n ρ = θ / ( 1 + θ ) \rho=\theta/(1+\theta) ρ = θ / ( 1 + θ )
C I 0.95 ( ρ ) = ( 0.103117 , 0.902687 ) CI_{0.95}(\rho)=(0.103117, 0.902687) C I 0.95 ( ρ ) = ( 0.103117 , 0.902687 ) (d)残差分析 ¶ 残差定义 :y ^ i j = y ˉ i \hat y_{ij}=\bar y_i y ^ ij = y ˉ i e i j = y i j − y ˉ i e_{ij}=y_{ij}-\bar y_i e ij = y ij − y ˉ i
三项诊断 :Q–Q 图用于检查尾部、偏态及异常残差;残差记录顺序图用于展示原表记录的相邻变化;残差 vs 拟合值图用于观察方差是否随处理均值变化。
时序资料的限制 :原题只提供分组观测,没有实际运行时间和随机运行次序。左下图按原表组内记录顺序排列,虚线表示组界,不是实际残差时序图 ;组界附近的变化不能解释为时间效应。若要完成真正的时序诊断,须取得原始运行顺序后按该顺序重画。当前不能仅凭此图断言误差在时间上独立。单样本或配对差的拟合值为常数时,残差 vs 拟合值图也不能检验复杂均值结构。
采用组内残差检查条件误差,未见严重异常;不能把同批观测的边际相关性误认为独立误差假定成立。是否独立取样及真实测定时间,仍须查阅实际记录。
(e)REML 与误差方差区间比较 ¶ 平衡设计且方差分量为正时,REML 点估计与上述 ANOVA 矩估计相同。作为明确的近似比较,误差方差的正态 Wald 区间为 σ ^ 2 ± 1.959964 σ ^ 2 2 / ( N − a ) \hat\sigma^2\pm1.959964\hat\sigma^2\sqrt{2/(N-a)} σ ^ 2 ± 1.959964 σ ^ 2 2/ ( N − a ) ( 0.0016653 , 0.0070947 ) (0.0016653, 0.0070947) ( 0.0016653 , 0.0070947 )
C I 0.95 ( σ 2 ) = [ ( N − a ) M S E / χ 0.975 , N − a 2 , ( N − a ) M S E / χ 0.025 , N − a 2 ] CI_{0.95}(\sigma^2)=[(N-a)MS_E/\chi^2_{0.975,N-a},(N-a)MS_E/\chi^2_{0.025,N-a}] C I 0.95 ( σ 2 ) = [( N − a ) M S E / χ 0.975 , N − a 2 , ( N − a ) M S E / χ 0.025 , N − a 2 ] ( 0.00256368 , 0.00913377 ) (0.00256368,0.00913377) ( 0.00256368 , 0.00913377 )
这里明确采用 REML 的渐近 Wald 区间作比较,不冒充某软件的轮廓似然结果。小样本下优先报告模型成立时的精确卡方区间。
答案来源 :参考答案文件无直接对应题;解析由编者补充。
← 上一题 3.33 · 本章题目目录 · 下一题 3.35 →