15.1 非正态响应与变换
15.1.1 选择变换:Box–Cox 方法
第 3.4.3 节讨论了试验响应 的方差不恒定问题,指出这违背通常方差分析的假定。实践中方差不齐很常见,且常伴随非正态响应。例如,缺陷数或粒子数,产率或不合格品率等比例数据,以及服从偏态分布的响应(一侧尾部比另一侧长)。我们介绍了通过变换响应来稳定方差,并讨论两种选择变换形式的方法:经验图解法,以及尝试一种或多种变换、选择能产生最满意的残差对拟合响应图的试探法。
变换通常有三个目的:稳定响应方差,使响应分布更接近正态,以及改善模型拟合。最后一个目的还可能包括简化模型,例如消除交互作用项。有时一种变换能同时有效实现其中多个目的。
幂变换族 很有用,其中 是待确定的变换参数;例如 表示对原响应开平方。Box 和 Cox(1964)说明,可将 与其他模型参数(总体均值和处理效应)同时估计,其理论基于极大似然法。实际计算是在不同 下,对下列变换值进行标准方差分析:
其中, 是观测值的几何平均数。使误差平方和 最小的 就是极大似然估计。通常绘制 对 的图,从图中读出最小点。一般取 10~20 个 值即可估计最优值;若需要更准确,可在其附近采用更密的网格进一步搜索。
不能直接比较对 作方差分析的误差平方和来选择 ,因为不同 对应不同尺度。另外, 时 ,在 时响应全为常数。式(15.1)中的 解决了这一问题,其极限为 。分母中的 调整响应尺度,使不同变换的误差平方和可直接比较。
使用 Box–Cox 方法时,建议选择简单的 值。例如 0.5 与 0.58 的实际差别可能很小,但平方根变换()更易解释。接近 1 的 则表明可能无需变换。
选定 后,可用 分析数据;若 ,用 。也可以直接以 作响应,但与 或 的结果相比,模型参数估计会有尺度和原点的变化。
的近似 置信区间可按下式构造:
其中, 是误差自由度。在 对 的图上,于高度 画平行于横轴的直线。它与曲线交点对应的 就是置信限。若区间包含 ,则数据没有充分证据支持必须作变换。
例 15.1
用例 3.5 的峰值流量数据说明 Box–Cox 方法。这是单因子试验,原数据见表 3.7。按式(15.1)对若干 计算 :
| $\lambda$ | $\mathrm{SS}_{\mathrm{E}}(\lambda)$ |
| -1.00 | 7922.11 |
| -0.50 | 687.10 |
| -0.25 | 232.52 |
| 0.00 | 91.96 |
| 0.25 | 46.99 |
| 0.50 | 35.42 |
| 0.75 | 40.61 |
| 1.00 | 62.08 |
| 1.25 | 109.82 |
| 1.50 | 208.12 |
最小值附近的图见图 15.1。 时, 约为 35.00。按式(15.2)计算近似 95% 置信区间的界线:
将 画在图 15.1 上,读出它与曲线交点对应的 ,得到下限 、上限 。区间不包含 1,表明需要变换;实际采用的平方根变换()有充分依据。
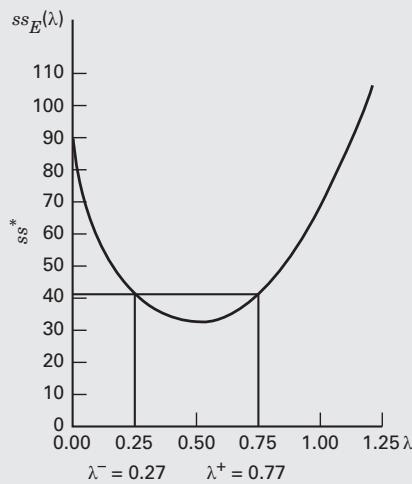
图 15.1 例 15.1 的 对 图
Design-Expert 图:峰值流量
当前 ;最佳值 0.541377;置信下限 0.291092,上限 0.791662;建议使用平方根变换()。
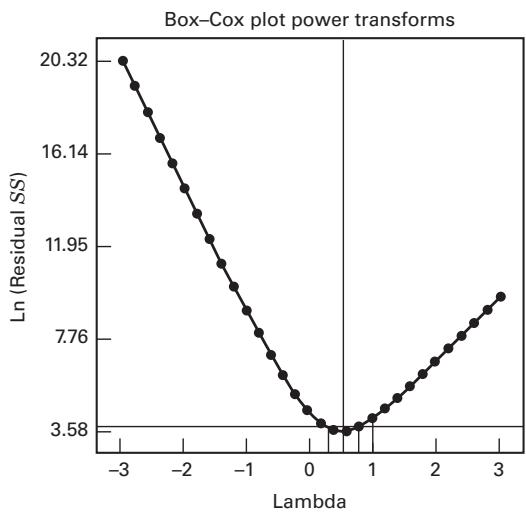
图 15.2 Design-Expert 的 Box–Cox 方法输出
一些软件包含用于选择幂变换的 Box–Cox 程序。图 15.2 给出了 Design-Expert 对峰值流量数据的输出,结果与例 15.1 的手算较接近。图中的纵轴为 。
15.1.2 广义线性模型
数据变换常能有效处理非正态响应及伴随的方差不齐。上一节的 Box–Cox 方法简单而有效,但数据变换也存在一些问题。
首先,试验者可能不习惯在变换尺度上解释响应。他们关注的是缺陷数而非缺陷数的平方根,或电阻率而非其对数。不过,若变换确实改善了分析和响应模型,试验者通常很快就会接受新尺度。
更严重的是,变换模型可能在所关注设计区域的某些部分给出没有实际意义的响应。例如,对硅片缺陷数使用平方根变换后,在某些区域预测的缺陷数平方根为负,尤其容易发生在实际缺陷数较小的区域。这样,模型偏偏在我们希望预测良好的区域给出明显不可靠的结果。
最后,变换常被用来稳定方差、改善正态性和简化模型,但无法保证同一种变换同时有效实现全部目标。
除“先变换、再对变换响应作通常最小二乘分析”外,还可采用广义线性模型(GLM)。Nelder 和 Wedderburn(1972)提出这一方法,将正态和非正态响应的相关模型纳入统一框架。完整讨论见 McCullagh 和 Nelder(1989)以及 Myers 等(2010);Myers 和 Montgomery(1997)提供了教程。本章补充材料还有更多细节。下面概述概念并用三个简短例子说明。
广义线性模型本质上是回归模型,试验设计模型也属于回归模型。它包含随机分量,以及设计因子 和未知参数 的函数。通常基于正态理论的线性回归模型写为
假定误差 均值为零、方差恒定且服从正态分布,响应均值为
式(15.4)中的 称为线性预测子。广义线性模型包含式(15.3)这一特例。
GLM 的响应可服从指数族中的任一分布,包括正态、Poisson、二项、指数和 gamma 分布。这是一组丰富而灵活、适用于许多试验场景的分布。响应均值 与线性预测子之间的关系由链接函数确定。
表示平均响应的回归模型为
例如,产生式(15.3)普通线性回归模型的函数称为恒等链接,因为 。又如,对数链接
产生模型
对数链接常用于计数数据(Poisson 响应),以及具有较长右尾的连续响应(指数或 gamma 分布)。用于二项数据的另一种重要函数是 logit 链接:
它产生模型
链接函数有多种选择,但必须单调且可微。GLM 的响应方差不必恒定,可以是均值的函数,并通过链接函数依赖于预测变量。例如,Poisson 响应的方差恰等于均值。
实际使用 GLM 时,须指定响应分布与链接函数,再用极大似然法拟合模型或估计参数。对指数族,这通常通过迭代加权最小二乘实现。正态响应的普通线性回归或试验设计模型退化为标准最小二乘。可采用类似正态理论方差分析的方式进行推断与诊断,详见 Myers 和 Montgomery(1997)及 Myers 等(2010)。SAS 的 PROC GENMOD 和 JMP 都支持广义线性模型。
例 15.2
某消费品公司研究影响顾客兑现个人护理产品优惠券可能性的因子。进行 23 析因试验,A 为优惠券面额(低、高),B 为有效期,C 为使用难易程度(容易、困难)。八个单元各随机选取 1000 名顾客,响应为兑现优惠券的人数,结果见表 15.1。
表 15.1
优惠券兑现试验的设计与数据
| A | B | C | 优惠券兑现人数 |
| - | - | - | 200 |
| + | - | - | 250 |
| - | + | - | 265 |
| + | + | - | 347 |
| - | - | + | 210 |
| + | - | + | 286 |
| - | + | + | 271 |
| + | + | + | 326 |
各单元响应可看作 1000 次 Bernoulli 试验中的成功次数,因此合理的模型是具有二项响应分布和 logit 链接的 GLM。这一形式通常称为 Logistic 回归。
Minitab 和 JMP 均可拟合 Logistic 回归。试验者决定只包含主效应和两因子交互作用,预期响应模型为
表 15.2 给出了部分 Minitab 输出。上部拟合含三个主效应和三个两因子交互作用的完整模型,并列出系数估计及标准误。在系数等于零的原假设下, 渐近服从标准正态分布,可检验各主效应和交互作用。“渐近”指样本量足够大时。这里仅有八个不同设计点,但各点包含 1000 次二项试验;判断近似是否适用还应考虑成功和失败次数及模型条件。[1] 表中 P 值表明,截距及 A、B 主效应显著;BC 的 P 值为 0.107,在 5% 水平下不显著。[2]
拟合优度部分给出 Pearson、离差和 Hosmer–Lemeshow 三种统计量,衡量模型的整体适合程度。P 值均较大,未发现模型明显不适合的证据。表下部给出只含三个主效应和 BC 的简化模型;为保持模型层级,保留 C。拟合模型为
C 和 BC 均未达到 5% 显著性水平;是否保留 BC,还应结合模型层级、拟合优度和预测目的判断。
Minitab 为每个回归系数报告一个优势比(odds ratio),它直接来自式(15.9)的 logit 链接,其解释类似于标准二水平设计中的因子效应。
表 15.2
优惠券兑现试验的 Minitab 输出
| 二元 Logistic 回归:完整模型 | |||||||
| 链接函数:Logit | |||||||
| 响应信息 | |||||||
| 变量 | 值 | 计数 | |||||
| C5 | 成功 | 2155 | |||||
| 失败 | 5845 | ||||||
| C6 | 总计 | 8000 | |||||
| Logistic 回归表 | |||||||
| 预测变量 | 系数 | 系数标准误 | Z | P 值 | 优势比 | 95% 下限 | 置信上限 |
| 常数项 | -1.01154 | 0.0255150 | -39.65 | 0.000 | |||
| A | 0.169208 | 0.0255092 | 6.63 | 0.000 | 1.18 | 1.13 | 1.25 |
| B | 0.169622 | 0.0255150 | 6.65 | 0.000 | 1.18 | 1.13 | 1.25 |
| C | 0.0233173 | 0.0255099 | 0.91 | 0.361 | 1.02 | 0.97 | 1.08 |
| A*B | -0.0062854 | 0.0255122 | -0.25 | 0.805 | 0.99 | 0.95 | 1.04 |
| A*C | -0.0027726 | 0.0254324 | -0.11 | 0.913 | 1.00 | 0.95 | 1.05 |
| B*C | -0.0410198 | 0.0254339 | -1.61 | 0.107 | 0.96 | 0.91 | 1.01 |
| 对数似然 = -4615.310 | |||||||
| 拟合优度检验 | |||||||
| 方法 | 卡方统计量 | 自由度 | P 值 | ||||
| Pearson | 1.46458 | 1 | 0.226 | ||||
| 离差 | 1.46451 | 1 | 0.226 | ||||
| Hosmer-Lemeshow | 1.46458 | 6 | 0.962 | ||||
表 15.2 的下部为含 A、B、C、BC 的简化二元 Logistic 回归。对 A, 表示编码变量增加一个单位的优势比,即面额从 到 的变化。高水平 +1 相对低水平 -1 的优势比则为 ,因此高面额使兑现的优势约增加 40%。
Link Function: Logit
Response Information
Variable Value Count
C5 Success 2155
Failure 5845
C6 Total 8000
Logistic Regression Table
Predictor Coef SE Coef Z P Odds 95% CI
Constant -1.01142 0.0255076 -39.65 0.000 Ratio Lower Upper
A 0.168675 0.0254235 6.63 0.000 1.18 1.13 1.24
B 0.169116 0.0254321 6.65 0.000 1.18 1.13 1.24
C 0.0230825 0.0254306 0.91 0.364 1.02 0.97 1.08
B*C -0.0409711 0.0254307 -1.61 0.107 0.96 0.91 1.01
Log-Likelihood = -4615.346
Goodness-of-Fit Tests
Method Chi-Square DF P
Pearson 1.53593 3 0.674
Deviance 1.53602 3 0.674
Hosmer-Lemeshow 1.53593 6 0.957
Logistic 回归应用广泛,可能是最常见的 GLM 应用。生物医学中的剂量与反应研究经常使用它,其中因子为治疗剂量,响应为治疗是否成功。可靠性工程试验也常有成功或失败的二元数据,例如产品或元件承受某种应力后是否失效。
例 15.3 格栅缺陷试验
习题 8.29 介绍了研究九个因子对片状模塑格栅开口面板缺陷影响的试验。Bisgaard 和 Fuller(1994)用这些数据说明变换在试验分析中的价值。该习题(f)中采用修正的平方根变换,得到模型
其中, 为编码设计因子。该变换很好地稳定了缺陷数的方差。表 15.3 前两个部分给出模型信息:“变换后”部分第一列为预测响应,其中有两个负值;“原尺度”部分给出反变换后的预测及 16 个设计点平均响应的 95% 置信区间。由于一些预测值和置信下限为负,部分条目无法作有效反变换。
响应本质上是缺陷数的平方根,负预测显然没有意义,而这些预测出现在观测计数较小的区域。若需在此区域预测,模型可能不可靠。这不是对原试验或 Bisgaard、Fuller 分析的否定:该筛选试验非常成功,清楚识别了重要过程变量;预测既不是原试验的目标,也不是那次分析的目标。
若目标包括预测,GLM 很可能比变换方法更合适。Myers 和 Montgomery 采用式(15.7)的对数链接和 Poisson 响应,拟合与 Bisgaard、Fuller 完全相同的线性预测子,得到
表 15.3 第三部分给出各设计点的预测及平均响应 95% 置信区间,由 SAS PROC GENMOD 计算;JMP 也能拟合 Poisson 回归。链接函数保证预测非负,置信下限也没有负值。最后一部分比较原尺度最小二乘模型与 GLM 的区间长度,GLM 的区间均更短。在所采用分布假定适用时,这表明 GLM 在本例中提供了更精确的平均响应估计。
表 15.3
格栅开口面板试验的最小二乘与广义线性模型分析
| 观测值 | 采用 Freeman–Tukey 修正平方根变换的最小二乘法 | 广义线性模型(Poisson 响应、对数链接) | 95% 置信区间长度 | |||||
| 变换后 | 原尺度 | |||||||
| 预测值 | 95% 置信区间 | 预测值 | 95% 置信区间 | 预测值 | 95% 置信区间 | 最小二乘 | GLM | |
| 1 | 5.50 | (4.14, 6.85) | 29.70 | (16.65, 46.41) | 51.26 | (42.45, 61.90) | 29.76 | 19.45 |
| 2 | 3.95 | (2.60, 5.31) | 15.12 | (6.25, 27.65) | 11.74 | (8.14, 16.94) | 21.39 | 8.80 |
| 3 | 1.52 | (0.17, 2.88) | 1.84 | (1.69, 7.78) | 1.12 | (0.60, 2.08) | 6.09 | 1.47 |
| 4 | 3.07 | (1.71, 4.42) | 8.91 | (2.45, 19.04) | 4.88 | (2.87, 8.32) | 16.59 | 5.45 |
| 5 | 1.52 | (0.17, 2.88) | 1.84 | (1.69, 7.78) | 1.12 | (0.60, 2.08) | 6.09 | 1.47 |
| 6 | 3.07 | (1.71, 4.42) | 8.91 | (2.45, 19.04) | 4.88 | (2.87, 8.32) | 16.59 | 5.45 |
| 7 | 5.50 | (4.14, 6.85) | 29.70 | (16.65, 46.41) | 51.26 | (42.45, 61.90) | 29.76 | 19.45 |
| 8 | 3.95 | (2.60, 5.31) | 15.12 | (6.25, 27.65) | 11.74 | (8.14, 16.94) | 21.39 | 8.80 |
| 9 | 1.08 | (-0.28, 2.43) | 0.71 | (*, 5.41) | 0.81 | (0.42, 1.56) | * | 1.13 |
| 10 | -0.47 | (-1.82, 0.89) | * | (*, 0.36) | 0.19 | (0.09, 0.38) | * | 0.29 |
| 11 | 1.96 | (0.61, 3.31) | 3.36 | (0.04, 10.49) | 1.96 | (1.16, 3.30) | 10.45 | 2.14 |
| 12 | 3.50 | (2.15, 4.86) | 11.78 | (4.13, 23.10) | 8.54 | (5.62, 12.98) | 18.96 | 7.35 |
| 13 | 1.96 | (0.61, 3.31) | 3.36 | (0.04, 10.49) | 1.96 | (1.16, 3.30) | 10.45 | 2.14 |
| 14 | 3.50 | (2.15, 4.86) | 11.78 | (4.13, 23.10) | 8.54 | (5.62, 12.98) | 18.97 | 7.35 |
| 15 | 1.08 | (-0.28, 2.43) | 0.71 | (*, 5.41) | 0.81 | (0.42, 1.56) | * | 1.13 |
| 16 | -0.47 | (-1.82, 0.89) | * | (*, 0.36) | 0.19 | (0.09, 0.38) | * | 0.29 |
例 15.4 精纺毛纱试验
表 15.4 给出一个 33 析因设计,研究精纺毛纱在重复加载下的性能,详见 Box 和 Draper(2007)。响应为失效前经历的循环数。这类可靠性数据通常为非负值,并常呈较长右尾;这里将较大的循环计数按连续响应近似处理。
最初采用标准最小二乘分析,需要变换来稳定方差。对循环数取自然对数后,模型拟合与残差图均较满意,得到
以原响应,即失效循环数表示为
表 15.4
精纺毛纱试验的设计、失效循环数及自然对数
| 试验 | $x_{1}$ | $x_{2}$ | $x_{3}$ | 失效前循环数 | 失效前循环数的自然对数 |
| 1 | -1 | -1 | -1 | 674 | 6.51 |
| 2 | -1 | -1 | 0 | 370 | 5.91 |
| 3 | -1 | -1 | 1 | 292 | 5.68 |
| 4 | -1 | 0 | -1 | 338 | 5.82 |
| 5 | -1 | 0 | 0 | 266 | 5.58 |
| 6 | -1 | 0 | 1 | 210 | 5.35 |
| 7 | -1 | 1 | -1 | 170 | 5.14 |
| 8 | -1 | 1 | 0 | 118 | 4.77 |
| 9 | -1 | 1 | 1 | 90 | 4.50 |
| 10 | 0 | -1 | -1 | 1414 | 7.25 |
| 11 | 0 | -1 | 0 | 1198 | 7.09 |
| 12 | 0 | -1 | 1 | 634 | 6.45 |
| 13 | 0 | 0 | -1 | 1022 | 6.93 |
| 14 | 0 | 0 | 0 | 620 | 6.43 |
| 15 | 0 | 0 | 1 | 438 | 6.08 |
| 16 | 0 | 1 | -1 | 442 | 6.09 |
| 17 | 0 | 1 | 0 | 332 | 5.81 |
| 18 | 0 | 1 | 1 | 220 | 5.39 |
| 19 | 1 | -1 | -1 | 3636 | 8.20 |
| 20 | 1 | -1 | 0 | 3184 | 8.07 |
| 21 | 1 | -1 | 1 | 2000 | 7.60 |
| 22 | 1 | 0 | -1 | 1568 | 7.36 |
| 23 | 1 | 0 | 0 | 1070 | 6.98 |
| 24 | 1 | 0 | 1 | 566 | 6.34 |
| 25 | 1 | 1 | -1 | 1140 | 7.04 |
| 26 | 1 | 1 | 0 | 884 | 6.78 |
| 27 | 1 | 1 | 1 | 360 | 5.89 |
还可以选择 gamma 响应分布和对数链接进行 GLM 分析,采用与对数变换后最小二乘相同的模型项,得到
表 15.5 给出两种模型在 27 个设计点的预测和平均响应 95% 置信区间。区间长度比较表明,GLM 可能比最小二乘模型提供更精确的预测。
表 15.5 精纺毛纱试验的最小二乘与广义线性模型分析
| 观测序号 | 对数变换后的最小二乘法 | 广义线性模型 | 95% 置信区间长度 | |||||
| 变换后 | 原尺度 | |||||||
| 预测值 | 95% 置信区间 | 预测值 | 95% 置信区间 | 预测值 | 95% 置信区间 | 最小二乘 | GLM | |
| 1 | 2.83 | (2.76, 2.91) | 682.50 | (573.85, 811.52) | 680.52 | (583.83, 793.22) | 237.67 | 209.39 |
| 2 | 2.66 | (2.60, 2.73) | 460.26 | (397.01, 533.46) | 463.00 | (407.05, 526.64) | 136.45 | 119.59 |
| 3 | 2.49 | (2.42, 2.57) | 310.38 | (260.98, 369.06) | 315.01 | (271.49, 365.49) | 108.09 | 94.00 |
| 4 | 2.56 | (2.50, 2.62) | 363.25 | (313.33, 421.11) | 361.96 | (317.75, 412.33) | 107.79 | 94.58 |
| 5 | 2.39 | (2.34, 2.44) | 244.96 | (217.92, 275.30) | 246.26 | (222.55, 272.51) | 57.37 | 49.96 |
| 6 | 2.22 | (2.15, 2.28) | 165.20 | (142.50, 191.47) | 167.55 | (147.67, 190.10) | 48.97 | 42.42 |
| 7 | 2.29 | (2.21, 2.36) | 193.33 | (162.55, 229.93) | 192.52 | (165.69, 223.70) | 67.38 | 58.01 |
| 8 | 2.12 | (2.05, 2.18) | 130.38 | (112.46, 151.15) | 130.98 | (115.43, 148.64) | 38.69 | 33.22 |
表 15.5(续)
| 观测序号 | 对数变换后的最小二乘法 | 广义线性模型 | 95% 置信区间长度 | |||||
| 变换后 | 原尺度 | |||||||
| 预测值 | 95% 置信区间 | 预测值 | 95% 置信区间 | 预测值 | 95% 置信区间 | 最小二乘 | GLM | |
| 9 | 1.94 | (1.87, 2.02) | 87.92 | (73.93, 104.54) | 89.12 | (76.87, 103.32) | 30.62 | 26.45 |
| 10 | 3.20 | (3.13, 3.26) | 1569.28 | (1353.94, 1819.28) | 1580.00 | (1390.00, 1797.00) | 465.34 | 407.00 |
| 11 | 3.02 | (2.97, 3.08) | 1058.28 | (941.67, 1189.60) | 1075.00 | (972.52, 1189.00) | 247.92 | 216.48 |
| 12 | 2.85 | (2.79, 2.92) | 713.67 | (615.60, 827.37) | 731.50 | (644.35, 830.44) | 211.77 | 186.09 |
| 13 | 2.92 | (2.87, 2.97) | 835.41 | (743.19, 938.86) | 840.54 | (759.65, 930.04) | 195.67 | 170.39 |
| 14 | 2.75 | (2.72, 2.78) | 563.25 | (523.24, 606.46) | 571.87 | (536.67, 609.38) | 83.22 | 72.70 |
| 15 | 2.58 | (2.53, 2.63) | 379.84 | (337.99, 426.97) | 389.08 | (351.64, 430.51) | 88.99 | 78.87 |
| 16 | 2.65 | (2.58, 2.71) | 444.63 | (383.53, 515.35) | 447.07 | (393.81, 507.54) | 131.82 | 113.74 |
| 17 | 2.48 | (2.43, 2.53) | 299.85 | (266.75, 336.98) | 304.17 | (275.13, 336.28) | 70.23 | 61.15 |
| 18 | 2.31 | (2.24, 2.37) | 202.16 | (174.42, 234.37) | 206.95 | (182.03, 235.27) | 59.95 | 53.23 |
| 19 | 3.56 | (3.48, 3.63) | 3609.11 | (3034.59, 4292.40) | 3670.00 | (3165.00, 4254.00) | 1257.81 | 1089.00 |
| 20 | 3.39 | (3.32, 3.45) | 2433.88 | (2099.42, 2821.63) | 2497.00 | (2200.00, 2833.00) | 722.21 | 633.00 |
| 21 | 3.22 | (3.14, 3.29) | 1641.35 | (1380.07, 1951.64) | 1699.00 | (1462.00, 1974.00) | 571.57 | 512.00 |
| 22 | 3.28 | (3.22, 3.35) | 1920.88 | (1656.91, 2226.90) | 1952.00 | (1720.00, 2215.00) | 569.98 | 495.00 |
| 23 | 3.11 | (3.06, 3.16) | 1295.39 | (1152.66, 1455.79) | 1328.00 | (1200.00, 1470.00) | 303.14 | 270.00 |
| 24 | 2.94 | (2.88, 3.01) | 873.57 | (753.53, 1012.74) | 903.51 | (793.15, 1029.00) | 259.22 | 235.85 |
| 25 | 3.01 | (2.93, 3.08) | 1022.35 | (859.81, 1215.91) | 1038.00 | (894.79, 1205.00) | 356.10 | 310.21 |
| 26 | 2.84 | (2.77, 2.90) | 689.45 | (594.70, 799.28) | 706.34 | (620.99, 803.43) | 204.58 | 182.44 |
| 27 | 2.67 | (2.59, 2.74) | 464.94 | (390.93, 552.97) | 480.57 | (412.29, 560.15) | 162.04 | 147.86 |
GLM 已广泛用于生物医学与制药研发。随着软件支持增加,也将更多用于工业研发。本节用标准试验设计结合指数族响应分布。若预先知道需要 GLM 分析,可在设计时考虑这一点。GLM 的最优设计属于非线性模型最优设计的一种,更多讨论与例子见 Johnson 和 Montgomery(2009,2010)。