10.3 线性回归模型参数的估计
通常用最小二乘法估计多元线性回归模型的系数。设有 n>k 个响应观测值 y1,…,yn,每个 yi 都伴随各回归变量的一次观测;用 xij 表示第 i 次观测时变量 xj 的水平。数据形式见表 10.1。假定误差项满足 E(ϵ)=0、V(ϵ)=σ2,且各 ϵi 互不相关。
表 10.1 多元线性回归的数据形式
| $y$ | $x_{1}$ | $x_{2}$ | $\cdots$ | $x_{k}$ |
| $y_{1}$ | $x_{11}$ | $x_{12}$ | $\cdots$ | $x_{1k}$ |
| $y_{2}$ | $x_{21}$ | $x_{22}$ | $\cdots$ | $x_{2k}$ |
| $\vdots$ | $\vdots$ | $\vdots$ | | $\vdots$ |
| $y_{n}$ | $x_{n1}$ | $x_{n2}$ | $\cdots$ | $x_{nk}$ |
根据表 10.1,式(10.2)可写为
yi=β0+β1xi1+⋯+βkxik+ϵi=β0+j=1∑kβjxij+ϵi,i=1,…,n.(10.7) 最小二乘法选择使误差平方和最小的系数。其目标函数为
L=i=1∑nϵi2=i=1∑n(yi−β0−j=1∑kβjxij)2.(10.8) 对 β0,…,βk 求极小值,所得估计量 β^0,…,β^k 应满足
−2i=1∑n(yi−β^0−j=1∑kβ^jxij)=0,(10.9a) 以及
−2i=1∑n(yi−β^0−ℓ=1∑kβ^ℓxiℓ)xij=0,j=1,…,k.(10.9b) 化简后得到 p=k+1 个最小二乘正规方程,每个未知回归系数对应一个方程:
nβ^0+j=1∑kβ^ji=1∑nxijβ^0i=1∑nxij+ℓ=1∑kβ^ℓi=1∑nxijxiℓ=i=1∑nyi,=i=1∑nxijyi,j=1,…,k.(10.10) 解这些方程便得到各回归系数的最小二乘估计。用矩阵形式表达会更简洁。令
y=⎣⎡y1y2⋮yn⎦⎤,X=⎣⎡11⋮1x11x21⋮xn1⋯⋯⋯x1kx2k⋮xnk⎦⎤,β=⎣⎡β0β1⋮βk⎦⎤,ϵ=⎣⎡ϵ1ϵ2⋮ϵn⎦⎤. 则模型为 y=Xβ+ϵ。其中 y、ϵ 为 n×1 向量,X 为 n×p 矩阵,β 为 p×1 向量。最小二乘法求使下式最小的 β^:
L=ϵ′ϵ=(y−Xβ)′(y−Xβ). 展开得到
L=y′y−2β′X′y+β′X′Xβ.(10.11) 这里利用了 β′X′y 是标量,等于其转置 y′Xβ。对 β 求导并令其为零,有
−2X′y+2X′Xβ^=0, 即矩阵形式的正规方程
X′Xβ^=X′y.(10.12) 在 X′X 可逆时,两边左乘其逆矩阵,得到[1]
β^=(X′X)−1X′y.(10.13) 将式(10.12)的矩阵乘法展开,正好得到式(10.10)的标量方程。X′X 是 p×p 对称矩阵,X′y 是 p×1 列向量。前者的对角元素是 X 各列元素的平方和,非对角元素是相应两列元素的交叉乘积和;后者各元素是 X 相应列与观测值 yi 的交叉乘积和。
拟合值向量为
y^=Xβ^,(10.14) 即 y^i=β^0+∑j=1kβ^jxij。实际观测值与拟合值之差称为残差,ei=yi−y^i,残差向量为
e=y−y^.(10.15) 估计 σ2
通常还需要估计误差方差 σ2。残差平方和为
SSE=i=1∑n(yi−y^i)2=i=1∑nei2=e′e. 代入 e=y−Xβ^ 并展开,再利用正规方程 X′Xβ^=X′y,得到
SSE=y′y−β^′X′y.(10.16) 这个误差平方和对应 n−p 个自由度。可以证明 E(SSE)=σ2(n−p),因此 σ2 的无偏估计为
σ^2=n−pSSE.(10.17) 估计量的性质
最小二乘法得到的 β^ 是 β 的无偏估计。由 E(ϵ)=0 与 (X′X)−1X′X=I 可知
E(β^)=E[(X′X)−1X′(Xβ+ϵ)]=β. 估计量的方差性质由协方差矩阵给出:
Cov(β^)=E[(β^−Eβ^)(β^−Eβ^)′].(10.18) 这是一个对称矩阵,其第 i 个对角元素为 β^i 的方差,第 (i,j) 个元素为 β^i 与 β^j 的协方差。具体地,
Cov(β^)=σ2(X′X)−1.(10.19) 用式(10.17)的 σ^2 代替 σ2[2],即可估计协方差矩阵;其对角元素的平方根就是各模型参数的标准误。
例 10.1
表 10.2 给出了聚合物黏度 y 与两个过程变量——反应温度 x1、催化剂进料速率 x2——的 16 组观测。拟合模型
y=β0+β1x1+β2x2+ϵ. 表 10.2 例 10.1 的黏度数据(黏度单位:100 °C 时的厘斯托克斯)
| 观测序号 | 温度 ( $x_1$ , °C) | 催化剂进料速率 ( $x_2$ , lb/h) | 黏度 |
| 1 | 80 | 8 | 2256 |
| 2 | 93 | 9 | 2340 |
| 3 | 100 | 10 | 2426 |
| 4 | 82 | 12 | 2293 |
| 5 | 90 | 11 | 2330 |
| 6 | 99 | 8 | 2368 |
| 7 | 81 | 8 | 2250 |
| 8 | 96 | 10 | 2409 |
| 9 | 94 | 12 | 2364 |
| 10 | 93 | 11 | 2379 |
| 11 | 97 | 13 | 2440 |
| 12 | 95 | 11 | 2364 |
| 13 | 100 | 8 | 2404 |
| 14 | 85 | 12 | 2317 |
| 15 | 86 | 9 | 2309 |
| 16 | 87 | 12 | 2328 |
由表中数据构造 X 与 y,计算得到
X′X=⎣⎡161458164145813356014946164149461726⎦⎤,X′y=⎣⎡375773429550385562⎦⎤. 进一步由式(10.13)求得[3]
(X′X)−1≈⎣⎡14.176004−0.1297461−0.2234529−0.12974610.001429184−0.0000476395−0.2234529−0.00004763950.02222381⎦⎤,β^≈⎣⎡1566.077777.621298.58485⎦⎤. 系数保留两位小数,拟合式为
y^=1566.08+7.62x1+8.58x2. 表 10.3 前三列给出实际响应 yi、拟合值 y^i 和残差。图 10.1 是残差的正态概率图;图 10.2、10.3、10.4 分别是残差对拟合黏度、温度 x1 和进料速率 x2 的散点图。与分析设计试验一样,检查残差图是建立回归模型不可缺少的一步。这些图提示,观测黏度越大,其方差也趋于增大;图 10.3 进一步提示,黏度的波动随温度升高而增大。
表 10.3 例 10.1 的拟合值、残差及其他诊断量[4]
| 观测序号 i | $y_i$ | 拟合值 $\hat{y}_i$ | 残差 $e_i$ | $h_{ii}$ | 学生化残差 | $D_i$ | R-student |
| 1 | 2256 | 2244.5 | 11.5 | 0.350 | 0.87 | 0.137 | 0.87 |
| 2 | 2340 | 2352.1 | -12.1 | 0.102 | -0.78 | 0.023 | -0.77 |
| 3 | 2426 | 2414.1 | 11.9 | 0.177 | 0.80 | 0.046 | 0.79 |
| 4 | 2293 | 2294.0 | -1.0 | 0.251 | -0.07 | 0.001 | -0.07 |
| 5 | 2330 | 2346.4 | -16.4 | 0.077 | -1.05 | 0.030 | -1.05 |
| 6 | 2368 | 2389.3 | -21.3 | 0.265 | -1.52 | 0.277 | -1.61 |
| 7 | 2250 | 2252.1 | -2.1 | 0.319 | -0.15 | 0.004 | -0.15 |
| 8 | 2409 | 2383.6 | 25.4 | 0.098 | 1.64 | 0.097 | 1.76 |
| 9 | 2364 | 2385.5 | -21.5 | 0.142 | -1.42 | 0.111 | -1.48 |
| 10 | 2379 | 2369.3 | 9.7 | 0.080 | 0.62 | 0.011 | 0.60 |
| 11 | 2440 | 2416.9 | 23.1 | 0.278 | 1.66 | 0.354 | 1.80 |
| 12 | 2364 | 2384.5 | -20.5 | 0.096 | -1.32 | 0.062 | -1.36 |
| 13 | 2404 | 2396.9 | 7.1 | 0.289 | 0.52 | 0.036 | 0.50 |
| 14 | 2317 | 2316.9 | 0.1 | 0.185 | 0.01 | 0.000 | <0.01 |
| 15 | 2309 | 2298.8 | 10.2 | 0.134 | 0.67 | 0.023 | 0.66 |
| 16 | 2328 | 2332.1 | -4.1 | 0.156 | -0.28 | 0.005 | -0.27 |
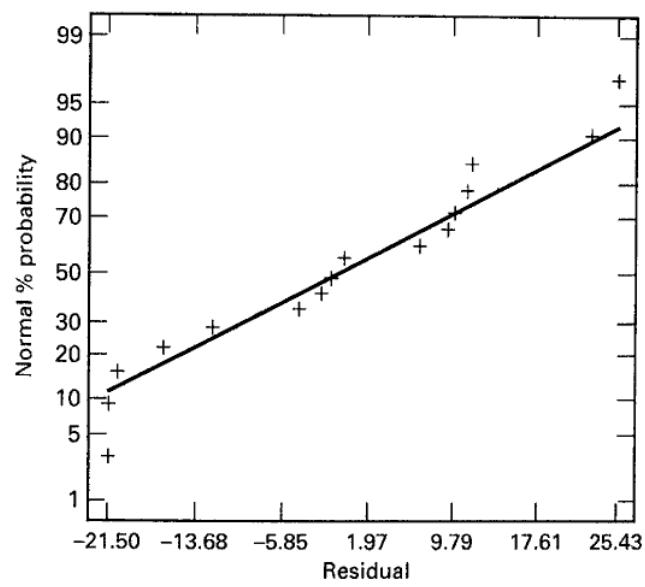
图 10.1 例 10.1 残差的正态概率图
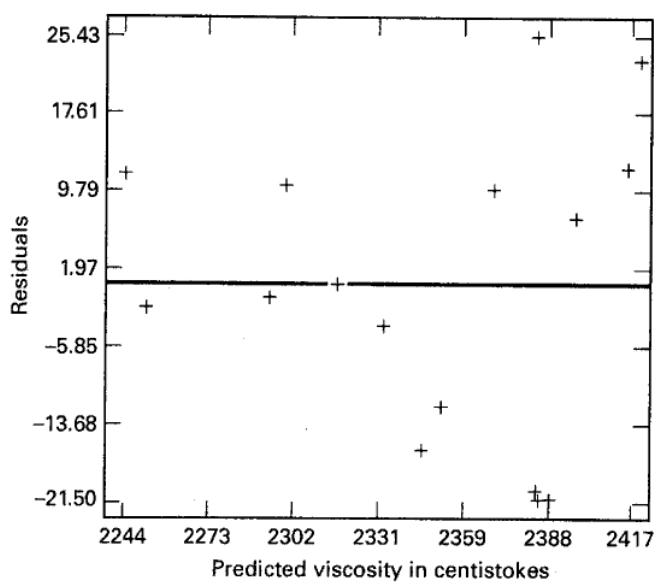
图 10.2 例 10.1 残差与拟合黏度的关系图
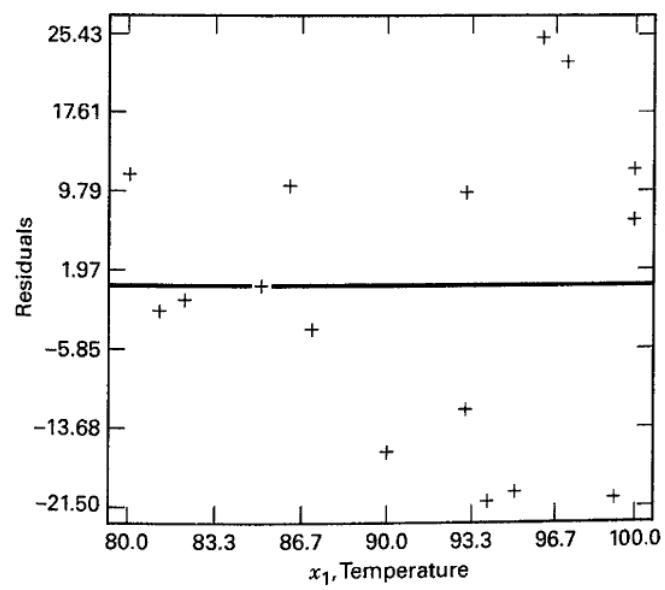
图 10.3 例 10.1 残差与温度 x1 的关系图
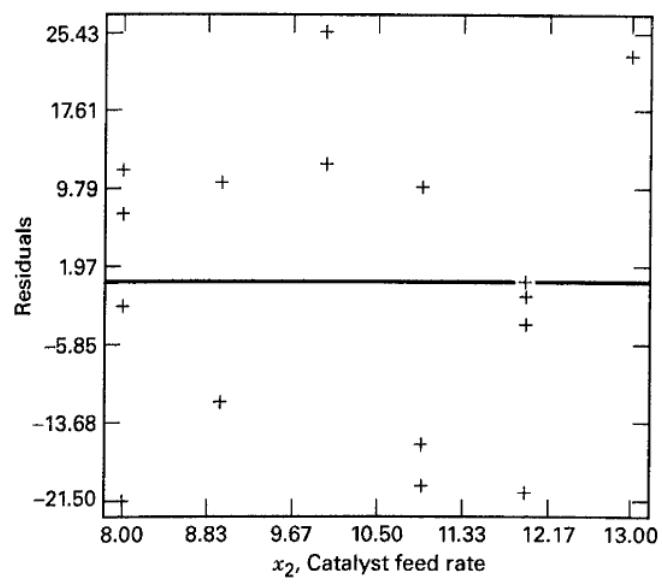
图 10.4 例 10.1 残差与进料速率 x2 的关系图
使用计算机
回归模型几乎总是借助 Minitab、JMP 等统计软件拟合。表 10.4 是例 10.1 的 Minitab 输出摘录。许多项目与前面设计试验的软件输出具有相似含义。本章后续将详细说明其中的方差分析和 t 检验,以及这些数值的计算方法。
表 10.4 例 10.1 黏度回归模型的 Minitab 输出
Regression Analysis
The regression equation is
Viscosity = 1566 + 7.62 Temp + 8.58 Feed Rate
Predictor Coef Std. Dev. T P
Constant 1566.08 61.59 25.43 0.000
Temp 7.6213 0.6184 12.32 0.000
Feed Rat 8.585 2.439 3.52 0.004
S = 16.36 R-Sq = 92.7% R-Sq (adj) = 91.6%
Analysis of Variance
Source DF SS MS F P
Regression 2 44157 22079 82.50 0.000
Residual Error 13 3479 268
Total 15 47636
Source DF Seq SS
Temp 1 40841
Feed Rat 1 3316
设计试验中的回归模型拟合
前面多次用回归模型定量表达设计试验的结果。下面先给出一个完整例子,再通过三个简短例子展示回归分析在设计试验中的其他用途。
例 10.2 用回归分析 23 因子设计
一位化学工程师研究某过程的产率,关注温度、压力和催化剂浓度三个过程变量。每个变量取低、高两个水平,工程师决定进行 23 设计,并增加四个中心点。设计及产率见下表和图 10.5,表中同时给出自然水平与二水平因子设计常用的 ±1 编码。[5]
| 试验序号 | 过程变量 | 编码变量 | 产率, y |
| 温度 (°C) | 压力 (psig) | 浓度 (g/L) | $x_1$ | $x_2$ | $x_3$ |
| 1 | 120 | 40 | 15 | -1 | -1 | -1 | 32 |
| 2 | 160 | 40 | 15 | 1 | -1 | -1 | 46 |
| 3 | 120 | 80 | 15 | -1 | 1 | -1 | 57 |
| 4 | 160 | 80 | 15 | 1 | 1 | -1 | 65 |
| 5 | 120 | 40 | 30 | -1 | -1 | 1 | 36 |
| 6 | 160 | 40 | 30 | 1 | -1 | 1 | 48 |
| 7 | 120 | 80 | 30 | -1 | 1 | 1 | 57 |
| 8 | 160 | 80 | 30 | 1 | 1 | 1 | 68 |
| 9 | 140 | 60 | 22.5 | 0 | 0 | 0 | 50 |
| 10 | 140 | 60 | 22.5 | 0 | 0 | 0 | 44 |
| 11 | 140 | 60 | 22.5 | 0 | 0 | 0 | 53 |
| 12 | 140 | 60 | 22.5 | 0 | 0 | 0 | 56 |
| $x_1 = \frac{\text{Temp} - 140}{20}, x_2 = \frac{\text{Pressure} - 60}{20}, x_3 = \frac{\text{Conc} - 22.5}{7.5}$ |
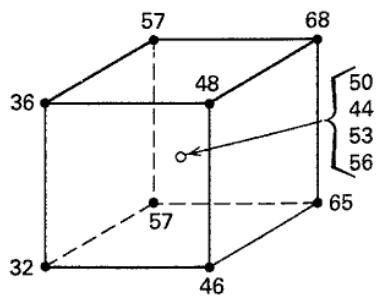
图 10.5 例 10.2 的试验设计
设拟合仅含主效应的模型
y=β0+β1x1+β2x2+β3x3+ϵ. 表中的 12 次试验给出设计矩阵 X:前八行的第一列全为 1,后三列按因子水平取 ±1;后四行是 [1,0,0,0]。由于 23 设计是正交的,加入中心点后仍保持正交,因此
X′X=diag(12,8,8,8),X′y=⎣⎡61245859⎦⎤. 逆矩阵也是对角的,故
β^=(X′X)−1X′y=⎣⎡51.0005.62510.6251.125⎦⎤, 拟合模型为
y^=51.000+5.625x1+10.625x2+1.125x3. 回归系数与通常的 23 设计效应估计密切相关。例如,由图 10.5 可算出温度效应
T=yˉT+−yˉT−=56.75−45.50=11.25. x1 的回归系数正好是效应估计的一半,即 11.25/2=5.625。对编码为 ±1 的正交 2k 设计,这一关系普遍成立。前面第 6 至 8 章已用它得到多个二水平试验的回归模型、拟合值和残差;此例表明这些效应估计可视为最小二乘估计。
由 (X′X)−1 的对角元素可得
V(β^0)=12σ2,V(β^i)=8σ2,i=1,2,3. 相应的相对方差分别为 1/12 与 1/8。
例 10.2 中,X′X 是对角矩阵,所以容易求逆。这种设计的优点不仅是计算简单,还在于不同回归系数的估计量互不相关,即 Cov(β^i,β^j)=0(i=j)。如果能在收集数据前选择各 x 变量的水平,就可以有意识地安排试验,使 X′X 成为对角矩阵。
这在实践中往往不难做到。X′X 的非对角元素是 X 各列的交叉乘积和,因此只需使不同列的内积为零,也就是使这些列相互正交。对于拟合给定回归模型具有这一性质的试验设计,称为正交设计。一般而言,2k 因子设计对于拟合相应的多元线性回归模型是正交设计。
当设计试验出现意外情况时,回归方法尤其有用。例 10.3 和例 10.4 将分别说明缺失观测与因子实际水平不准确时的处理方法。
例 10.3 有一个观测值缺失的 23 因子设计
仍考虑例 10.2 中含四个中心点的 23 设计。假设所有变量均取高水平的第 8 次试验观测值缺失。原因可能是测量系统读数错误、某个因子水平组合无法实现,或试验单元受损等。用剩余 11 个观测拟合相同的仅含主效应模型:
y=β0+β1x1+β2x2+β3x3+ϵ. 设计矩阵就是例 10.2 的 X 删除第 8 行,响应向量也删去第 8 个观测。此时
X′X=⎣⎡11−1−1−1−17−1−1−1−17−1−1−1−17⎦⎤,X′y=⎣⎡544−2317−59⎦⎤. 缺失观测使设计不再正交。其逆矩阵为
(X′X)−1=1041⎣⎡10222216332316323316⎦⎤. 按式(10.13)计算,得到[6]
β^≈⎣⎡51.057695.7115410.711541.21154⎦⎤,y^=51.05769+5.71154x1+10.71154x2+1.21154x3. 与使用全部 12 个观测的例 10.2 相比,回归系数很接近,因此对因子效应的实际结论不会受到严重影响。不过,X′X 及其逆矩阵不再是对角的,效应估计失去正交性,各回归系数的方差也比完整正交设计中更大。
例 10.4 设计因子的实际水平不准确
实施设计试验时,有时难以精确达到并保持规定的因子水平。小偏差通常无关紧要,大偏差则可能造成问题。当实际水平偏离设计值时,回归方法可用于分析所得数据。
表 10.5 给出例 10.2 中 23 设计的一个变形:许多实际因子水平与原设计不完全一致,其中温度最难控制。仍拟合仅含主效应的模型
y=β0+β1x1+β2x2+β3x3+ϵ. 表 10.5 例 10.4 的试验设计[7]
| 试验序号 | 过程变量 | 编码变量 | 产率 y |
| 温度 (°C) | 压力 (psig) | 浓度 (g/L) | $x_1$ | $x_2$ | $x_3$ |
| 1 | 125 | 41 | 14 | -0.75 | -0.95 | -1.133 | 32 |
| 2 | 158 | 40 | 15 | 0.90 | -1 | -1 | 46 |
| 3 | 121 | 82 | 15 | -0.95 | 1.1 | -1 | 57 |
| 4 | 160 | 80 | 15 | 1 | 1 | -1 | 65 |
| 5 | 118 | 39 | 33 | -1.10 | -1.05 | 1.4 | 36 |
| 6 | 163 | 40 | 30 | 1.15 | -1 | 1 | 48 |
| 7 | 122 | 80 | 30 | -0.90 | 1 | 1 | 57 |
| 8 | 165 | 83 | 30 | 1.25 | 1.15 | 1 | 68 |
| 9 | 140 | 60 | 22.5 | 0 | 0 | 0 | 50 |
| 10 | 140 | 60 | 22.5 | 0 | 0 | 0 | 44 |
| 11 | 140 | 60 | 22.5 | 0 | 0 | 0 | 53 |
| 12 | 140 | 60 | 22.5 | 0 | 0 | 0 | 56 |
用实际编码水平建立 X,并沿用表中产率 y,得到
X′X≈⎣⎡120.600.250.26700.608.180.31−0.14030.250.318.5375−0.34370.2670−0.1403−0.34379.2437⎦⎤,X′y=⎣⎡61277.55100.719.144⎦⎤. 由式(10.13)得到
β^≈⎣⎡50.493915.4099610.163161.07245⎦⎤, 所以系数保留两位小数的拟合式为[8]
y^=50.49+5.41x1+10.16x2+1.07x3. 与例 10.2 各因子水平恰好达到设计值时的模型相比,差别很小。未能精确达到目标水平,看来不会严重改变试验结果的实际解释。
例 10.5 分式因子设计中交互作用别名的分离
第 8 章指出,可通过折叠(fold over)分离分式因子设计中互为别名的交互作用。对分辨度 III 的设计,完整折叠需要再实施一个所有符号都与原分式相反的分式;合并后便能分离全部主效应与两因子交互作用。
完整折叠的困难在于新增试验与原设计一样多。通常只需增补更少的试验,就能分离某些特别关心的交互作用。部分折叠即为此而用。回归方法有助于理解部分折叠为何有效,有时还可找到试验次数更少的增广方案。
设已实施一个 2IV4−1 设计。表 8.3 给出定义关系 I=ABCD 的主分式。前八次试验后,假设较大的效应为 A、B、C、D(这里忽略与主效应互为别名的三因子交互作用)以及别名链 AB+CD。其他两条别名链可以忽略,但 AB、CD 或二者中至少一个显然较大。若实施另一个分式,需要再做八次试验,之后可用全部 16 次试验估计主效应和两因子交互作用。另一种方案是只增加四次试验的部分折叠。
实际上,若只需分离 AB 与 CD,新增次数甚至可少于四次。考虑拟合
y=β0+β1x1+β2x2+β3x3+β4x4+β12x1x2+β34x3x4+ϵ, 其中 x1,…,x4 分别是 A、B、C、D 的编码变量。表 8.3 的八次试验构成的设计矩阵各行如下:
| 试验 | 截距 | x1 | x2 | x3 | x4 | x1x2 | x3x4 |
|---|
| 1 | 1 | −1 | −1 | −1 | −1 | 1 | 1 |
| 2 | 1 | 1 | −1 | −1 | 1 | −1 | −1 |
| 3 | 1 | −1 | 1 | −1 | 1 | −1 | −1 |
| 4 | 1 | 1 | 1 | −1 | −1 | 1 | 1 |
| 5 | 1 | −1 | −1 | 1 | 1 | 1 | 1 |
| 6 | 1 | 1 | −1 | 1 | −1 | −1 | −1 |
| 7 | 1 | −1 | 1 | 1 | −1 | −1 | −1 |
| 8 | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
x1x2 列与 x3x4 列完全相同,正是 AB 与 CD 互为别名的表现。设计矩阵的列因而线性相关,无法同时估计 β12 与 β34。现在从另一分式增加一次试验,取 (x1,x2,x3,x4)=(−1,−1,−1,1)。其设计矩阵新行是
[1,−1,−1,−1,1,1,−1]. 两条交互作用列不再相同,便可在模型中同时拟合 AB 与 CD;所得回归系数大小有助于判断哪个交互作用重要。
不过,只增加一次试验也有缺点。假如前八次与新增试验之间存在时间效应或区组效应,可在设计矩阵中增加一列区组指示:前八行取 -1,第九行取 +1。该列与各处理效应列的交叉乘积不为零,因而区组与处理不正交;实际上,区组列等于 x1x2−x3x4−1,加入区组效应后无法同时分离它与 AB、CD。要实现区组与处理效应正交,新增试验须使各处理效应列与区组列的交叉乘积为零;新增次数须为偶数。[9]以下四个试验既可分离 AB 与 CD,也允许正交区组安排:
| $x_{1}$ | $x_{2}$ | $x_{3}$ | $x_{4}$ |
| -1 | -1 | -1 | 1 |
| 1 | -1 | -1 | -1 |
| -1 | 1 | 1 | 1 |
| 1 | 1 | 1 | -1 |
把这四行加入前述设计矩阵即可验证:新试验中四个主效应列及 AB、CD 两列的元素和均为零,因此区组与这些处理效应正交。两区组大小分别为 8 和 4,若还要使区组列与截距列正交,可以把区组编码改为前八行取 -1、后四行取 +2。就新增次数而言,这与部分折叠相同。
一般来说,检查分式因子设计中目标模型的设计矩阵,就能判断应增加哪些试验,以分离感兴趣的交互作用。后续给出的回归模型一般结果还能用于评价具体增广策略。计算机最优设计方法也可帮助构造用于分离效应的增广设计,参见第 8 章补充材料。